
検索せず、コンパイルする
2026年4月、Andrej Karpathyは、自身がLLM wikiと呼ぶものについての短い「アイデアファイル」を公開しました。ai-memoryはそのアイデアを、絶え間なく素材を生み出すコーディングエージェント向けに作り替えたものです。
「知識は一度コンパイルされ、その後は最新に保たれる。クエリのたびに導出し直されるのではない。」
3つの層
決して変わらない生のソース、LLMがメンテナンスするmarkdownページのwiki、そしてwikiの仕組みをエージェントに伝えるスキーマファイルです。
3つの操作
ソースを取り込み、関係するページを更新する。wikiに問い合わせる。矛盾や孤立ページがないかlintする。
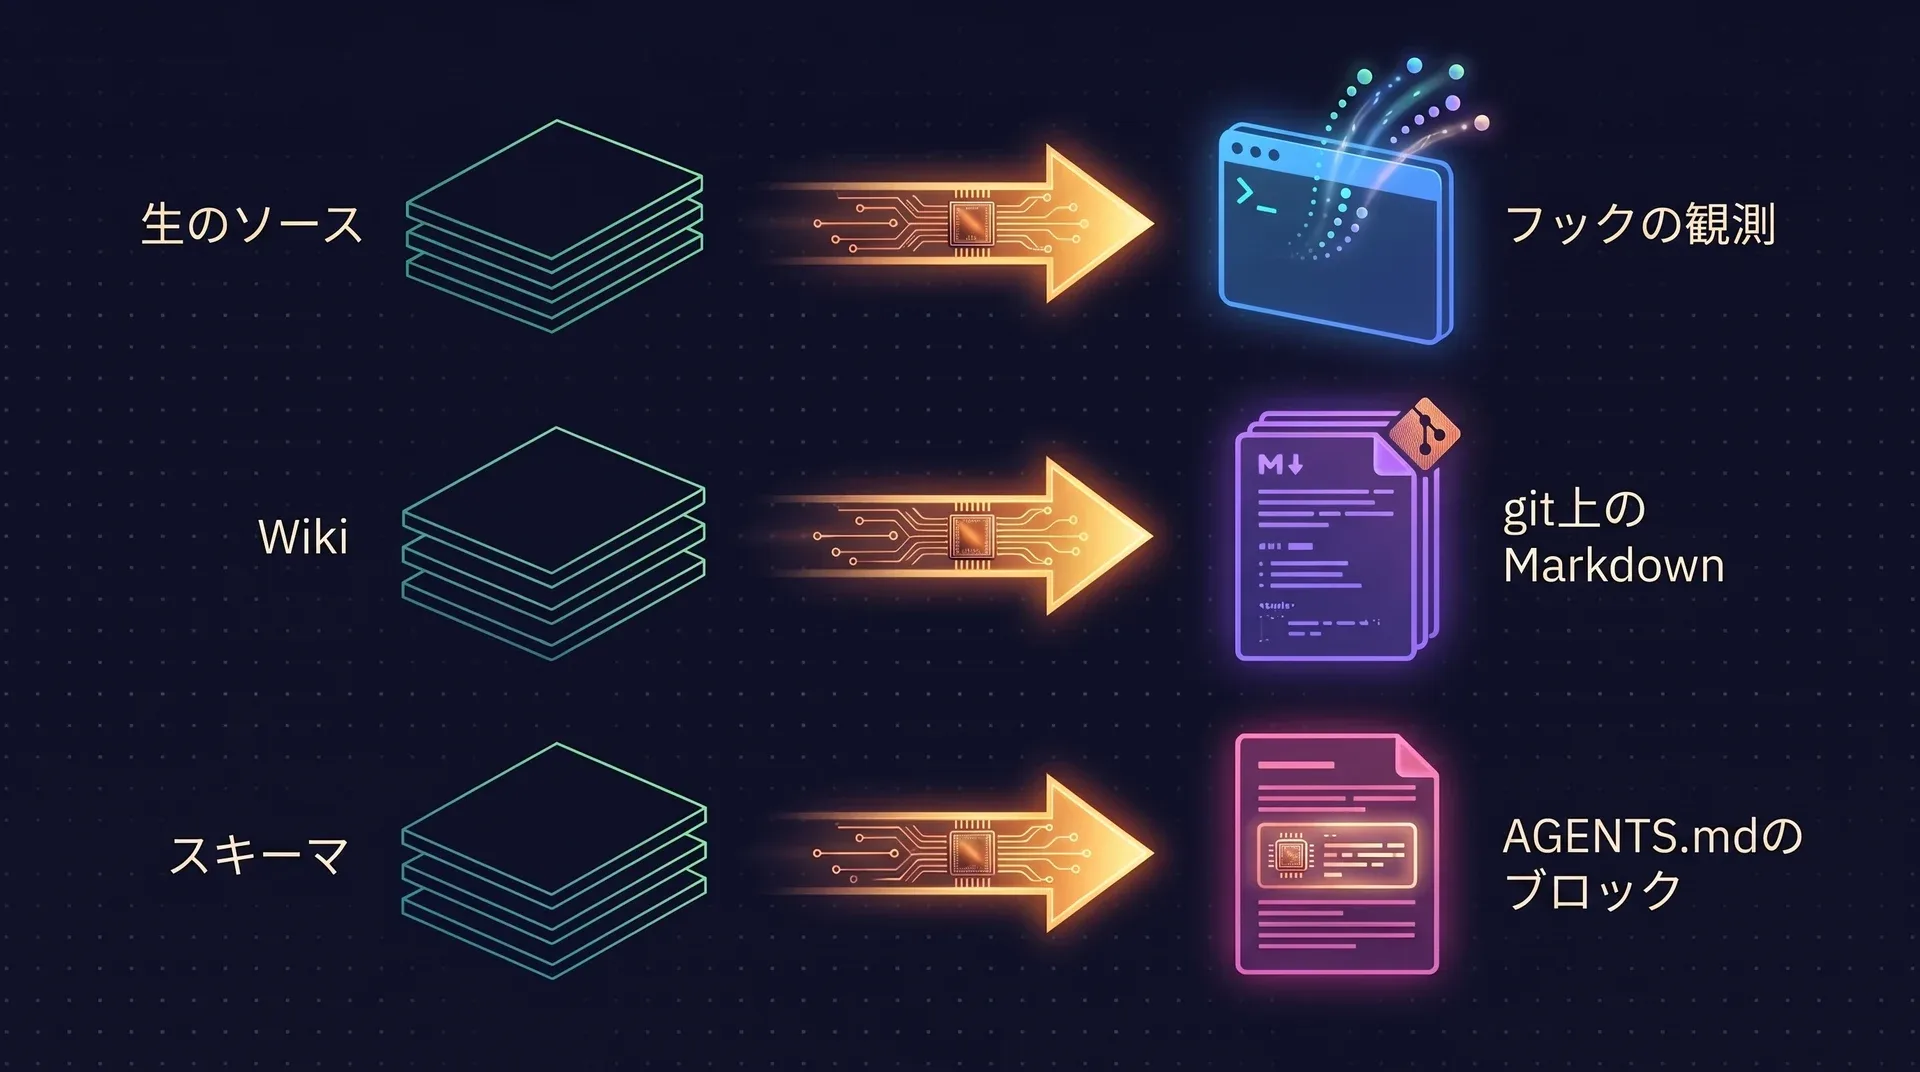
ai-memoryが受け継いだもの
- 人が開いて、diffを取り、読めるものとして、gitリポジトリ内のmarkdownファイルを使うこと。
- 知識は届いた時点でコンパイルすること。1つのセッションが複数のページに展開されます。
- ページ間のwikilinkをグラフとして使うこと。
- 矛盾、古くなったページ、孤立ページ、重複タイトルを見つけるlint。
- エージェントにwikiの使い方を伝えるため、CLAUDE.mdかAGENTS.mdにスキーマブロックをインストールすること。
変えたもの
Karpathyのパターンでは、人がソースを1つずつ選んで整理します。コーディングエージェントは素材を生み出し続け、それを見ている人はいません。
| gistでは | ai-memoryでは |
|---|---|
| LLMにソースを1つずつ手渡す | ライフサイクルフックがすべてのセッションを自動でキャプチャ |
| エージェントはまずindex.mdを読む | 全文、エンティティ、リンク、ベクトルを融合した1つのインデックス |
| メンテナンスはすべてLLMが行う | デフォルトはルールベースの要約。LLMはオプトイン |
| 1人に1つのwiki | エージェント間の引き継ぎ、複数ユーザー、プロジェクト単位のスコープ |
| ページは永久に残る | 階層、減衰、置き換え、TTLで古いページを結果から外す |
階層、減衰、置き換えはKarpathyのgistにはありません。出どころはagentmemoryと、その周辺で書かれた「LLM Wiki v2」の文章です。読書メモの全文はリポジトリにあります。
あなたの記憶は、すでにオープンなフォーマット
Open Knowledge Formatは、Google Cloudが2026年6月に公開した仕様です。知識を、YAMLフロントマター付きのmarkdownファイルを並べたプレーンなディレクトリとして記述します。1ファイルに1概念で、必須フィールドはtypeだけです。SDKもランタイムもありません。
- 2.0以降、wikiはそのままOKF v0.2のバンドルです。ai-memoryが扱うファイルがOKFのファイルそのものなので、エクスポート結果が正とずれることはありません。
- 1つのプロジェクトが1つのバンドルで、ルートには生成された
index.mdがあります。 - すべてのページにYAMLフロントマターがあり、
typeは置かれているフォルダから決まります。 - 1.xからのアップグレードでは、検証済みのバックアップを取ったあと、フロントマターをその場で書き換えます。バックアップに失敗すると、マイグレーションは止まります。
ai-memory export-okf --project myproject -o myproject-bundle.tar.gz
インポートコマンドはありません。バンドルをプロジェクトのwikiディレクトリに展開すれば、ファイルウォッチャーがインデックスします。OKFとの対応はフィールド単位でドキュメント化されており、仕様はGoogle Cloudのknowledge-catalogリポジトリにあります。
| フォルダ | OKFのtype |
|---|---|
sessions/ | Session Summary |
decisions/ | Decision |
gotchas/ | Gotcha |
procedures/ | Procedure |
concepts/ | Concept |
_rules/ | Rule |
notes/ | Note |
runbooks/ | Runbook |
_slots/ | InvariantまたはState |
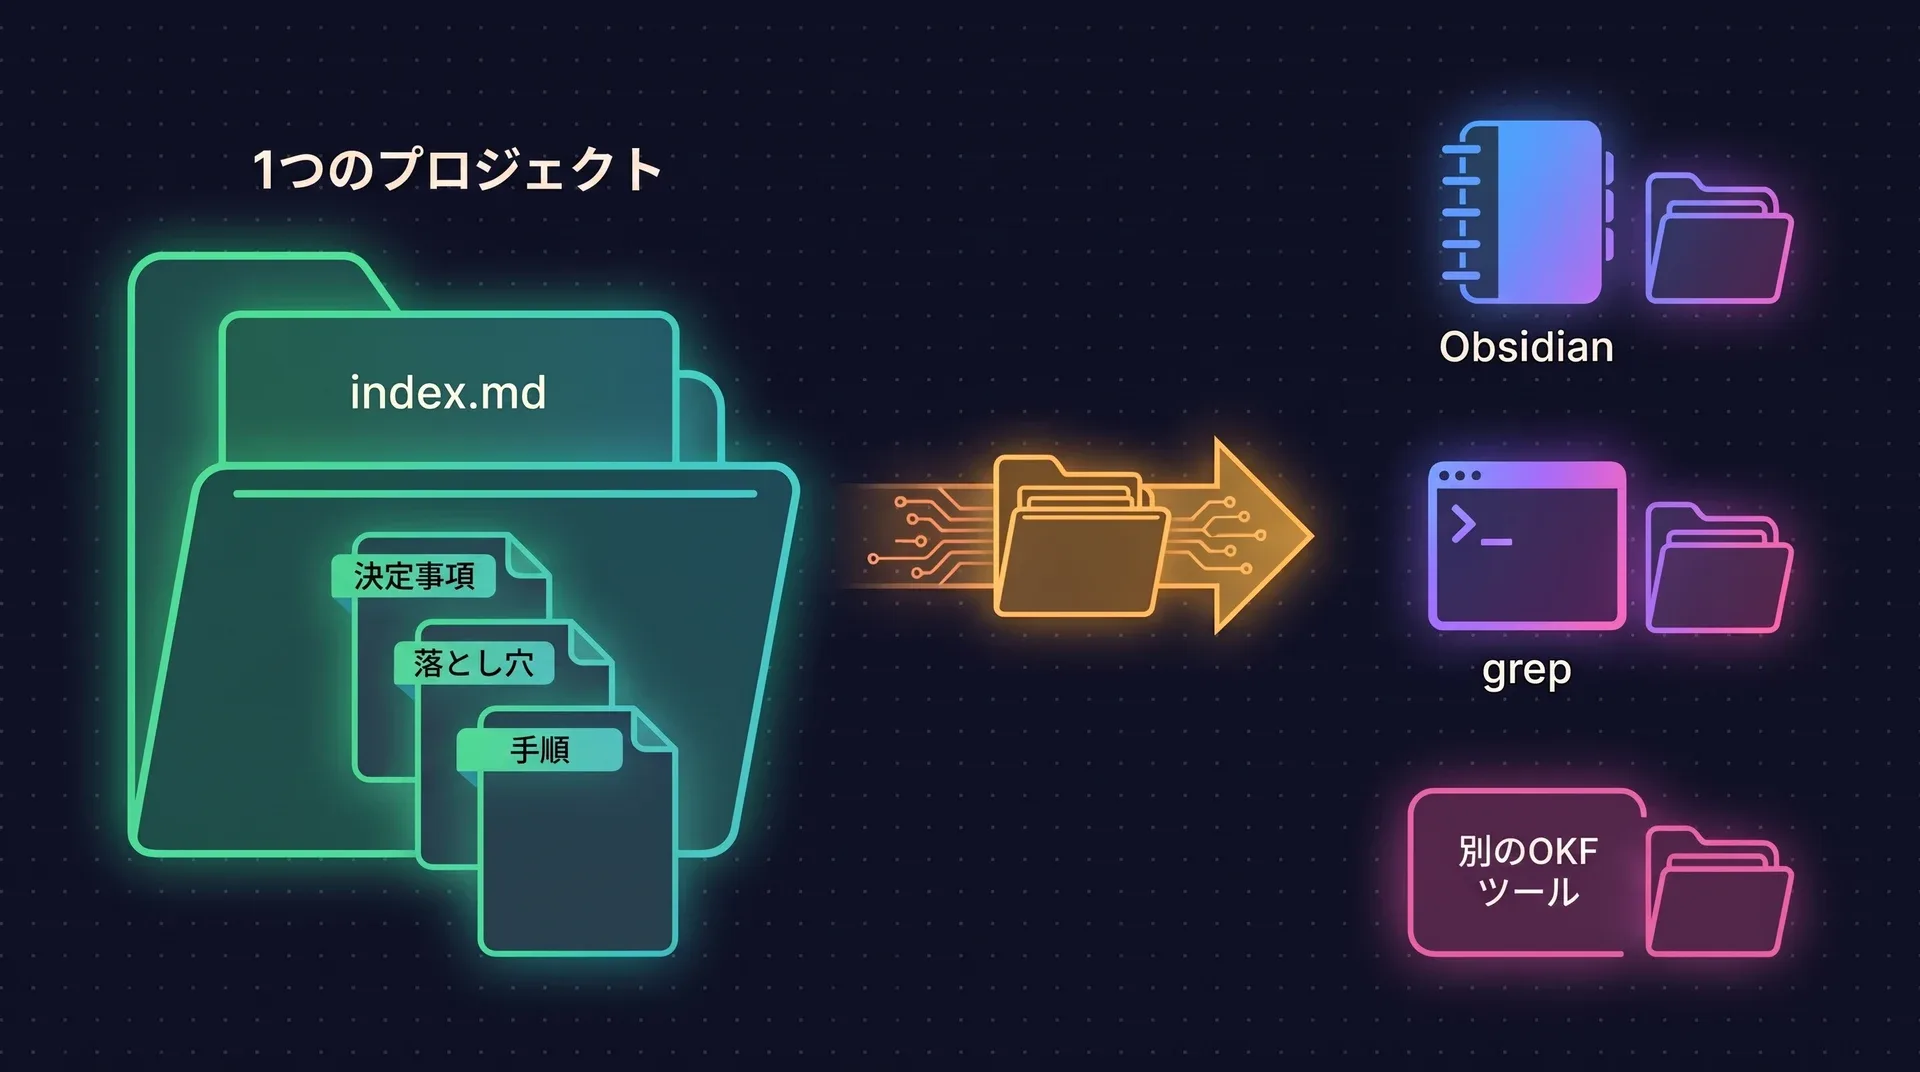
「モデルもハーネスも借り物だ。プロジェクトの記憶はあなたのものだ。」
8つの決定と、それぞれの理由
その多くは、先行する記憶ツールの具体的なIssueにさかのぼります。
選んだもの
gitで管理するmarkdownを正とする
理由: バックアップも移行も、git cloneかrsyncで済みます。データベースはファイルから再構築できるので破損しても復旧でき、markdownを読めるツールなら何でもあなたの記憶を読めます。
選んだもの
SQLiteファイル1つ
理由: 全文、パックしたベクトル、リンクテーブルが、1つの組み込みファイルに収まります。3つのストアを同期させると正しさのバグがどれだけ出るかは、ほかのプロジェクトのIssueトラッカーが示していました。
選んだもの
デフォルトでLLM呼び出しゼロ
理由: セッションの要約はルールベースなので、インストール直後は費用が一切かかりません。ほかのツールで、デフォルトで有効なLLM機能のトークン請求にユーザーが驚かされた例からの教訓です。
選んだもの
単一バイナリ
理由: SQLiteは同梱、libgit2はベンダリング、埋め込み処理はピュアRustです。このプロジェクトの前身では、別プロセスのサイドカーエンジンがユーザーの苦労の最大の原因でした。
選んだもの
グラフデータベースは使わない
理由: グラフの実体はSQLのテーブルで、linksテーブルと再帰クエリです。これで1ホップの展開と型付きエッジをまかなえ、組み込みのグラフエンジンを動かし続ける必要がありません。
選んだもの
ベクトルは任意
理由: ローカルの埋め込みは2.0からデフォルトで有効ですが、今も必須ではありません。検索はSQLite内でのコサイン類似度の総当たりです。ベクトル拡張の導入は、ページ数かレイテンシが必要とするまで見送ります。
選んだもの
引き継ぎは、型付きで一度しか受け取れないプロトコル
理由: どの調査でも、エージェント間の受け渡しが先行ツールの弱点として挙がりました。引き継ぎはディレクトリで照合される型付きのレコードで、受理できるのはちょうど1つのセッションだけです。
選んだもの
ファクトの行よりページ
理由: ある決定についてのページは、文章として読み、編集し、説明できます。抽出したファクトのテーブルは、Obsidianで開くことも、diffでレビューすることもできません。
先人の肩の上に立つ
このプロジェクトは、先行ツールのコードとIssueトラッカーを読み込み、持ちこたえたアイデアを残し、壊れ続けていた部分を外しました。
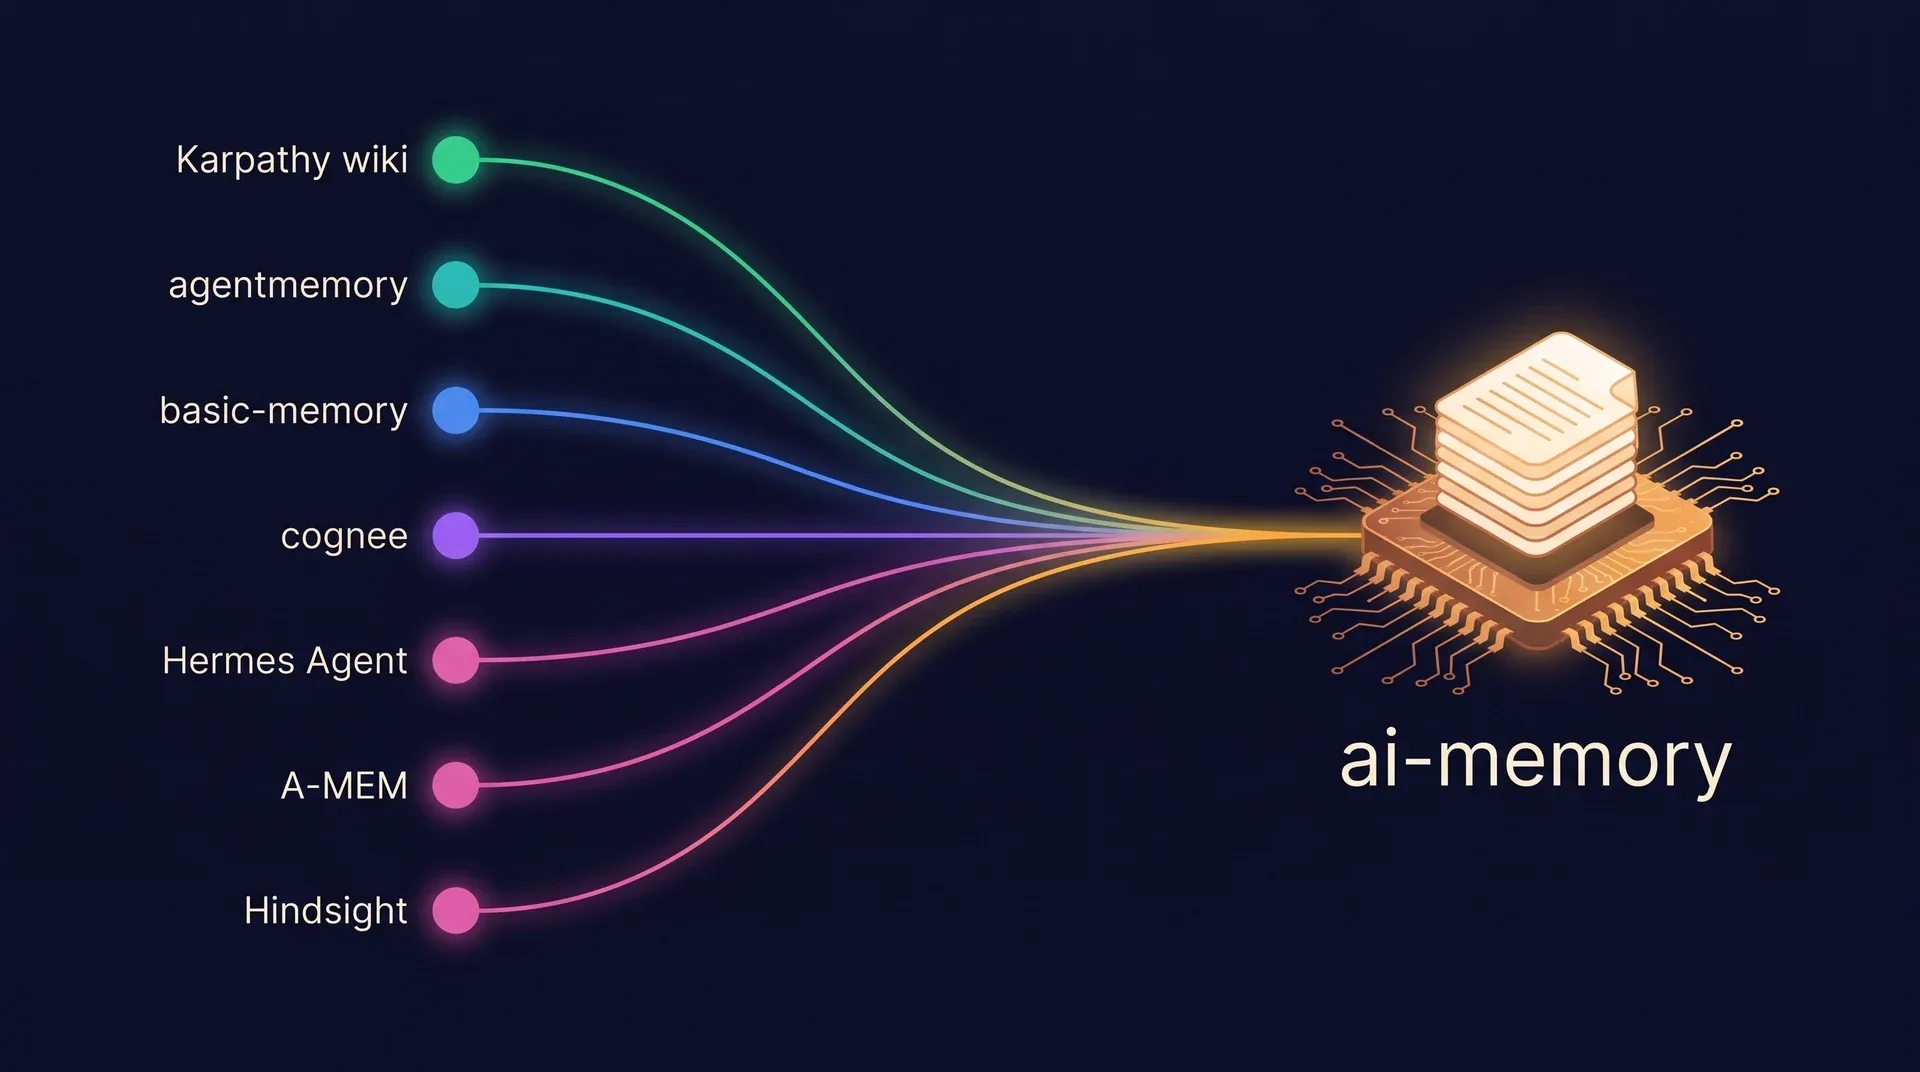
- Karpathy LLM Wiki
- 検索せず、コンパイルする。ディスク上のwikiが成果物です。
- agentmemory
- フックによる自動キャプチャ、記憶の階層、置き換え、数式としての減衰、融合ランキング。ai-memoryはそのRust製の後継で、アイデアは残し、土台を入れ替えました。
- basic-memory
- ファイルを信頼できる唯一の情報源とし、インデックスは派生とすること。まだ存在しないページへの前方リンク。
- cognee
- タスクパイプラインの形、すべてのページに付く来歴スタンプ、ランキングを調整するフィードバック。
- Hermes Agent
- 完了したセッションをバックグラウンドで見直す、自己改善ループの設計。
- A-MEM
- 互いに自動でリンクし合う、Zettelkasten式のアトミックなノート。
- Hindsight
- 型付きの墨消しラベル、ページごとのエビデンス数、確定したルールを先頭に出すブリーフィング。
- Honcho
- 引用付きの回答、推論レベル、夢見パスのスケジューリング。アイドルで起動し、操作があれば中止し、新規性の高いものから処理します。
これらのプロジェクトはいずれも、ai-memoryを推奨しているわけではありません。それぞれがどこで先を行っているかは、比較ページをご覧ください。
計測したこと
検索スタックはLongMemEval-Sで採点しています。長いチャット履歴についての470問を、実際のフック経路と実際の検索に通します。評価ハーネスはリポジトリにあります。
- 全文検索のみ(2.0より前)0.617
- ストップワードを除外した全文検索0.666
- ローカル埋め込みを追加(デフォルト)0.815
各ステップでしたこと
- 全文検索のクエリからストップワードを落とすと、hit@5が5.1ポイント、hit@1が8.5ポイント上がりました。
- 残りはプロセス内の埋め込みモデルによる上積みです。マスク付き平均プーリングを正しく実装しただけで、約6.6ポイントの効果がありました。
- どの行でも、APIキーもLLMも使っていません。
| 指標 | 2.0より前 | 除外ありの全文検索 | ローカル埋め込み |
|---|---|---|---|
| hit@1 | 0.449 | 0.532 | 0.536 |
| hit@5 | 0.617 | 0.666 | 0.815 |
| recall@5 | 0.472 | 0.536 | 0.677 |
自分で実行する
2つ目のコマンドに--candidate-embeddings localを追加すると、全文検索とローカル埋め込みを並べて実行できます。公開している結果は2026年9月21日にRyzen 9 7950X3Dで実行したものです。
cargo build --release -p ai-memory-cli
cargo run --release -p ai-memory-eval -- retrieval --fetch
書き込みスループットも測定しています。数値はアーキテクチャのページにあります。
ローカル埋め込みで得られるものと、そのコスト
同じ470問を2回実行しました。1回目は全文検索のみ、2回目はデフォルトのローカル埋め込みモデルを使っています。埋め込みを使うと、根拠が上位10件に入る割合が大きく上がり、クエリ1回あたり約90 ms増えます。
| 指標 | 全文検索、LLMなし | ローカル埋め込み | 変化 |
|---|---|---|---|
| hit@1 | 0.532 | 0.536 | +0.004 |
| hit@5 | 0.666 | 0.815 | +0.149 |
| hit@10 | 0.694 | 0.891 | +0.198 |
| recall@10 | 0.564 | 0.817 | +0.254 |
| クエリ時間、中央値 | 5 ms | 94 ms | +89 ms |
| クエリ時間、95パーセンタイル | 40 ms | 162 ms | +122 ms |
| クエリあたりのコンテキストトークン数、平均 | 350.3 | 415.7 | +65.4 |
- 同じコミットでフル計測を2回実行したところ、0.815と0.821でした。hit@5は約0.82、誤差は0.005程度と読んでください。2026年9月1日の前回の計測は0.823で、同じ結果です。記憶のエイジングはデフォルトでオフなので、デフォルトの検索は変わっていません。
- 1回の計測の中では、ハーネスは決定的に動きます。同じ構成を2回実行すると、正確さもトークン数も完全に一致します。別々の計測の間では、問題数の少ない質問タイプが上下どちらにも最大0.03動きます。そのため、1回の計測でそのうちの1つが下がっていても、ほとんど意味はありません。
これからの予定と、遅れているところ
いずれも、リポジトリに文書化されている推奨事項です。どれにも期日はありません。
次に推奨されているもの
全規模での回答の正確さ
2つ目のハーネスでは、検索の全データ実行が済んでいて、正確さ、クエリ時間、コンテキストのトークン数を計測しています。回答の正確さを測るモードはまだ20問のサンプルしかなく、以下の項目はその結果待ちです。
ローカルのリランカー
LLMなしでプロセス内で動くクロスエンコーダーです。効果の検証には、上のハーネスが必要です。
数値に裏付けられたデフォルト
信頼度スコアとエイジング機能は、オフの状態でリリースしています。ハーネスで効果が示されたものだけがデフォルトになります。リンクの種類は、今もランキング上の重みを持ちません。
範囲を限ったsyncコマンド
サーバー1台のモデルをもっと平易に説明するか、gitのwikiを土台にしたai-memory syncを作るかのどちらかです。
Claude Codeユーザーが始めやすくする
Claude Code組み込みのメモリから移ってくる人向けのインポーターです。
予定していないもの: グラフデータベース、自己編集するメモリOS、クラウドコネクター、数を増やすこと自体が目的のツール追加。
現時点で遅れているところ
素の検索スコアはリランクを行うツールを下回り、記憶のエイジングにはまだ測定結果がありません。全項目は比較ページにあります。
「1.xはアイデアが機能することを証明した。2.0は、誰かがチームに導入するときに、注釈なしで勧められるバージョンだ。」
よくある質問
ai-memoryの背景にあるKarpathyのLLM Wikiとは何ですか?
Andrej Karpathyが2026年4月に公開したgistは、あなたと生のソースの間で、LLMがmarkdownファイルの永続的なwikiを構築してメンテナンスする仕組みを説明しています。知識は一度コンパイルされ、最新に保たれます。ai-memoryはこれをコーディングエージェントに適用したもので、ライフサイクルフックから自動でキャプチャし、デフォルトの経路ではLLMを呼び出しません。
ai-memoryはOpen Knowledge Formatと互換性がありますか?
2.0以降、wiki内のすべてのプロジェクトがそのままOKF v0.2のバンドルです。各ページにはtypeを含むYAMLフロントマターがあり、各プロジェクトには生成されたindex.mdがあります。ai-memory export-okfを使うと、プロジェクトを検証済みのtarballにまとめられます。
LongMemEval-Sベンチマークは、ai-memoryの何を測っていますか?
検索だけです。470問について、根拠を含むセッションが上位の結果に入るかどうかを測ります。hit@5は、デフォルトのローカル埋め込みありで0.815、全文検索のみで0.666です。回答の正確さは測っていません。