
המוצר
מחקר ונימוקים
לכל חלק ב-ai-memory יש סיבה שאפשר לבדוק: רעיון שממנו הוא הגיע, באג בכלי קודם שהוא נמנע ממנו, או מספר שמולו הוא נמדד. הדף הזה עובר עליהם בשישה פרקים קצרים.
לקמפל, לא לאחזר
באפריל 2026 פרסם Andrej Karpathy "קובץ רעיון" קצר על מה שהוא כינה LLM wiki. ai-memory הוא הרעיון הזה, מותאם לסוכני קוד שלא מפסיקים לייצר חומר.
"הידע מקומפל פעם אחת ואז נשמר מעודכן, במקום להיגזר מחדש בכל שאילתה."
שלוש שכבות
מקורות גולמיים שלא משתנים אף פעם, ויקי של דפי markdown שה-LLM מתחזק, וקובץ סכמה שמסביר לסוכן איך הוויקי עובד.
שלוש פעולות
הזנה של מקור, עם עדכון הדפים שהוא נוגע בהם. שאילתה מול הוויקי. lint שמחפש סתירות ודפים יתומים.
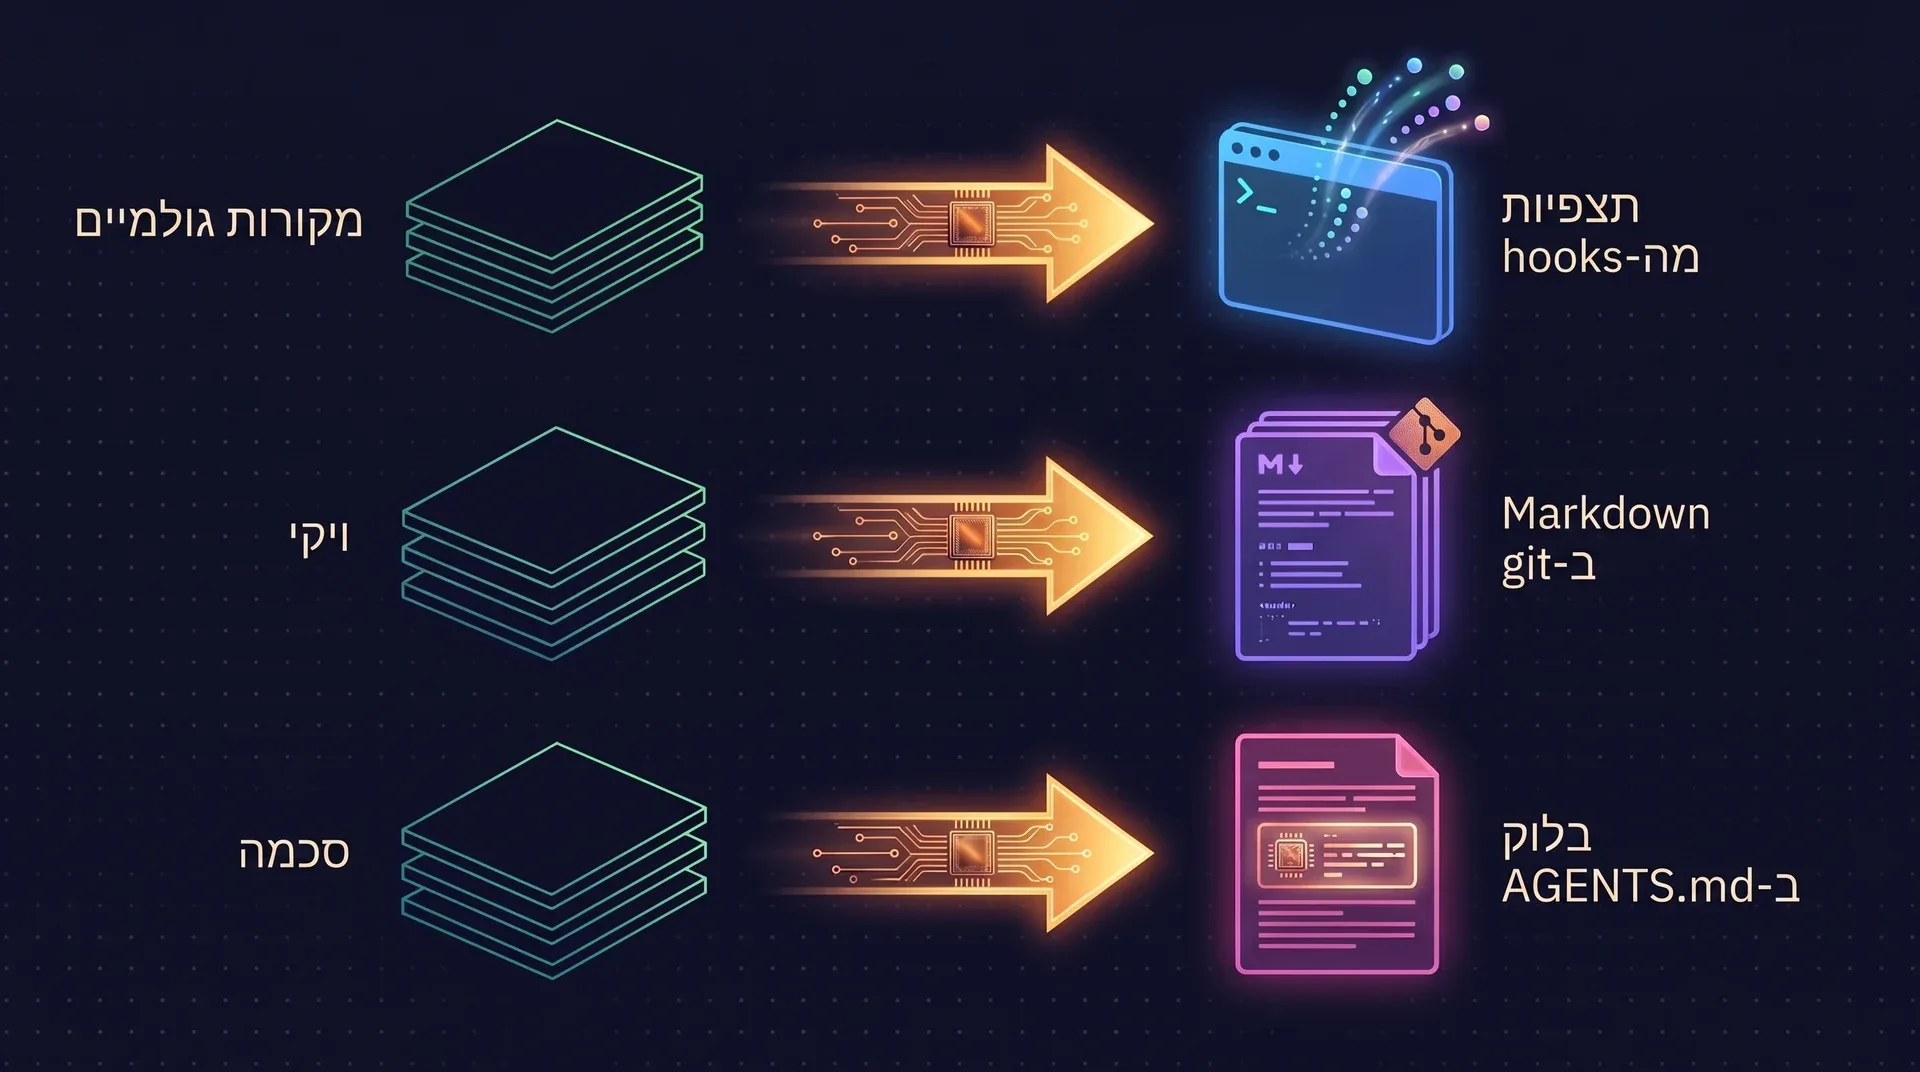
מה ai-memory שמר
- קובצי markdown ב-repository של git, בתור הדבר שאדם יכול לפתוח, לעשות לו diff ולקרוא.
- קומפילציה של הידע ברגע שהוא מגיע, כשסשן אחד מתפצל לכמה דפים.
- wikilinks בין דפים בתור הגרף.
- lint לסתירות, לדפים מיושנים, לדפים יתומים ולכותרות כפולות.
- בלוק סכמה שמותקן בתוך CLAUDE.md או AGENTS.md, כדי שהסוכן יידע איך להשתמש בוויקי.
מה הוא שינה
את הדפוס של Karpathy אוצר אדם, מקור אחד בכל פעם. סוכן קוד מייצר חומר ברצף, ואף אחד לא משגיח.
| ב-gist | ב-ai-memory |
|---|---|
| מוסרים ל-LLM מקור אחד בכל פעם | hooks של מחזור החיים לוכדים כל סשן בעצמם |
| הסוכן קורא קודם את index.md | אינדקס משולב אחד: טקסט מלא, ישויות, קישורים ווקטורים |
| LLM עושה את כל התחזוקה | סיכומים מבוססי כללים כברירת מחדל. LLM הוא opt-in |
| אדם אחד, ויקי אחד | העברות בין סוכנים, כמה משתמשים, scope לכל פרויקט |
| דפים חיים לנצח | שכבות זיכרון, דעיכה, החלפת עובדות ישנות ו-TTL משאירים דפים מיושנים בחוץ |
שכבות זיכרון, דעיכה והחלפת עובדות ישנות לא מופיעות ב-gist של Karpathy. הן מגיעות מ-agentmemory ומהכתיבה על "LLM Wiki v2" שסביבו. סיכומי הקריאה המלאים נמצאים ב-repository.
הזיכרון שלכם כבר בפורמט פתוח
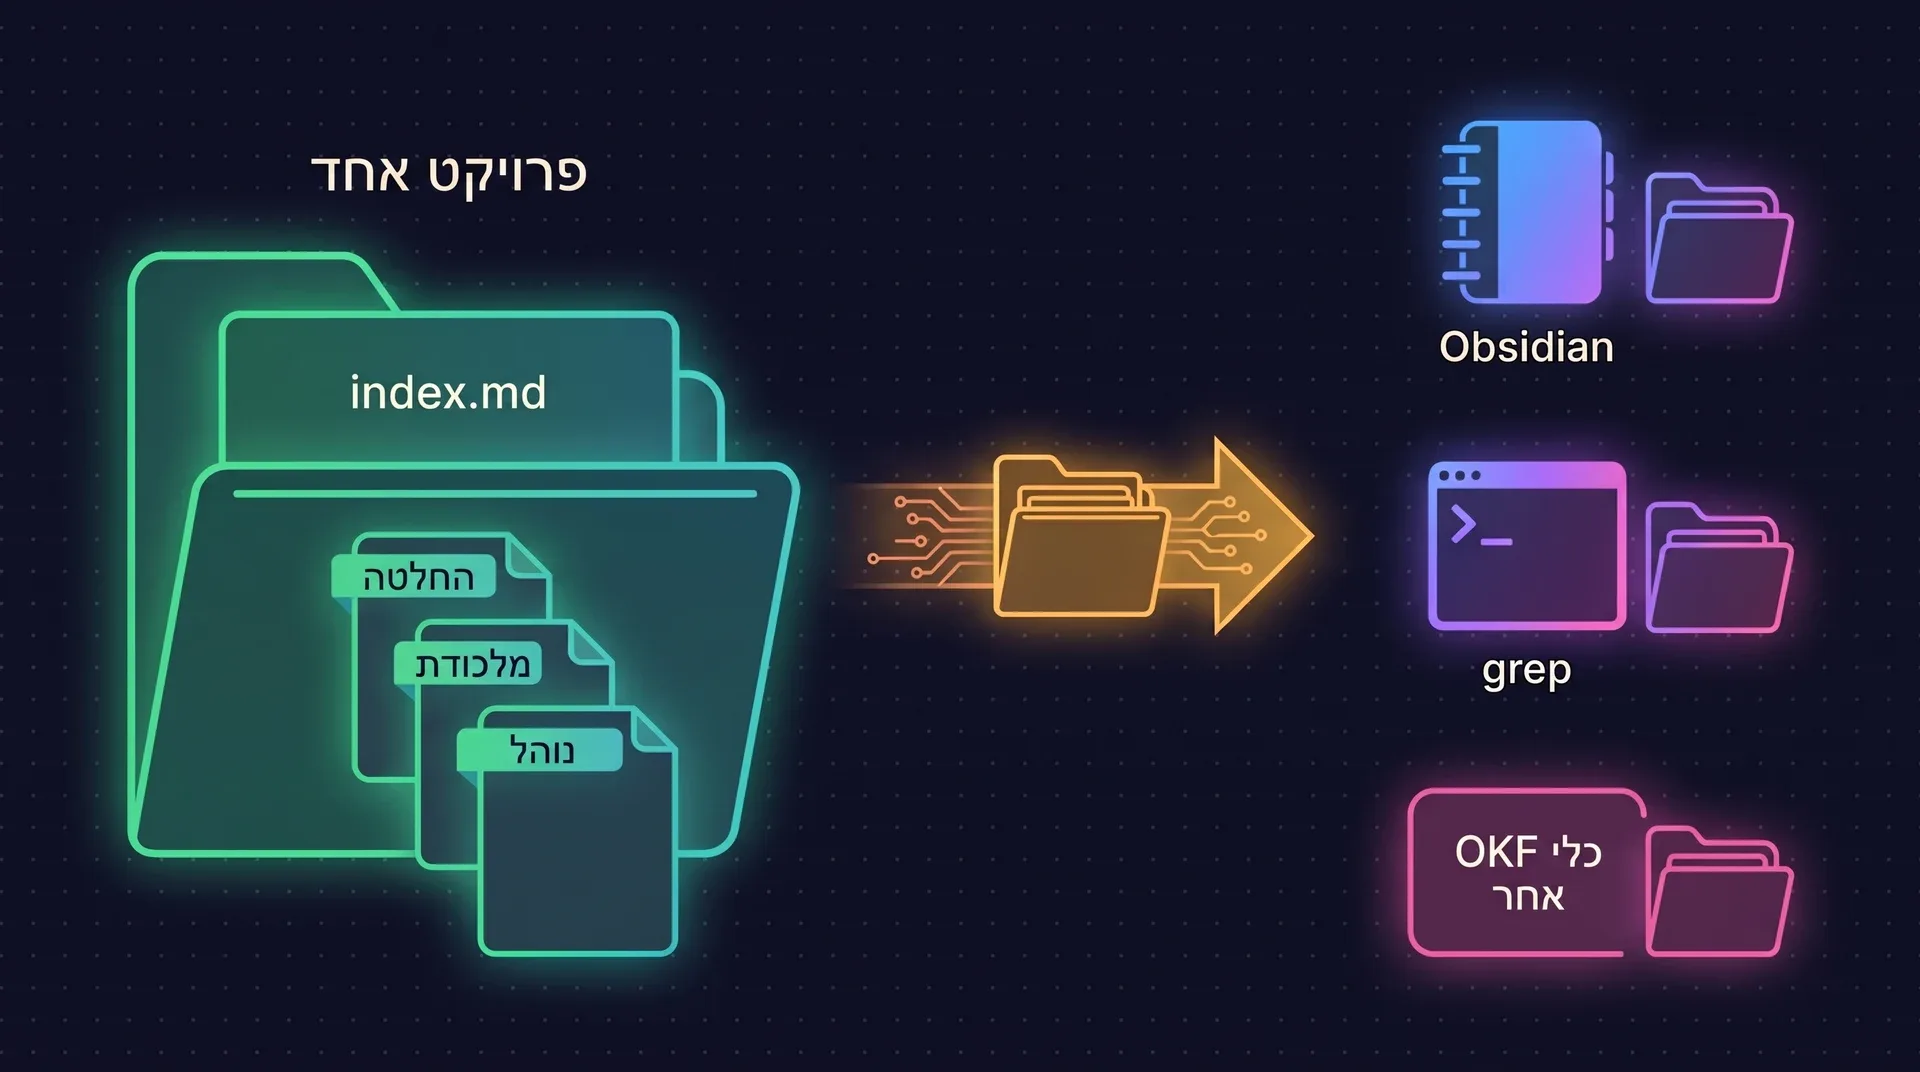
Open Knowledge Format הוא מפרט ש-Google Cloud פרסמה ביוני 2026. הוא מתאר ידע כתיקייה פשוטה של קובצי markdown עם YAML frontmatter, מושג אחד לכל קובץ, ושדה חובה יחיד: type. אין SDK ואין runtime.
- מאז 2.0 הוויקי הוא bundle של OKF v0.2 באופן מובנה. הקבצים ש-ai-memory עובד עליהם הם קובצי ה-OKF עצמם, כך שאין שלב export שיכול לסטות מהאמת.
- פרויקט אחד הוא bundle אחד, עם
index.mdשנוצר אוטומטית בשורש שלו. - לכל דף יש YAML frontmatter עם
type, שנגזר מהתיקייה שבה הדף נמצא. - שדרוג מ-1.x כותב מחדש את ה-frontmatter במקום, אחרי גיבוי מאומת. אם הגיבוי נכשל, המיגרציה נעצרת.
ai-memory export-okf --project myproject -o myproject-bundle.tar.gz
אין פקודת import. פורסים bundle לתוך תיקיית הוויקי של פרויקט, וה-file watcher מאנדקס אותו. המיפוי ל-OKF מתועד שדה אחר שדה, והמפרט נמצא בrepository knowledge-catalog של Google Cloud.
| תיקייה | type ב-OKF |
|---|---|
sessions/ | Session Summary |
decisions/ | Decision |
gotchas/ | Gotcha |
procedures/ | Procedure |
concepts/ | Concept |
_rules/ | Rule |
notes/ | Note |
runbooks/ | Runbook |
_slots/ | Invariant או State |
"את המודל ואת ה-harness שוכרים. הזיכרון של הפרויקט שלך."
שמונה החלטות, והסיבה לכל אחת
רובן מובילות חזרה ל-issue מסוים בכלי זיכרון קודם.
בחרנו
Markdown ב-git בתור האמת
כי גיבוי או מעבר הם git clone או rsync. את מסד הנתונים אפשר לבנות מחדש מהקבצים, כך שאפשר להתאושש מהשחתה, וכל כלי שקורא markdown יכול לקרוא את הזיכרון שלכם.
בחרנו
קובץ SQLite אחד
כי טקסט מלא, וקטורים דחוסים וטבלאות קישורים יושבים בקובץ embedded יחיד. ה-issue trackers של פרויקטים אחרים הראו כמה באגי נכונות עולה סנכרון של שלושה stores.
בחרנו
אפס קריאות LLM כברירת מחדל
כי סיכומי הסשנים מבוססי כללים, כך שהתקנה חדשה לא עולה כלום. הלקח הגיע מפיצ'רים של LLM במקומות אחרים שהיו דלוקים כברירת מחדל והפתיעו משתמשים בחשבונות על טוקנים.
בחרנו
קובץ בינארי אחד
כי SQLite מגיע בפנים, libgit2 הוא vendored וה-embedder כתוב ב-Rust טהור. מנוע sidecar נפרד היה מקור הכאב הגדול ביותר של משתמשים בפרויקט שהפרויקט הזה מחליף.
בחרנו
בלי מסד נתונים גרפי
כי הגרף הוא טבלאות SQL: טבלת קישורים ושאילתות רקורסיביות. זה מכסה הרחבה של קפיצה אחת וקשתות מטופסות, בלי מנוע גרפים embedded שצריך להחזיק בחיים.
בחרנו
וקטורים הם אופציונליים
כי embeddings מקומיים דלוקים מאז 2.0 ועדיין אף פעם לא חובה. החיפוש הוא קוסינוס ב-brute force בתוך SQLite; הרחבת וקטורים מחכה עד שמספר הדפים או ההשהיה יצדיקו אותה.
בחרנו
העברות כפרוטוקול מטופס, שנתפס פעם אחת בלבד
כי כל סבב מחקר סימן את ההעברה בין סוכנים כנקודת התורפה של הכלים הקודמים. העברה היא רשומה מטופסת שמותאמת לפי תיקייה, ורק סשן אחד בדיוק יכול לקבל אותה.
בחרנו
דפים במקום שורות של עובדות
כי דף על החלטה אפשר לקרוא, לערוך ולהסביר בפרוזה. טבלה של עובדות שחולצו אי אפשר לפתוח ב-Obsidian או לסקור ב-diff.
על כתפי מי שקדמו
הפרויקט קרא את הקוד ואת ה-issue trackers של הכלים שהיו קודם, שמר את הרעיונות שהחזיקו מעמד והשאיר בחוץ את החלקים שנשברו שוב ושוב.
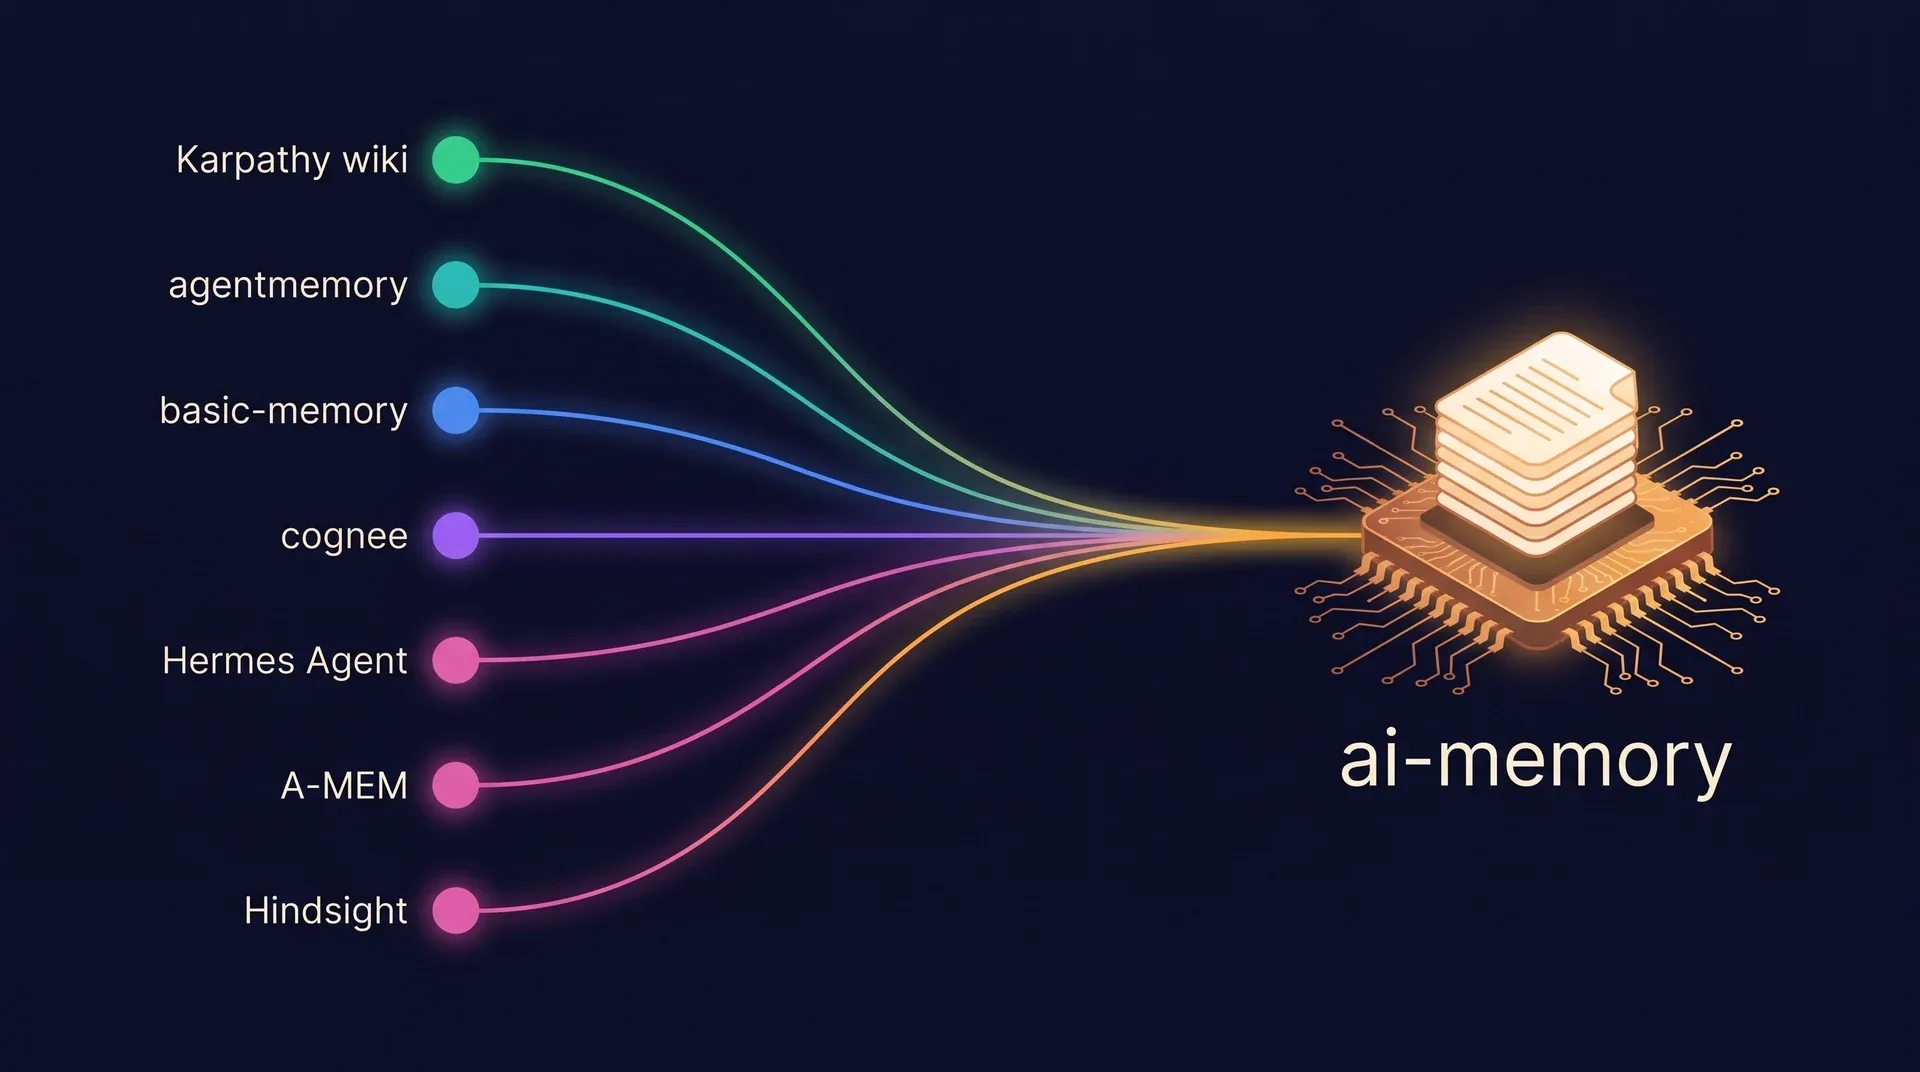
- Karpathy LLM Wiki
- לקמפל, לא לאחזר. הוויקי שעל הדיסק הוא התוצר.
- agentmemory
- לכידה אוטומטית מ-hooks, שכבות זיכרון, החלפת עובדות ישנות, דעיכה כנוסחה ודירוג משולב. ai-memory הוא היורש שלו ב-Rust: הרעיונות נשארו, התשתית התחלפה.
- basic-memory
- קבצים כמקור האמת עם אינדקס נגזר, וקישורים קדימה לדפים שעדיין לא קיימים.
- cognee
- המבנה של צינור משימות, חותמות של מקור המידע על כל דף ופידבק שמכוונן את הדירוג.
- Hermes Agent
- התכנון של לולאת השיפור העצמי, שסוקרת ברקע סשנים שהסתיימו.
- A-MEM
- פתקים אטומיים בסגנון Zettelkasten שמתקשרים זה לזה אוטומטית.
- Hindsight
- תוויות מיסוך מטופסות, ספירת ראיות לכל דף ותדריך שפותח בכללים שכבר הוכרעו.
- Honcho
- תשובות עם ציטוטים, רמות reasoning, והתזמון של סבב החלום: טריגר של חוסר פעילות, ביטול כשיש פעילות, והחדשני ביותר קודם.
אף אחד מהפרויקטים האלה לא נותן חסות ל-ai-memory. כדי לראות איפה כל אחד מהם מקדים, ראו את ההשוואה.
מה נמדד
מערך האחזור מקבל ציון על LongMemEval-S: 470 שאלות על היסטוריות צ'אט ארוכות, שרצות דרך מסלול ה-hooks האמיתי והחיפוש האמיתי. ה-harness של הבדיקה נמצא ב-repository.
- טקסט מלא בלבד, לפני 2.00.617
- טקסט מלא עם סינון stopwords0.666
- בתוספת embeddings מקומיים (ברירת המחדל)0.815
מה היה כל צעד
- הסרת stopwords משאילתות טקסט מלא הוסיפה 5.1 נקודות ל-hit@5 ו-8.5 ל-hit@1.
- מודל ה-embeddings שרץ בתוך התהליך הוסיף את השאר. מימוש נכון של masked-mean pooling היה שווה לבדו בערך 6.6 נקודות.
- אף שורה לא מערבת מפתח API או LLM.
| מדד | לפני 2.0 | טקסט מלא מסונן | embeddings מקומיים |
|---|---|---|---|
| hit@1 | 0.449 | 0.532 | 0.536 |
| hit@5 | 0.617 | 0.666 | 0.815 |
| recall@5 | 0.472 | 0.536 | 0.677 |
להריץ בעצמכם
מוסיפים --candidate-embeddings local לפקודה השנייה כדי להריץ טקסט מלא ו-embeddings מקומיים זה לצד זה. ההרצה שפורסמה היא מתאריך 21 בספטמבר 2026, על Ryzen 9 7950X3D.
cargo build --release -p ai-memory-cli
cargo run --release -p ai-memory-eval -- retrieval --fetch
גם קצב הכתיבה נמדד. המספרים נמצאים בדף הארכיטקטורה.
מה embeddings מקומיים נותנים, וכמה הם עולים
אותן 470 שאלות, בשתי הרצות: קודם עם טקסט מלא בלבד, ואחר כך עם מודל ה-embeddings המקומי של ברירת המחדל. עם embeddings הראיה מופיעה בעשר התוצאות הראשונות הרבה יותר פעמים, וכל שאילתה מתארכת בכ-90 ms.
| מדד | טקסט מלא, בלי LLM | embeddings מקומיים | שינוי |
|---|---|---|---|
| hit@1 | 0.532 | 0.536 | +0.004 |
| hit@5 | 0.666 | 0.815 | +0.149 |
| hit@10 | 0.694 | 0.891 | +0.198 |
| recall@10 | 0.564 | 0.817 | +0.254 |
| זמן שאילתה, חציון | 5 ms | 94 ms | +89 ms |
| זמן שאילתה, אחוזון 95 | 40 ms | 162 ms | +122 ms |
| טוקנים של הקשר לשאילתה, ממוצע | 350.3 | 415.7 | +65.4 |
- שתי הרצות מלאות על אותו commit קיבלו 0.815 ו-0.821, ולכן כדאי לקרוא את hit@5 כבערך 0.82, פלוס מינוס 0.005. ההרצה הקודמת, מ-1 בספטמבר 2026, קיבלה 0.823, כלומר אותה תוצאה. התיישנות הזיכרון כבויה כברירת מחדל, ולכן חיפוש ברירת המחדל לא השתנה.
- בתוך הרצה אחת ה-harness דטרמיניסטי: שתי הרצות של אותה תצורה נותנות דיוק וספירת טוקנים זהים. בין הרצות נפרדות, סוגי השאלות הקטנים זזים עד 0.03 לכל כיוון, ולכן ירידה באחד מהם בהרצה בודדת כמעט לא אומרת דבר.
מה הלאה, ואיפה הפרויקט מאחור
אלה המלצות מתועדות ב-repository. לאף אחת מהן אין תאריך.
מומלץ בהמשך
דיוק התשובות בקנה מידה מלא
ל-harness השני יש כבר הרצת אחזור מלאה, עם דיוק, זמן שאילתה וטוקנים של הקשר. במצב דיוק התשובות שלו יש בינתיים רק מדגם של 20 שאלות, והסעיפים שמתחת מחכים לו.
reranker מקומי
cross-encoder שרץ בתוך התהליך, בלי LLM. הוא מחכה ל-harness שלמעלה כדי להוכיח שהוא שווה את זה.
ברירות מחדל שמגובות במספרים
ציון הביטחון ויכולות ההתיישנות משוחררים כבויים. כל אחד מהם יהפוך לברירת מחדל רק אחרי שה-harness יראה שהוא עוזר. לסוגי הקישורים עדיין אין משקל בדירוג.
פקודת sync מוגבלת
או תיאור פשוט יותר של מודל השרת האחד, או ai-memory sync שבנוי על הוויקי ב-git.
התחלה קלה יותר למשתמשי Claude Code
כלי ייבוא למי שמגיע מהזיכרון המובנה של Claude.
לא מתוכנן: מסד נתונים גרפי, מערכת הפעלה לזיכרון שעורכת את עצמה, מחברים לענן, או הגדלת מספר הכלים רק לשם ההגדלה.
איפה הוא מאחור היום
ציוני האחזור הגולמיים נמוכים מאלה של כלים שמבצעים rerank, ולהתיישנות הזיכרון עדיין אין תוצאה מדודה. הרשימה המלאה נמצאת בדף ההשוואה.
"1.x הוכיחה שהרעיון עובד. 2.0 היא הגרסה שהייתי ממליץ עליה בלי כוכבית למי שרוצה להכניס אותה לצוות."
שאלות ותשובות
מה רעיון ה-LLM Wiki של Karpathy שמאחורי ai-memory?
ה-gist של Andrej Karpathy מאפריל 2026 מתאר LLM שבונה ומתחזק ויקי קבוע של קובצי markdown, שעומד בינכם לבין המקורות הגולמיים, כך שהידע מקומפל פעם אחת ונשמר מעודכן. ai-memory מיישם את זה לסוכני קוד, עם לכידה אוטומטית מ-hooks של מחזור החיים ומסלול ברירת מחדל שלא מבצע קריאות LLM.
האם ai-memory תואם ל-Open Knowledge Format?
מאז 2.0 כל פרויקט בוויקי הוא bundle של OKF v0.2 באופן מובנה. לכל דף יש YAML frontmatter עם type, לכל פרויקט יש index.md שנוצר אוטומטית, והפקודה ai-memory export-okf אורזת פרויקט ל-tarball מאומת.
מה הבנצ'מרק LongMemEval-S מודד אצל ai-memory?
אחזור בלבד: האם סשן שמחזיק את הראיה מופיע בתוצאות הראשונות, על פני 470 שאלות. hit@5 הוא 0.815 עם ה-embeddings המקומיים של ברירת המחדל ו-0.666 עם טקסט מלא בלבד. הוא לא מודד דיוק של תשובות.
קוראים את הנימוקים. אחר כך מנסים.
חינם ובקוד פתוח. התקנת ברירת המחדל לא מבצעת קריאות LLM ומאזינה רק על המחשב שלכם.