
검색하지 말고 컴파일하라
2026년 4월 Andrej Karpathy는 자신이 LLM 위키라고 부른 것에 대한 짧은 "아이디어 파일"을 공개했습니다. ai-memory는 그 아이디어를, 쉬지 않고 자료를 만들어 내는 코딩 에이전트에 맞게 옮긴 것입니다.
"지식은 한 번 컴파일된 뒤 최신 상태로 유지됩니다. 쿼리할 때마다 다시 도출하지 않습니다."
세 개의 계층
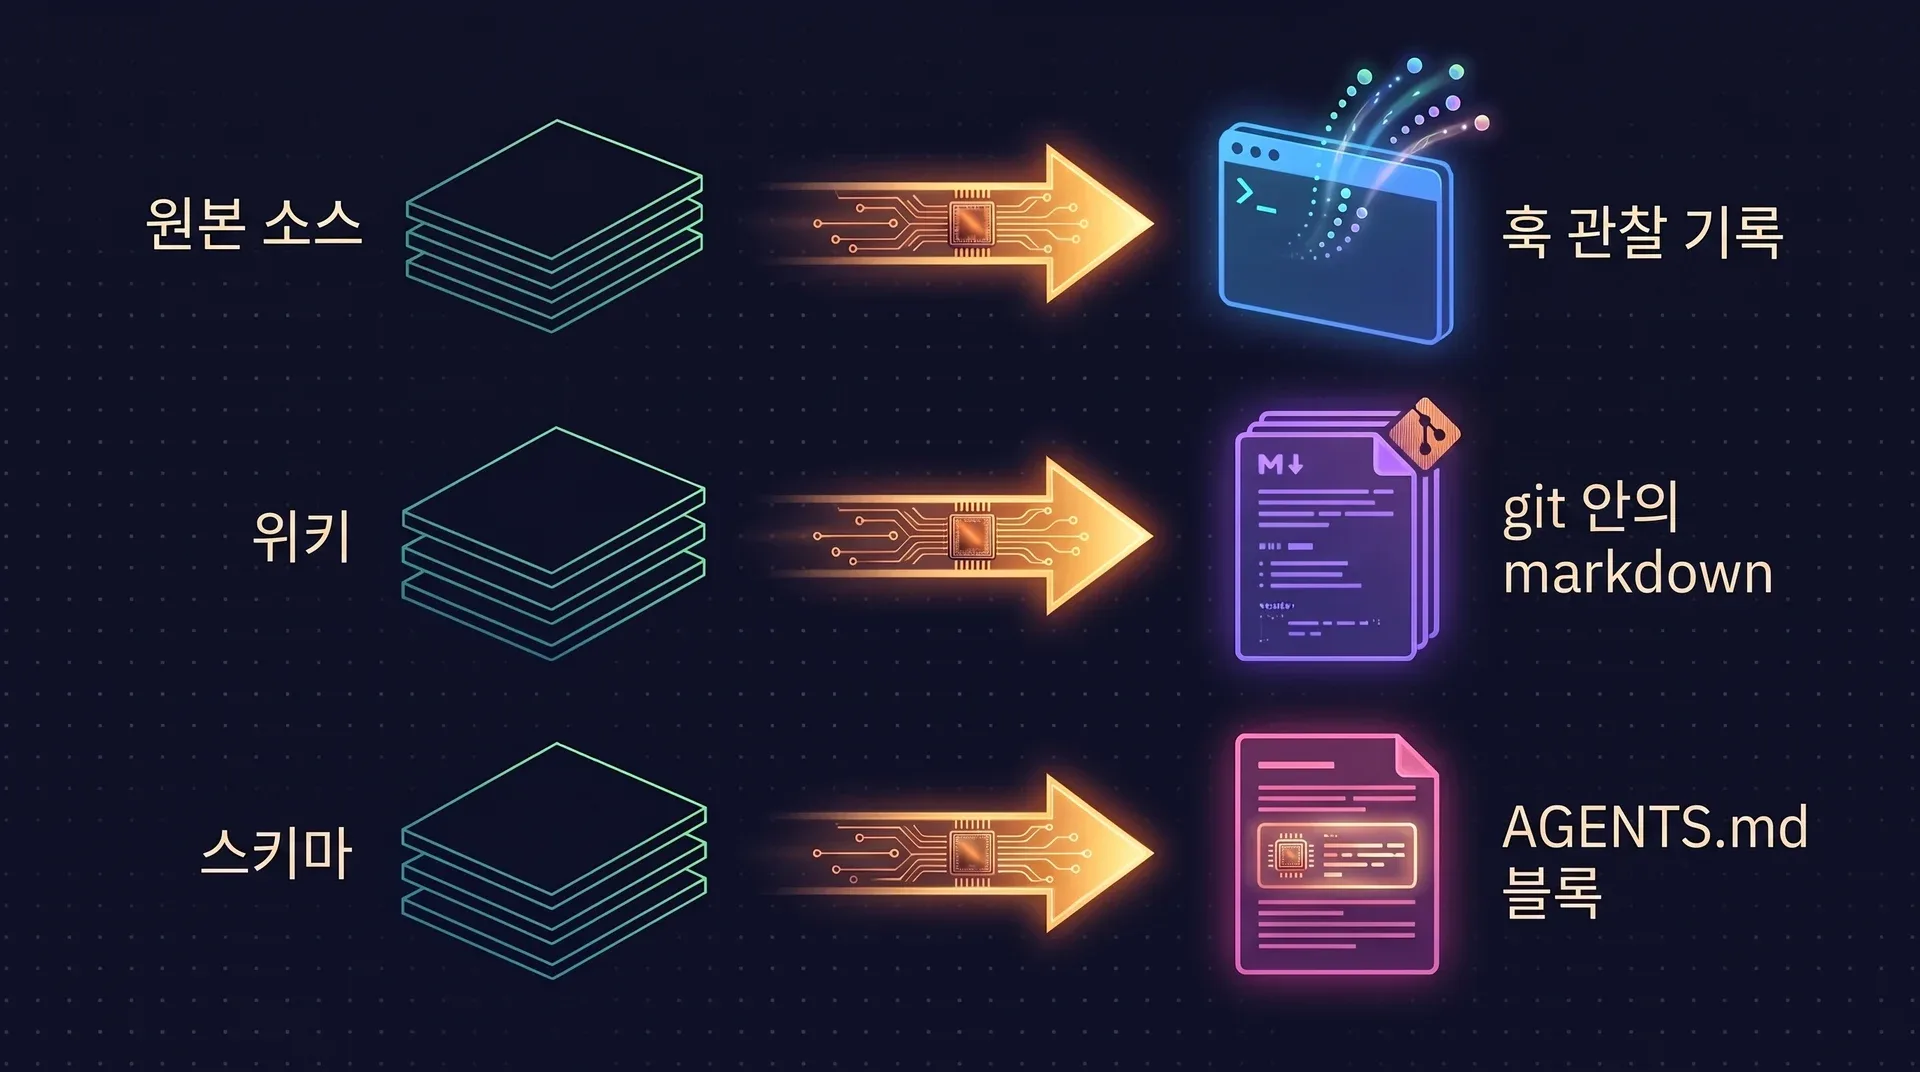
절대 바뀌지 않는 원본 소스, LLM이 관리하는 markdown 페이지의 위키, 그리고 위키가 어떻게 동작하는지 에이전트에게 알려 주는 스키마 파일.
세 가지 작업
소스를 수집해 관련된 페이지를 갱신합니다. 위키에 쿼리합니다. 모순과 고아 페이지를 린트로 찾습니다.
ai-memory가 그대로 가져온 것
- 사람이 열고, diff하고, 읽을 수 있는 실체로서 git 저장소 안의 markdown 파일.
- 지식이 들어올 때 컴파일하기. 세션 하나가 여러 페이지로 펼쳐집니다.
- 페이지 사이의 위키링크가 곧 그래프.
- 모순, 오래된 페이지, 고아 페이지, 중복 제목을 찾는 린트.
- 에이전트가 위키 사용법을 알도록 CLAUDE.md나 AGENTS.md에 설치되는 스키마 블록.
바꾼 것
Karpathy의 패턴은 사람이 소스를 하나씩 골라 관리합니다. 코딩 에이전트는 자료를 끊임없이 만들어 내고, 지켜보는 사람은 없습니다.
| gist에서는 | ai-memory에서는 |
|---|---|
| LLM에게 소스를 하나씩 건넵니다 | 라이프사이클 훅이 모든 세션을 알아서 캡처합니다 |
| 에이전트가 index.md부터 읽습니다 | 융합된 인덱스 하나: 전문 검색, 엔티티, 링크, 벡터 |
| 유지 관리는 전부 LLM이 합니다 | 기본은 규칙 기반 요약. LLM은 옵트인 |
| 한 사람, 위키 하나 | 에이전트 간 인수인계, 여러 사용자, 프로젝트별 범위 |
| 페이지는 영원히 남습니다 | 계층, 감쇠, 대체 처리, TTL로 오래된 페이지를 걸러 냅니다 |
계층, 감쇠, 대체 처리는 Karpathy의 gist에 없습니다. agentmemory와 그 주변의 "LLM Wiki v2" 글에서 왔습니다. 전체 독서 노트는 저장소에 있습니다.
당신의 기억은 이미 오픈 포맷입니다
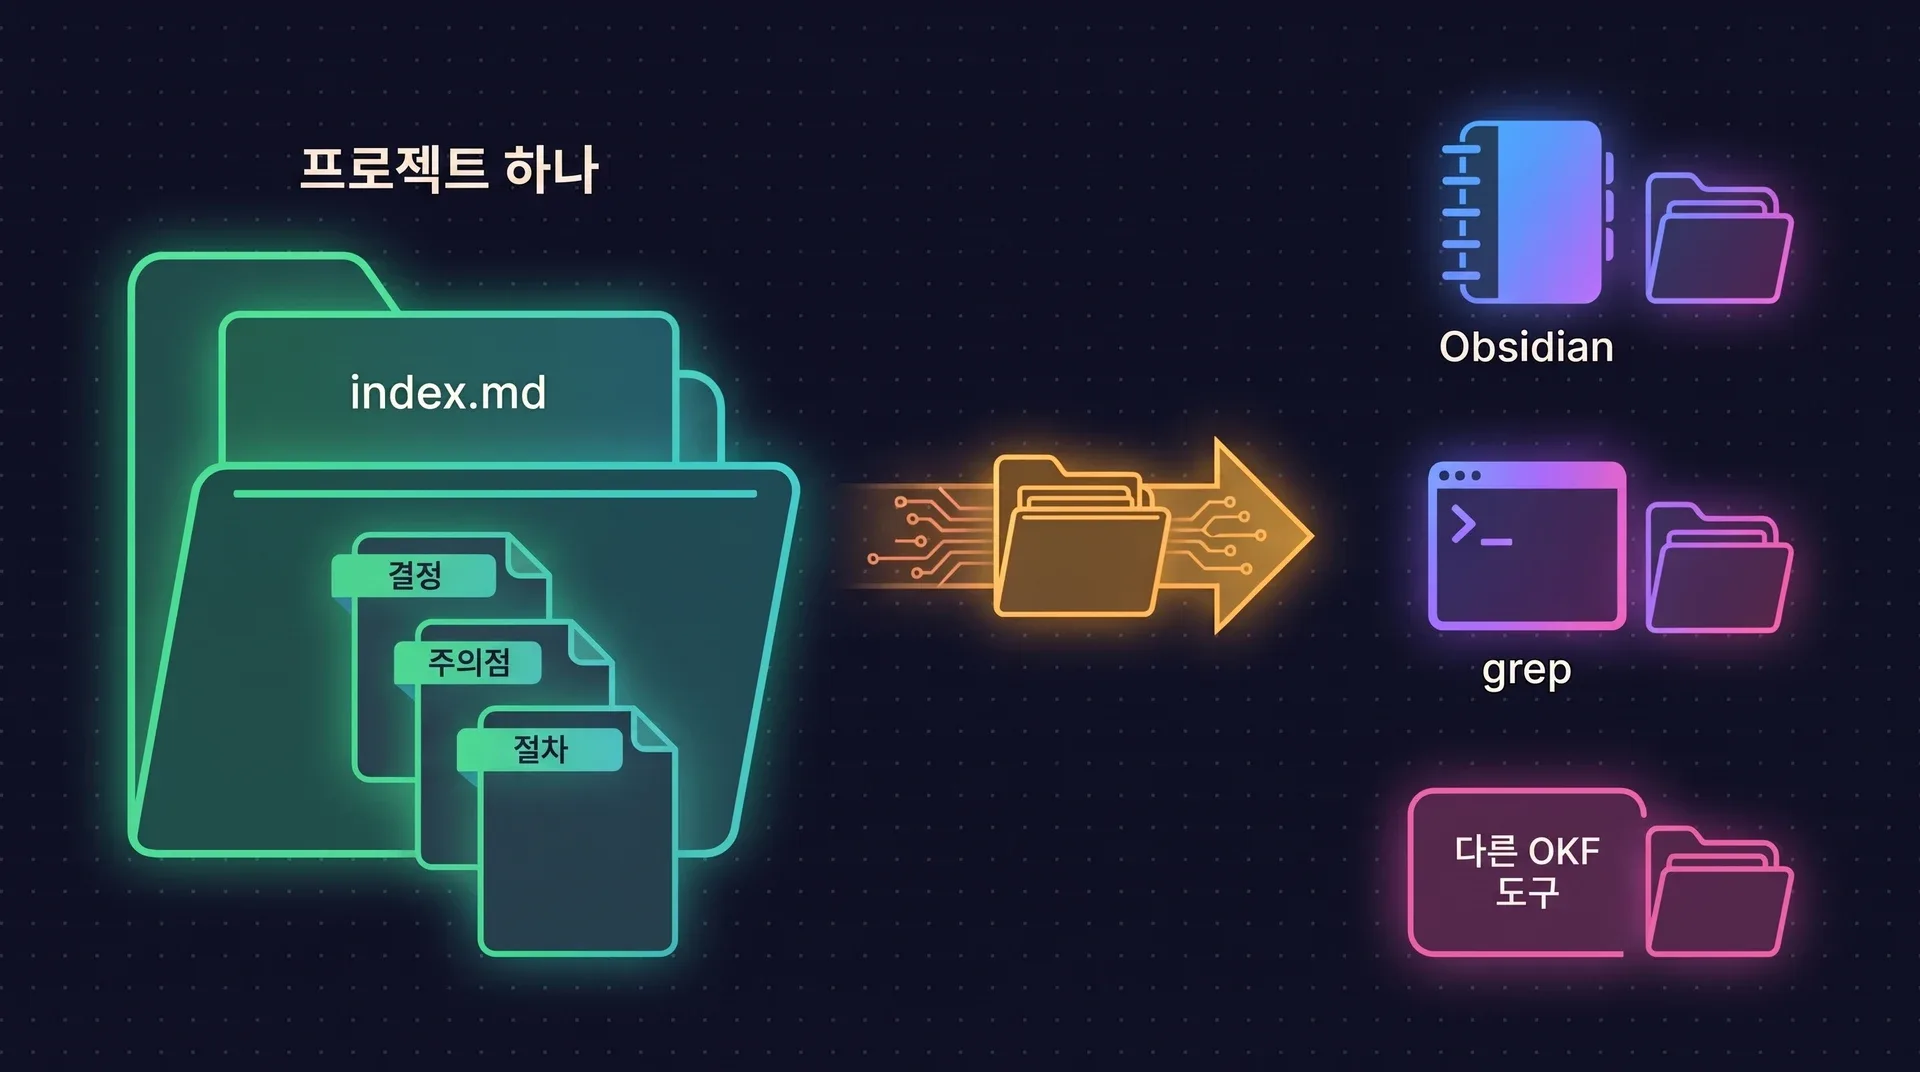
Open Knowledge Format은 Google Cloud가 2026년 6월에 공개한 명세입니다. 지식을 YAML 프런트매터가 붙은 markdown 파일의 일반 디렉터리로 기술하며, 파일 하나에 개념 하나를 담고, 필수 필드는 type 하나뿐입니다. SDK도 런타임도 없습니다.
- 2.0부터 위키는 그 자체로 OKF v0.2 번들입니다. ai-memory가 다루는 파일이 곧 OKF 파일이므로, 원본과 어긋날 수 있는 내보내기 단계가 없습니다.
- 프로젝트 하나가 번들 하나이며, 루트에 자동 생성된
index.md가 있습니다. - 모든 페이지에는
type이 들어간 YAML 프런트매터가 있고, 그 값은 페이지가 놓인 폴더에서 정해집니다. - 1.x에서 업그레이드하면 검증된 백업을 만든 뒤 프런트매터를 그 자리에서 다시 씁니다. 백업이 실패하면 마이그레이션은 멈춥니다.
ai-memory export-okf --project myproject -o myproject-bundle.tar.gz
import 명령은 없습니다. 번들을 프로젝트의 위키 디렉터리에 풀면 파일 감시기가 인덱싱합니다. OKF 매핑은 필드 단위로 문서화되어 있고, 명세는 Google Cloud의 knowledge-catalog 저장소에 있습니다.
| 폴더 | OKF type |
|---|---|
sessions/ | Session Summary |
decisions/ | Decision |
gotchas/ | Gotcha |
procedures/ | Procedure |
concepts/ | Concept |
_rules/ | Rule |
notes/ | Note |
runbooks/ | Runbook |
_slots/ | Invariant 또는 State |
"모델과 하네스는 빌려 쓰는 것이고, 프로젝트의 기억은 당신 것입니다."
여덟 가지 결정과 각각의 이유
대부분은 이전 메모리 도구의 구체적인 이슈로 거슬러 올라갑니다.
우리의 선택
git 속 markdown이 원본
이유: 백업이나 이전이 git clone 또는 rsync 한 번으로 끝납니다. 데이터베이스는 파일에서 다시 만들 수 있어 깨져도 복구되고, markdown을 읽는 도구라면 무엇이든 당신의 기억을 읽을 수 있습니다.
우리의 선택
SQLite 파일 하나
이유: 전문 검색, 압축된 벡터, 링크 테이블이 임베디드 파일 하나에 있습니다. 스토어 세 개를 동기화하면 정확성 버그가 얼마나 생기는지는 다른 프로젝트의 이슈 트래커가 보여 줬습니다.
우리의 선택
기본값은 LLM 호출 0회
이유: 세션 요약이 규칙 기반이라 새로 설치해도 비용이 들지 않습니다. 다른 도구에서 기본으로 켜진 LLM 기능 때문에 사용자가 예상치 못한 토큰 요금을 받은 사례에서 배웠습니다.
우리의 선택
단일 바이너리
이유: SQLite는 번들되어 있고, libgit2는 vendoring되어 있으며, 임베더는 순수 Rust입니다. 이 프로젝트의 전신에서 사용자 불만이 가장 많이 몰린 곳이 별도의 사이드카 엔진이었습니다.
우리의 선택
그래프 데이터베이스 없음
이유: 그래프는 SQL 테이블, 즉 링크 테이블과 재귀 쿼리입니다. 살려 둬야 할 임베디드 그래프 엔진 없이도 한 홉 확장과 타입 엣지를 처리합니다.
우리의 선택
벡터는 선택 사항
이유: 로컬 임베딩은 2.0부터 기본으로 켜져 있지만 여전히 필수가 아닙니다. 검색은 SQLite 안에서 브루트 포스 코사인으로 하고, 벡터 확장은 페이지 수나 지연 시간이 요구할 때까지 미뤄 둡니다.
우리의 선택
타입이 있고 한 번만 수령되는 인수인계 프로토콜
이유: 조사할 때마다 에이전트 간 전달이 이전 도구들의 약점으로 지적됐습니다. 인수인계는 디렉터리로 매칭되는 타입 있는 레코드이고, 정확히 한 세션만 수락할 수 있습니다.
우리의 선택
팩트 행 대신 페이지
이유: 결정을 다룬 페이지는 읽고, 고치고, 글로 설명할 수 있습니다. 추출된 팩트의 테이블은 Obsidian에서 열 수도, diff로 리뷰할 수도 없습니다.
앞선 프로젝트들의 어깨 위에서
이 프로젝트는 먼저 나온 도구들의 코드와 이슈 트래커를 읽고, 검증된 아이디어는 가져오고 계속 고장 나던 부분은 뺐습니다.
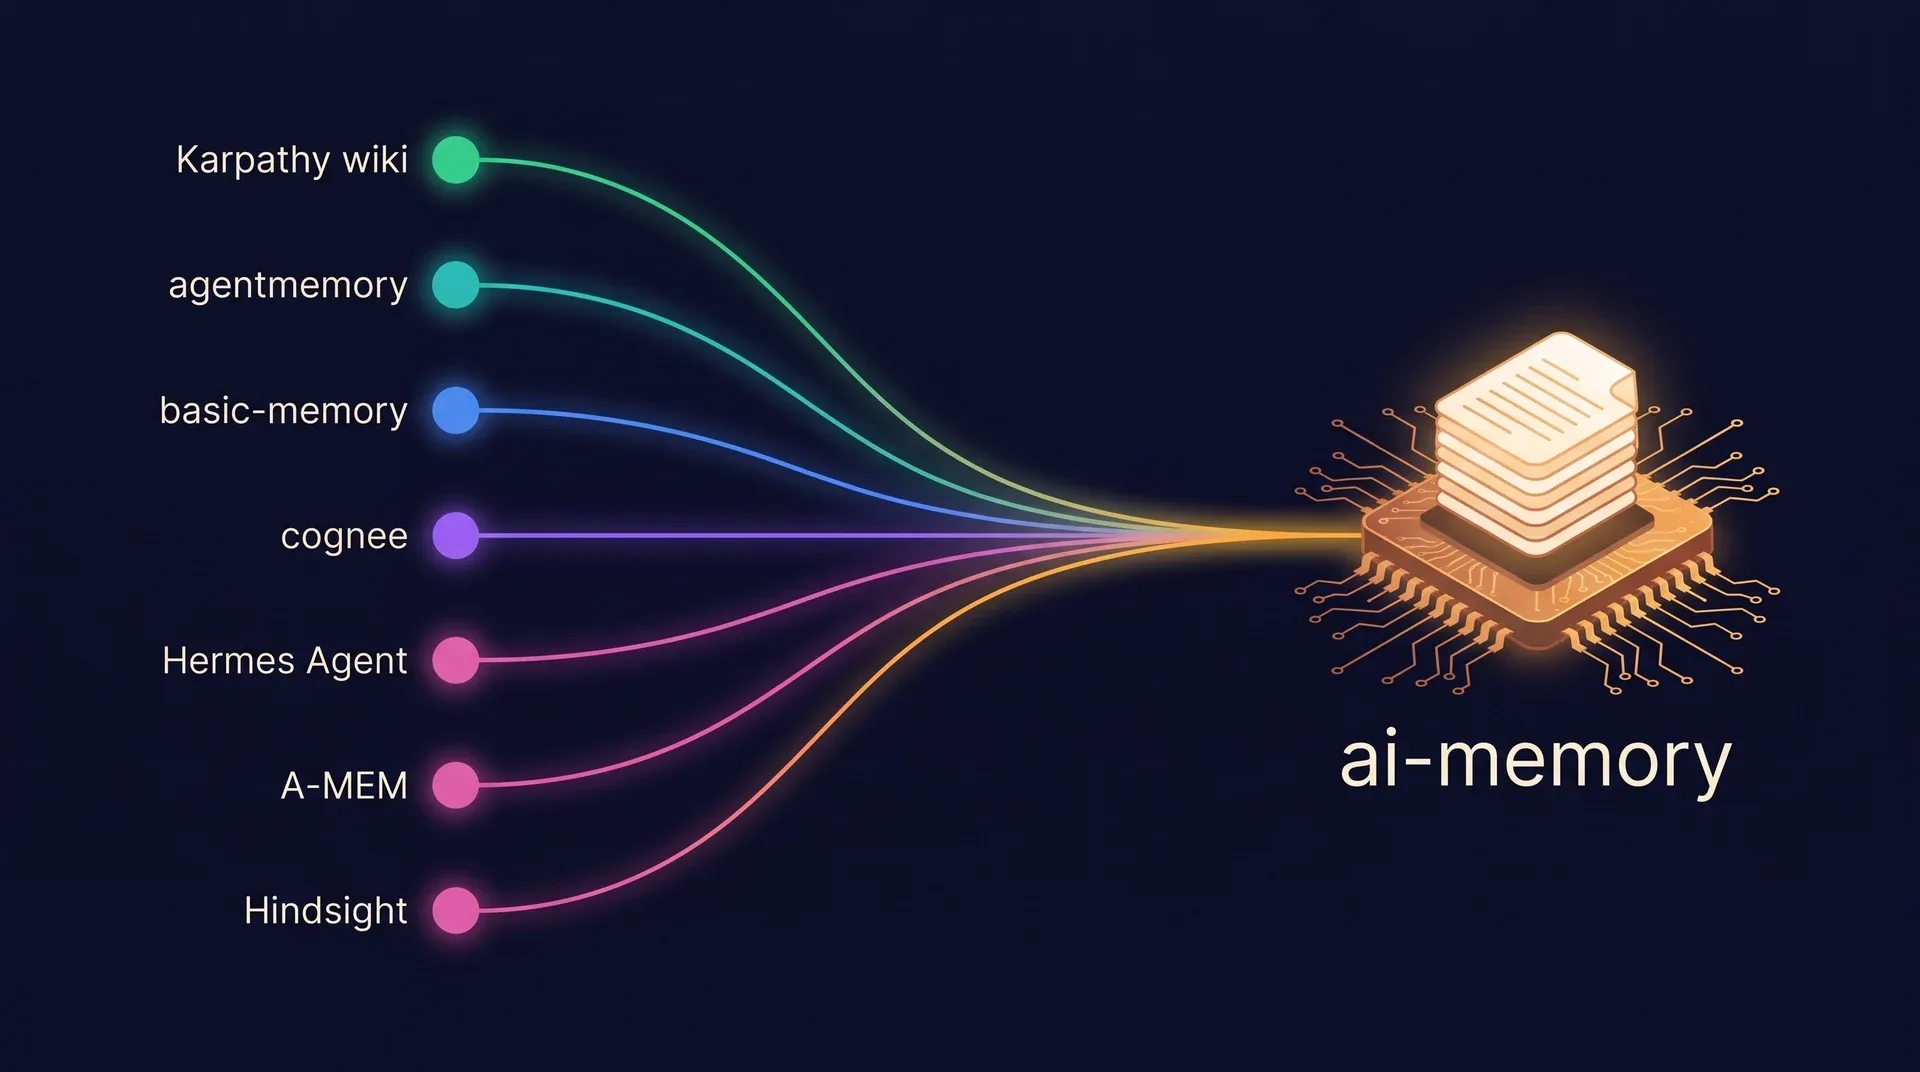
- Karpathy LLM Wiki
- 검색하지 말고 컴파일하라. 디스크 위의 위키가 곧 결과물입니다.
- agentmemory
- 훅 자동 캡처, 기억의 계층, 대체 처리, 수식으로 정의한 감쇠, 융합 랭킹. ai-memory는 이 프로젝트의 Rust 후속작입니다. 아이디어는 남고 기반이 바뀌었습니다.
- basic-memory
- 파일이 단일 진실 공급원이고 인덱스는 파생이라는 구조, 그리고 아직 없는 페이지로 향하는 forward link.
- cognee
- 태스크 파이프라인 구조, 모든 페이지에 찍히는 출처 추적 스탬프, 랭킹을 조정하는 피드백.
- Hermes Agent
- 끝난 세션을 백그라운드에서 검토하는 자기 개선 루프의 설계.
- A-MEM
- 서로 자동으로 연결되는 Zettelkasten 방식의 원자적 노트.
- Hindsight
- 타입이 붙은 마스킹 레이블, 페이지별 근거 횟수, 확정된 규칙을 먼저 보여 주는 브리핑.
- Honcho
- 인용이 붙은 답변, 추론 수준, 꿈 패스의 스케줄링: 유휴 트리거, 활동 시 취소, 가장 새로운 내용부터.
이 프로젝트들 중 어느 곳도 ai-memory를 보증하지 않습니다. 각 프로젝트가 어디서 앞서는지는 비교 페이지에서 확인하세요.
측정한 것
검색 스택은 LongMemEval-S로 채점합니다. 긴 채팅 기록에 대한 질문 470개를 실제 훅 경로와 실제 검색에 통과시킵니다. 하네스는 저장소에 있습니다.
- 전문 검색만, 2.0 이전0.617
- 불용어를 거른 전문 검색0.666
- 로컬 임베딩 추가(기본값)0.815
단계별로 한 일
- 전문 검색 쿼리에서 불용어를 빼자 hit@5가 5.1포인트, hit@1이 8.5포인트 올랐습니다.
- 나머지는 프로세스 내 임베딩 모델이 올렸습니다. masked-mean pooling을 제대로 구현한 것만으로 약 6.6포인트의 효과가 있었습니다.
- 어느 행에도 API 키와 LLM은 쓰이지 않았습니다.
| 지표 | 2.0 이전 | 불용어 필터 전문 검색 | 로컬 임베딩 |
|---|---|---|---|
| hit@1 | 0.449 | 0.532 | 0.536 |
| hit@5 | 0.617 | 0.666 | 0.815 |
| recall@5 | 0.472 | 0.536 | 0.677 |
직접 돌려 보기
두 번째 명령에 --candidate-embeddings local을 추가하면 전문 검색과 로컬 임베딩을 나란히 실행합니다. 공개된 실행은 2026년 9월 21일에 Ryzen 9 7950X3D에서 수행했습니다.
cargo build --release -p ai-memory-cli
cargo run --release -p ai-memory-eval -- retrieval --fetch
쓰기 처리량도 측정했습니다. 수치는 아키텍처 페이지에 있습니다.
로컬 임베딩으로 얻는 것과 치르는 비용
같은 질문 470개를 두 번 실행했습니다. 한 번은 전문 검색만, 한 번은 기본 로컬 임베딩 모델을 썼습니다. 임베딩을 쓰면 근거가 상위 10개 안에 들어오는 경우가 훨씬 많아지고, 쿼리 하나에 약 90 ms가 더 걸립니다.
| 지표 | 전문 검색, LLM 없음 | 로컬 임베딩 | 변화 |
|---|---|---|---|
| hit@1 | 0.532 | 0.536 | +0.004 |
| hit@5 | 0.666 | 0.815 | +0.149 |
| hit@10 | 0.694 | 0.891 | +0.198 |
| recall@10 | 0.564 | 0.817 | +0.254 |
| 쿼리 시간, 중앙값 | 5 ms | 94 ms | +89 ms |
| 쿼리 시간, 95번째 백분위수 | 40 ms | 162 ms | +122 ms |
| 쿼리당 컨텍스트 토큰, 평균 | 350.3 | 415.7 | +65.4 |
- 같은 커밋에서 전체 실행을 두 번 했더니 0.815와 0.821가 나왔으므로, hit@5는 약 0.82, 오차 0.005 정도로 읽으면 됩니다. 2026년 9월 1일의 이전 실행 점수는 0.823였고, 이는 같은 결과입니다. 기억 노화는 기본적으로 꺼져 있으므로 기본 검색은 달라지지 않았습니다.
- 한 번의 실행 안에서는 하네스가 결정적입니다. 같은 구성을 두 번 실행하면 정확도와 토큰 수가 똑같이 나옵니다. 별도의 실행 사이에서는 문항 수가 적은 질문 유형이 위아래로 최대 0.03까지 움직이므로, 한 번의 실행에서 그중 하나가 떨어졌다고 해서 큰 의미는 없습니다.
다음 계획, 그리고 뒤처진 부분
저장소에 문서화된 권고 사항입니다. 어느 것에도 일정은 없습니다.
다음으로 권고된 작업
전체 규모의 답변 정확도
두 번째 하네스에는 정확도, 쿼리 시간, 컨텍스트 토큰을 포함한 전체 검색 실행 결과가 있습니다. 답변 정확도 모드는 아직 질문 20개 표본뿐이며, 아래 항목들은 그 결과를 기다립니다.
로컬 리랭커
LLM 없이 프로세스 안에서 도는 cross-encoder. 위의 하네스로 효과를 입증한 뒤에 진행합니다.
수치로 뒷받침되는 기본값
신뢰도 점수와 노화 기능은 꺼진 상태로 출시됩니다. 하네스에서 도움이 된다고 확인된 뒤에야 각각 기본값이 됩니다. 링크 타입에는 여전히 랭킹 가중치가 없습니다.
범위가 제한된 sync 명령
서버 하나 모델을 더 쉽게 설명하는 문서, 또는 git 위키를 기반으로 한 ai-memory sync 중 하나.
Claude Code 사용자를 위한 더 쉬운 시작
Claude 내장 메모리에서 넘어오는 사람을 위한 importer.
계획에 없는 것: 그래프 데이터베이스, 스스로를 편집하는 메모리 OS, 클라우드 커넥터, 개수를 늘리기 위한 도구 추가.
지금 뒤처진 부분
순수 검색 점수는 rerank를 하는 도구들보다 낮고, 기억 노화는 아직 측정된 결과가 없습니다. 전체 목록은 비교 페이지에 있습니다.
"1.x는 아이디어가 통한다는 것을 증명했습니다. 2.0은 다른 사람이 팀에 도입하겠다고 할 때 단서를 달지 않고 추천할 수 있는 버전입니다."
자주 묻는 질문
ai-memory의 바탕이 된 Karpathy의 LLM Wiki 아이디어는 무엇인가요?
Andrej Karpathy의 2026년 4월 gist는 LLM이 사용자와 원본 소스 사이에서 markdown 파일로 된 영속적인 위키를 만들고 관리하는 방식을 설명합니다. 그래서 지식은 한 번 컴파일되고 최신 상태로 유지됩니다. ai-memory는 이를 코딩 에이전트에 적용했고, 라이프사이클 훅으로 자동 캡처하며 기본 경로에서는 LLM을 호출하지 않습니다.
ai-memory는 Open Knowledge Format과 호환되나요?
2.0부터 위키의 모든 프로젝트는 그 자체로 OKF v0.2 번들입니다. 페이지마다 type이 들어간 YAML 프런트매터가 있고, 프로젝트마다 자동 생성된 index.md가 있으며, ai-memory export-okf는 프로젝트를 검증된 tarball로 패키징합니다.
LongMemEval-S 벤치마크는 ai-memory의 무엇을 측정하나요?
검색만 측정합니다. 질문 470개에 대해 근거가 담긴 세션이 상위 결과에 나오는지를 봅니다. hit@5는 기본 로컬 임베딩으로 0.815, 전문 검색만으로 0.666입니다. 답변 정확도는 측정하지 않습니다.