
Produto
Pesquisa e fundamentos
Cada parte do ai-memory tem um motivo que você pode conferir: uma ideia de onde ela veio, um bug de uma ferramenta anterior que ela evita ou um número contra o qual ela foi medida. Esta página passa por eles em seis capítulos curtos.
Compile, não recupere
Em abril de 2026, Andrej Karpathy publicou um “idea file” curto sobre o que ele chamou de LLM wiki. O ai-memory é essa ideia, adaptada para agentes de código que nunca param de produzir material.
“O conhecimento é compilado uma vez e depois mantido atualizado, em vez de ser derivado de novo a cada consulta.”
Três camadas
Fontes brutas que nunca mudam, uma wiki de páginas markdown mantida pelo LLM e um arquivo de schema que explica ao agente como a wiki funciona.
Três operações
Ingerir uma fonte e atualizar as páginas que ela afeta. Consultar a wiki. Rodar lint atrás de contradições e páginas órfãs.
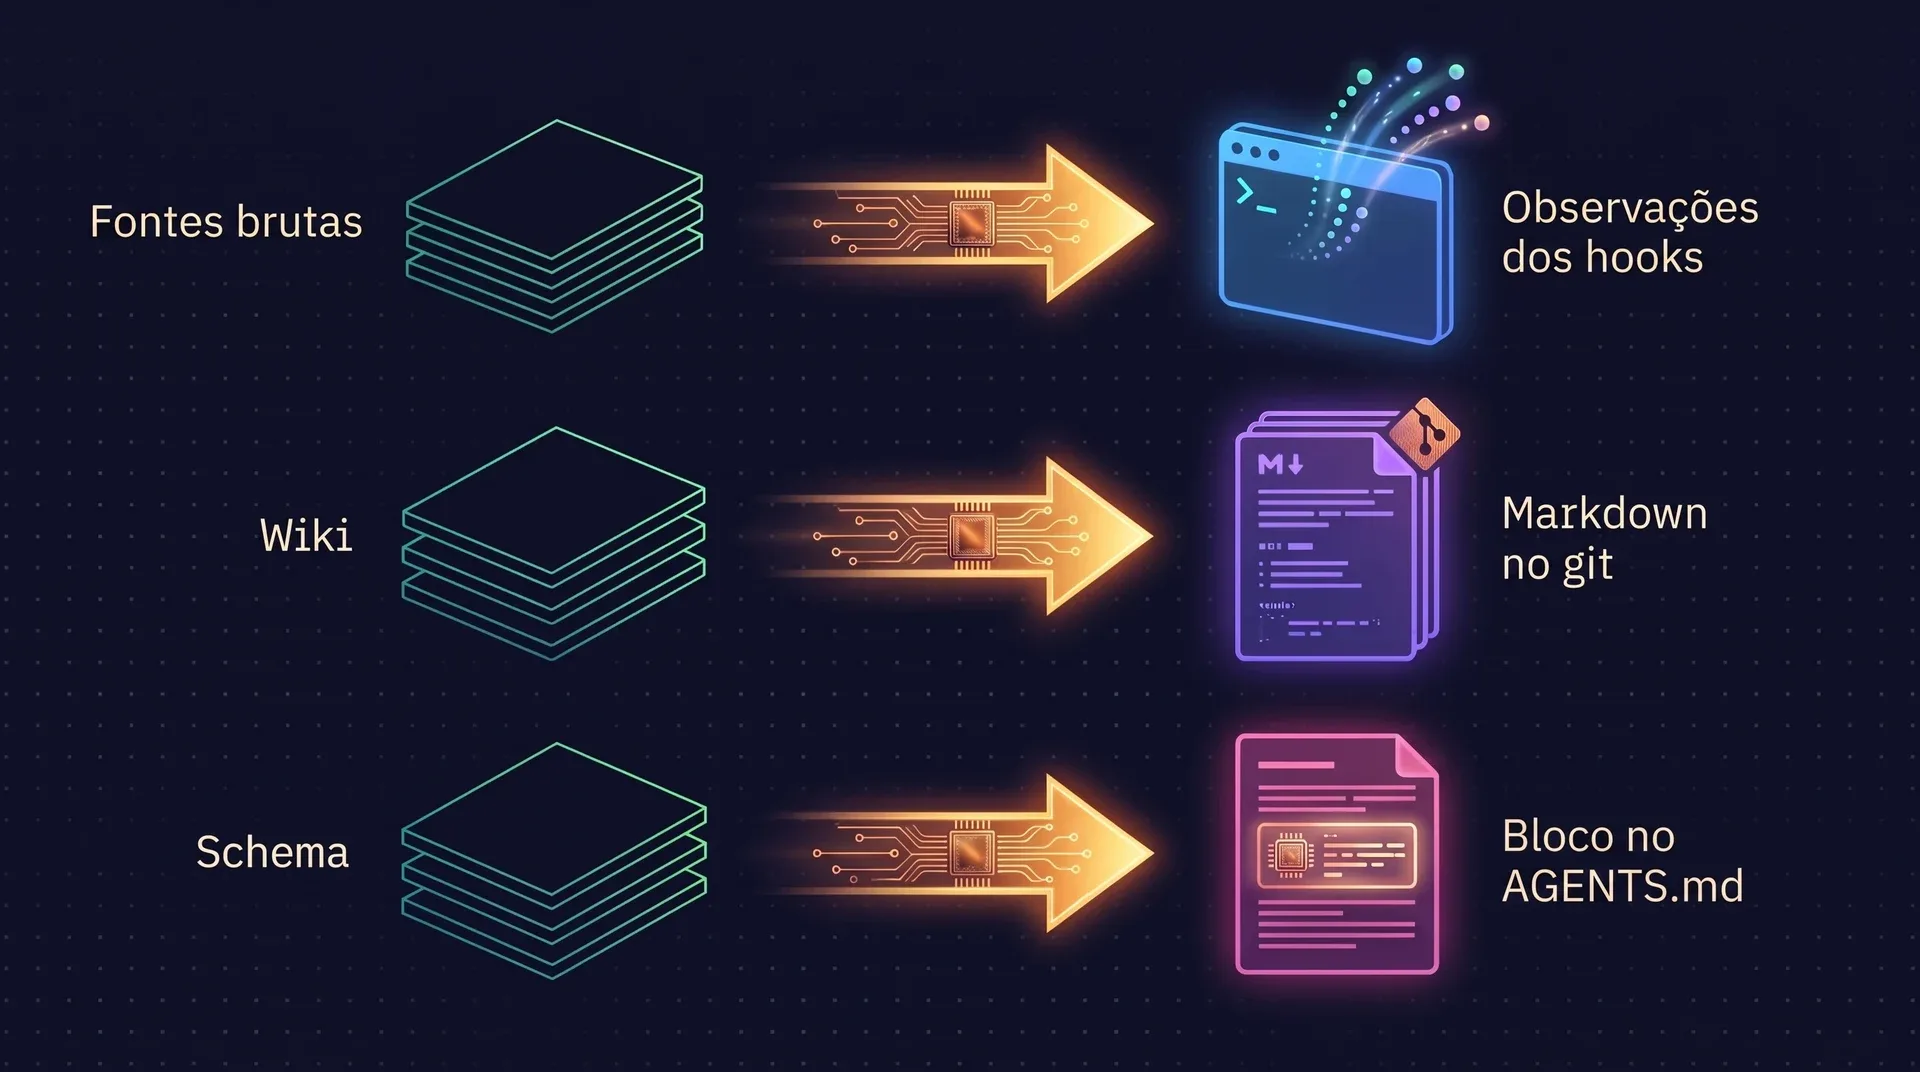
O que o ai-memory manteve
- Arquivos markdown num repositório git como aquilo que uma pessoa consegue abrir, comparar com diff e ler.
- Compilar o conhecimento na hora em que ele chega, com uma sessão se desdobrando em várias páginas.
- Wikilinks entre as páginas fazendo o papel de grafo.
- Lint para contradições, páginas desatualizadas, órfãs e títulos duplicados.
- Um bloco de schema instalado no CLAUDE.md ou no AGENTS.md para o agente saber como usar a wiki.
O que ele mudou
No padrão do Karpathy, uma pessoa faz a curadoria, uma fonte de cada vez. Um agente de código produz material sem parar e ninguém está olhando.
| No gist | No ai-memory |
|---|---|
| Você entrega ao LLM uma fonte de cada vez | Os hooks de ciclo de vida capturam todas as sessões sozinhos |
| O agente lê o index.md primeiro | Um índice fundido: full-text, entidades, links e vetores |
| Um LLM faz toda a manutenção | Resumos baseados em regras por padrão. LLM é opt-in |
| Uma pessoa, uma wiki | Handoffs entre agentes, vários usuários, escopo por projeto |
| As páginas vivem para sempre | Camadas de memória, decaimento, substituição e TTLs tiram as páginas velhas do caminho |
Camadas de memória, decaimento e substituição não estão no gist do Karpathy. Vêm do agentmemory e dos textos sobre a “LLM Wiki v2” em volta dele. As notas de leitura completas estão no repositório.
Sua memória já está num formato aberto
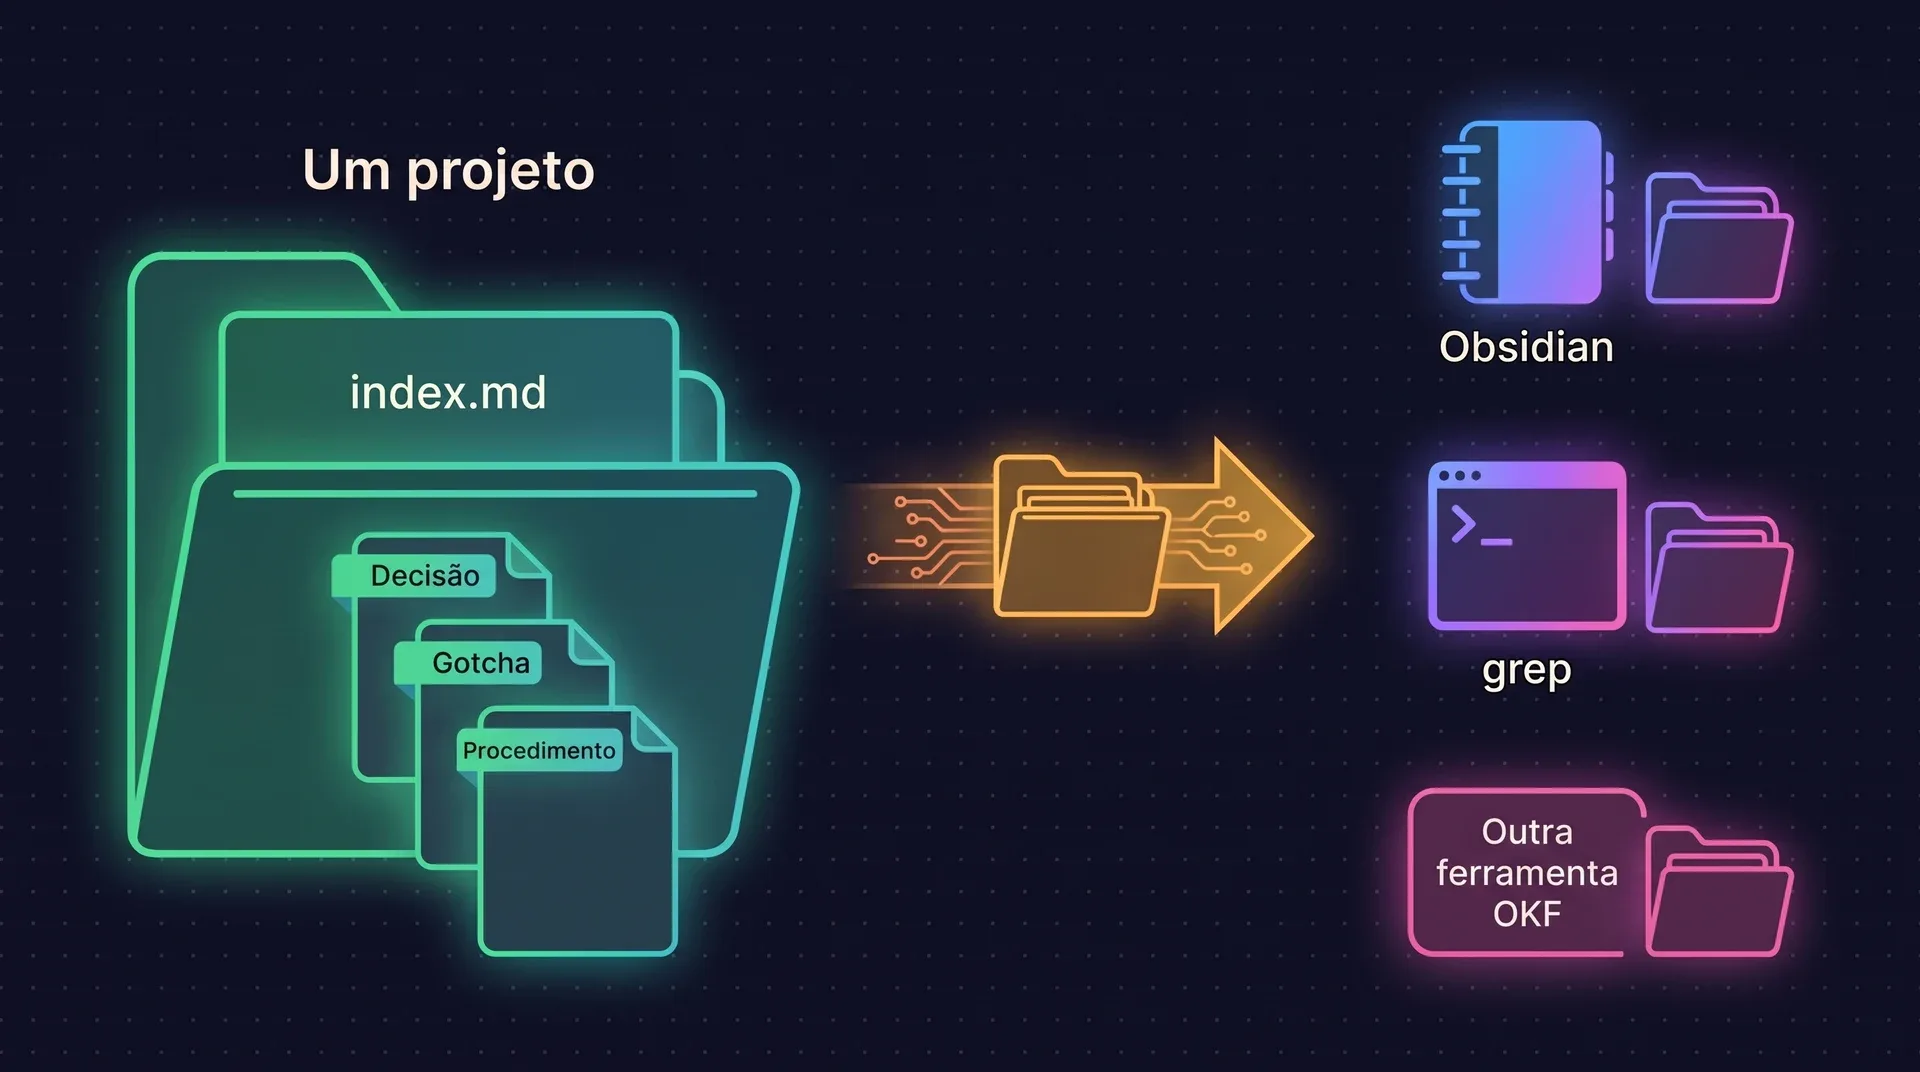
O Open Knowledge Format é uma especificação que o Google Cloud publicou em junho de 2026. Ela descreve conhecimento como um diretório comum de arquivos markdown com frontmatter YAML, um conceito por arquivo e um único campo obrigatório: type. Não tem SDK nem runtime.
- Desde a 2.0 a wiki é nativamente um bundle OKF v0.2. Os arquivos em que o ai-memory trabalha são os próprios arquivos OKF, então não existe etapa de export que possa divergir da verdade.
- Um projeto é um bundle, com um
index.mdgerado na raiz. - Toda página tem frontmatter YAML com um
type, derivado da pasta em que ela fica. - O upgrade a partir da 1.x reescreve o frontmatter no lugar, depois de um backup verificado. Se o backup falha, a migração para.
ai-memory export-okf --project myproject -o myproject-bundle.tar.gz
Não existe comando de import. Descompacte um bundle no diretório da wiki de um projeto e o file watcher indexa. O mapeamento para OKF está documentado campo a campo, e a especificação fica no repositório knowledge-catalog do Google Cloud.
| Pasta | Tipo OKF |
|---|---|
sessions/ | Session Summary |
decisions/ | Decision |
gotchas/ | Gotcha |
procedures/ | Procedure |
concepts/ | Concept |
_rules/ | Rule |
notes/ | Note |
runbooks/ | Runbook |
_slots/ | Invariant ou State |
“Modelo e harness são alugados, a memória do projeto é sua.”
Oito decisões, e o motivo de cada uma
A maioria delas vem de uma issue específica de alguma ferramenta de memória anterior.
Escolhemos
Markdown em git como a verdade
porque fazer backup ou mudar de lugar é um git clone ou um rsync. O banco pode ser reconstruído a partir dos arquivos, então corrupção tem conserto, e qualquer ferramenta que lê markdown consegue ler a sua memória.
Escolhemos
Um arquivo SQLite só
porque full-text, vetores compactados e tabelas de links ficam num único arquivo embutido. Os issue trackers de outros projetos mostraram quanto custa, em bugs de corretude, sincronizar três stores.
Escolhemos
Zero chamadas a LLM por padrão
porque os resumos de sessão são baseados em regras, então uma instalação nova não gasta nada. A lição veio de features com LLM ligadas por padrão em outras ferramentas, que surpreenderam os usuários com a conta de tokens.
Escolhemos
Um binário só
porque o SQLite vai embutido, o libgit2 vai vendorizado e o embedder é Rust puro. Um motor sidecar separado era a maior concentração de dor de usuário no projeto que este aqui sucede.
Escolhemos
Nada de banco de grafos
porque o grafo são tabelas SQL: uma tabela de links e consultas recursivas. Isso cobre expansão de um salto e arestas tipadas sem um motor de grafo embutido para manter vivo.
Escolhemos
Vetores são opcionais
porque os embeddings locais vêm ligados desde a 2.0 e continuam nunca sendo obrigatórios. A busca é cosseno por força bruta dentro do SQLite; uma extensão vetorial espera até a quantidade de páginas ou a latência pedirem.
Escolhemos
Handoff como protocolo tipado, assumido uma vez só
porque toda rodada de pesquisa apontou a transferência entre agentes como o ponto fraco das ferramentas anteriores. Um handoff é um registro tipado, casado por diretório, e só uma sessão consegue assumi-lo.
Escolhemos
Páginas em vez de linhas de fatos
porque uma página sobre uma decisão pode ser lida, editada e explicada em prosa. Uma tabela de fatos extraídos não abre no Obsidian nem passa por revisão num diff.
Sobre os ombros de quem veio antes
O projeto leu o código e os issue trackers das ferramentas que vieram antes, ficou com as ideias que se sustentaram e deixou de fora as partes que viviam quebrando.
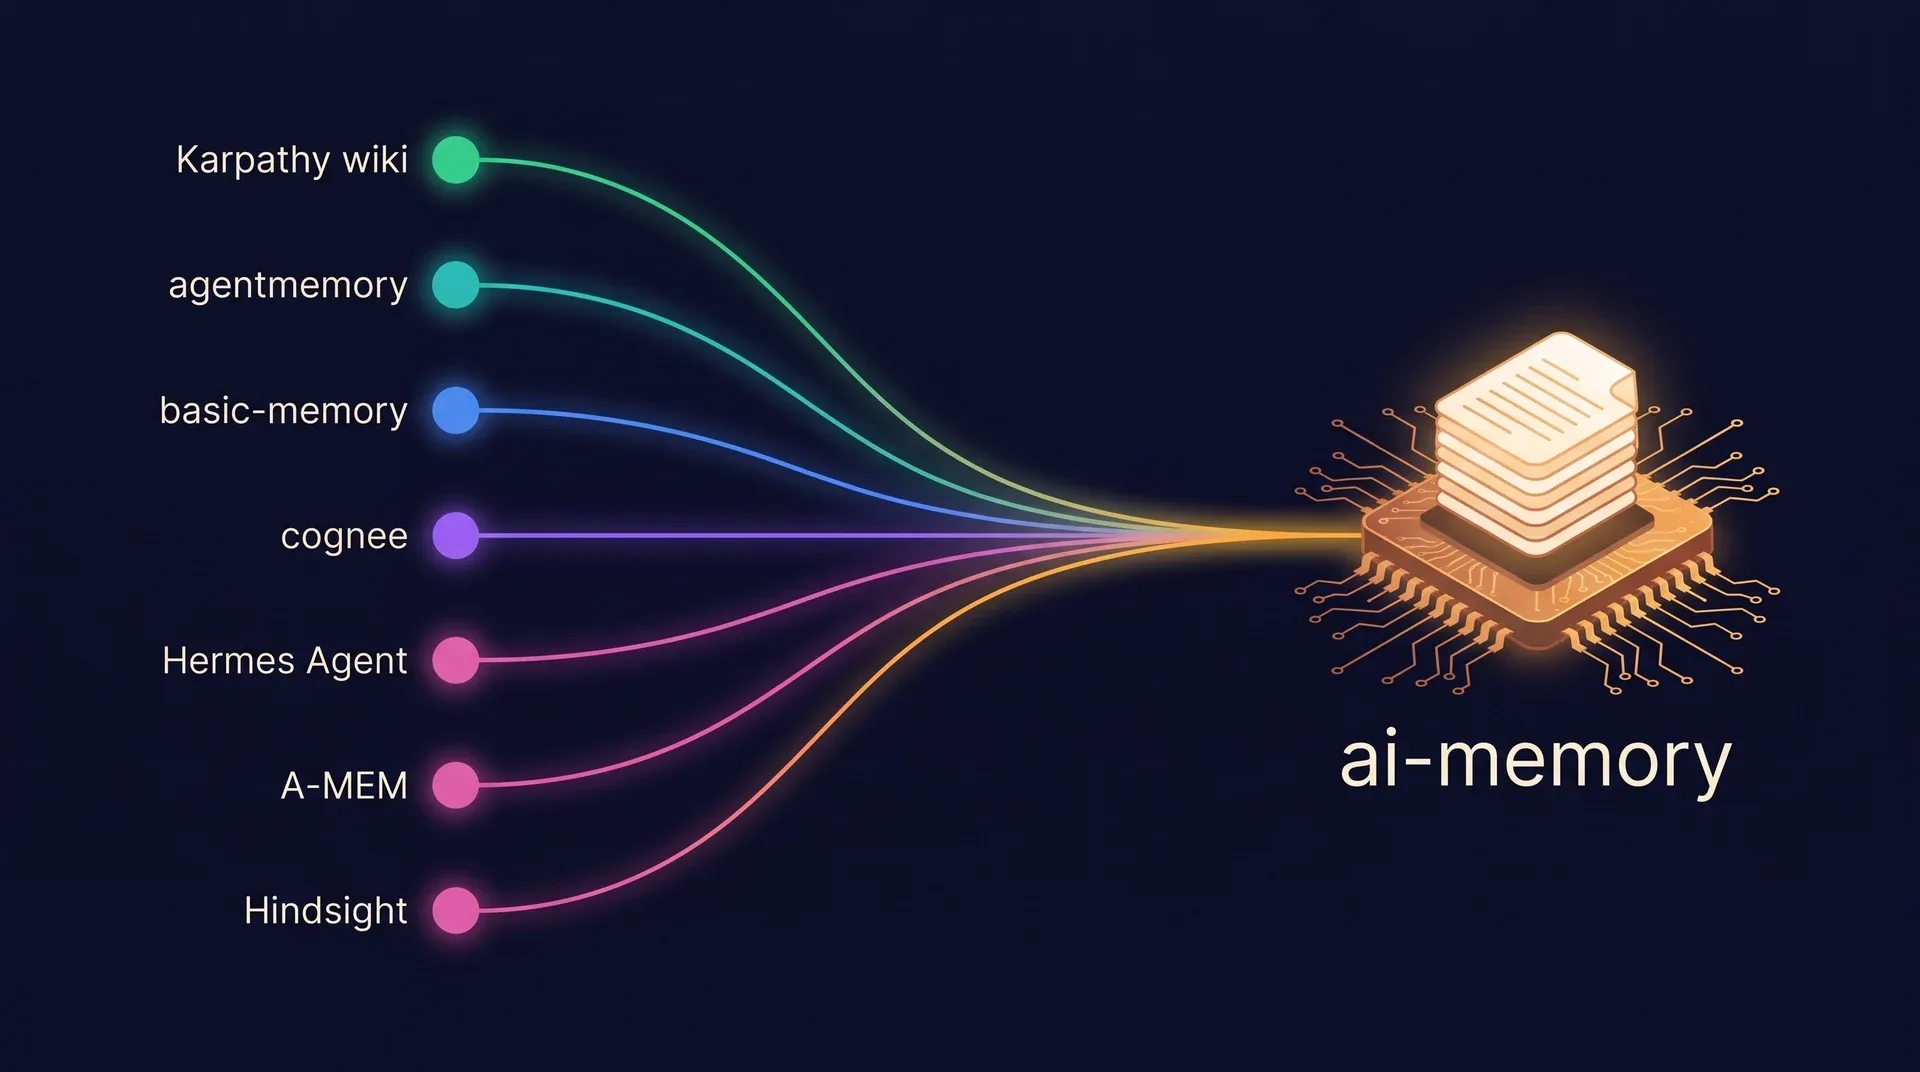
- Karpathy LLM Wiki
- Compile, não recupere. A wiki em disco é o artefato.
- agentmemory
- Captura automática por hooks, camadas de memória, substituição, decaimento como fórmula e ranking fundido. O ai-memory é o sucessor dele em Rust: as ideias ficaram, o substrato mudou.
- basic-memory
- Arquivos como fonte da verdade com um índice derivado, e links para páginas que ainda não existem.
- cognee
- O formato de pipeline de tarefas, carimbos de proveniência em toda página e feedback que ajusta o ranking.
- Hermes Agent
- O desenho do loop de autoaperfeiçoamento que revisa em background as sessões encerradas.
- A-MEM
- Notas atômicas no estilo Zettelkasten, que se ligam umas às outras automaticamente.
- Hindsight
- Rótulos tipados de redação, contagem de evidências por página e um briefing que começa pelas regras já estabelecidas.
- Honcho
- Respostas com citações, níveis de raciocínio e o agendamento da passada de sonho: gatilho por ociosidade, cancelamento quando há atividade, o mais inédito primeiro.
Nenhum desses projetos endossa o ai-memory. Para saber onde cada um deles está na frente, veja a comparação.
O que foi medido
A pilha de recuperação é avaliada no LongMemEval-S: 470 perguntas sobre históricos longos de chat, passando pelo caminho real dos hooks e pela busca real. O harness está no repositório.
- Só full-text, antes da 2.00,617
- Full-text com filtro de stopwords0,666
- Mais embeddings locais (o padrão)0,815
O que foi cada passo
- Tirar as stopwords das consultas full-text somou 5,1 pontos de hit@5 e 8,5 de hit@1.
- O modelo de embeddings dentro do processo somou o resto. Acertar o masked-mean pooling valeu, sozinho, cerca de 6,6 pontos.
- Nenhuma linha envolve chave de API ou LLM.
| Métrica | Antes da 2.0 | Full-text filtrado | Embeddings locais |
|---|---|---|---|
| hit@1 | 0,449 | 0,532 | 0,536 |
| hit@5 | 0,617 | 0,666 | 0,815 |
| recall@5 | 0,472 | 0,536 | 0,677 |
Rode você mesmo
Acrescente --candidate-embeddings local ao segundo comando para rodar full-text e embeddings locais lado a lado. A execução publicada é de 21 de setembro de 2026, num Ryzen 9 7950X3D.
cargo build --release -p ai-memory-cli
cargo run --release -p ai-memory-eval -- retrieval --fetch
Resultados completos, por tipo de pergunta
A vazão de escrita também foi medida. Os números estão na página de arquitetura.
O que os embeddings locais entregam, e quanto custam
As mesmas 470 perguntas, rodadas duas vezes: primeiro só com full-text, depois com o modelo de embeddings local padrão. Com embeddings, a evidência aparece entre os dez primeiros com muito mais frequência, e cada consulta fica cerca de 90 ms mais lenta.
| Métrica | Full-text, sem LLM | Embeddings locais | Variação |
|---|---|---|---|
| hit@1 | 0,532 | 0,536 | +0,004 |
| hit@5 | 0,666 | 0,815 | +0,149 |
| hit@10 | 0,694 | 0,891 | +0,198 |
| recall@10 | 0,564 | 0,817 | +0,254 |
| Tempo de consulta, mediana | 5 ms | 94 ms | +89 ms |
| Tempo de consulta, percentil 95 | 40 ms | 162 ms | +122 ms |
| Tokens de contexto por consulta, média | 350,3 | 415,7 | +65,4 |
- Duas execuções completas no mesmo commit marcaram 0,815 e 0,821, então leia o hit@5 como cerca de 0,82, com 0,005 para mais ou para menos. A execução anterior, de 1 de setembro de 2026, marcou 0,823, que é o mesmo resultado. O envelhecimento da memória sai desligado por padrão, então a busca padrão não mudou.
- Dentro de uma execução o harness é determinístico: rodar a mesma configuração duas vezes dá acurácia e contagem de tokens idênticas. Entre execuções separadas, os tipos de pergunta menores variam até 0,03 para cima ou para baixo, então uma queda em um deles vista em uma única execução quer dizer pouco.
O que vem a seguir, e onde ele está atrás
Estas são recomendações documentadas no repositório. Nenhuma delas tem data.
Próximos passos recomendados
Acurácia das respostas em escala completa
O segundo harness já tem uma execução completa de recuperação, com acurácia, tempo de consulta e tokens de contexto. O modo de acurácia das respostas só tem uma amostra de 20 perguntas por enquanto, e os itens abaixo esperam por ele.
Um reranker local
Um cross-encoder que roda dentro do processo, sem LLM. Ele espera o harness acima para provar que vale a pena.
Padrões sustentados por números
A pontuação de confiança e os recursos de envelhecimento saem desligados. Cada um só vira padrão depois que o harness mostrar que ajuda. Os tipos de link continuam sem peso no ranking.
Um comando de sync limitado
Ou uma descrição mais clara do modelo de um servidor só, ou um ai-memory sync construído em cima da wiki em git.
Um começo mais fácil para quem usa Claude Code
Um importador para quem vem da memória embutida do Claude.
Fora dos planos: um banco de grafos, um sistema operacional de memória que se edita sozinho, conectores de nuvem, ou aumentar a quantidade de ferramentas só por aumentar.
Onde ele está atrás hoje
A pontuação bruta de recuperação fica abaixo das ferramentas que fazem rerank, e o envelhecimento da memória ainda não tem resultado medido. A lista completa está na página de comparação.
“A 1.x provou que a ideia funcionava. A 2.0 é a versão que eu recomendaria sem asterisco pra outra pessoa botar num time.”
Perguntas e respostas
O que é a ideia da LLM Wiki do Karpathy por trás do ai-memory?
O gist de abril de 2026 do Andrej Karpathy descreve um LLM que constrói e mantém uma wiki persistente de arquivos markdown entre você e as suas fontes brutas, de modo que o conhecimento é compilado uma vez e mantido atualizado. O ai-memory aplica isso a agentes de código, com captura automática pelos hooks de ciclo de vida e um caminho padrão que não faz chamadas a LLM.
O ai-memory é compatível com o Open Knowledge Format?
Desde a 2.0 todo projeto da wiki é nativamente um bundle OKF v0.2. Cada página tem frontmatter YAML com um type, cada projeto tem um index.md gerado, e o ai-memory export-okf empacota um projeto num tarball validado.
O que o benchmark LongMemEval-S mede no ai-memory?
Só recuperação: se uma sessão que contém a evidência aparece entre os primeiros resultados, em 470 perguntas. O hit@5 é 0,815 com os embeddings locais padrão e 0,666 só com full-text. Ele não mede a acurácia das respostas.
Leia o raciocínio. Depois teste.
Gratuito e open source. A instalação padrão não faz chamadas a LLM e escuta só na sua máquina.