
開発者
詳細セットアップとインフラ
サーバーをノートPCの外で動かすときのためのページです。各トピックは、図または表、正しく動く最短の設定、GitHub上の完全なドキュメントへのリンクで構成しています。
動かせる場所は4つ
バイナリは4つとも同じです。変わるのはバインドアドレスで、それに応じて必要な認証と暗号化の水準が変わります。
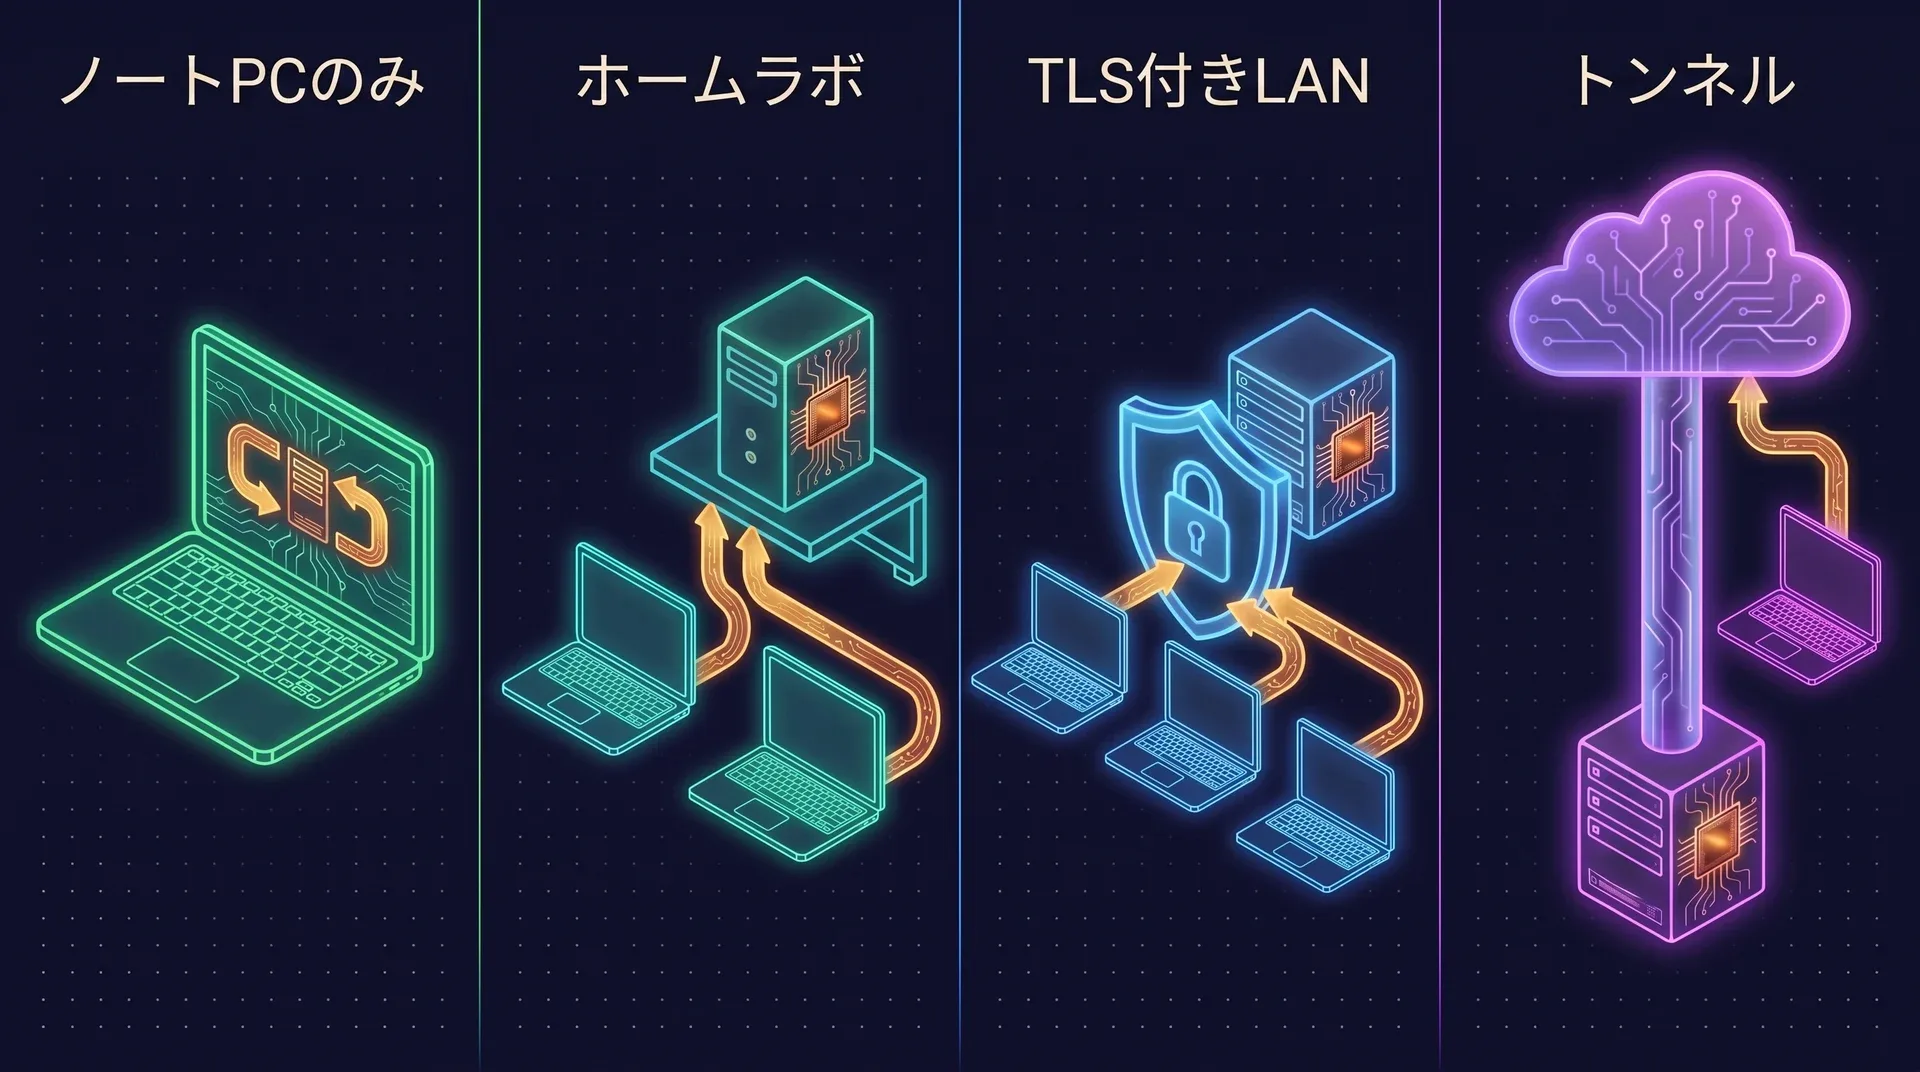
| 構成 | バインド | 認証 | TLS | 実行形態 |
|---|---|---|---|---|
| ノートPCのみ | 127.0.0.1:49374 | 不要 | 不要 | systemdユーザーユニット、launchdエージェント、またはコンテナ |
| ホームラボのマシン | 0.0.0.0:49374 | ベアラートークンとホスト許可リスト。どちらも必須 | 推奨 | ヘルスチェック付きのDocker、またはAURのシステムサービス |
| TLS付きのLAN | プロキシの背後で0.0.0.0:49374 | rootトークンに加え、1人ずつユーザーとAPIキーを発行 | 必要。Caddyの内部CAならドメインなしで使えます | CaddyサイドカーつきのDocker Compose |
| トンネル | ホスト側のポートは公開しない | LANサーバーと同じ | 必要。Cloudflareのエッジで終端します | cloudflaredサイドカーつきのDocker Compose |
ノートPCならai-memory serve --transport stdioでHTTPを使わずに済みます。ホームラボ向けには、composeとenvのテンプレートを備えたbin/deployスクリプトがリポジトリに入っています。ホームラボへのデプロイ手順を見る。
リバースプロキシでTLSを終端する
ai-memoryは設計上、自分ではTLSを終端しません。ベアラートークンが行うのはリクエストの認証で、暗号化は行いません。
TLSを省略できる場合
- エージェントがstdioで通信している
- サーバーがループバック専用かつ1人用で、別のマシンから
/webを開く人がいない - ローカル開発や一度きりの実験である
TLSが必要な場合
- アカウントがある。
aim_キーがネットワークを流れるためです - サーバーをループバックの外にバインドしている
- 別のマシンから
/webを開く - LANの外からサーバーに到達できる
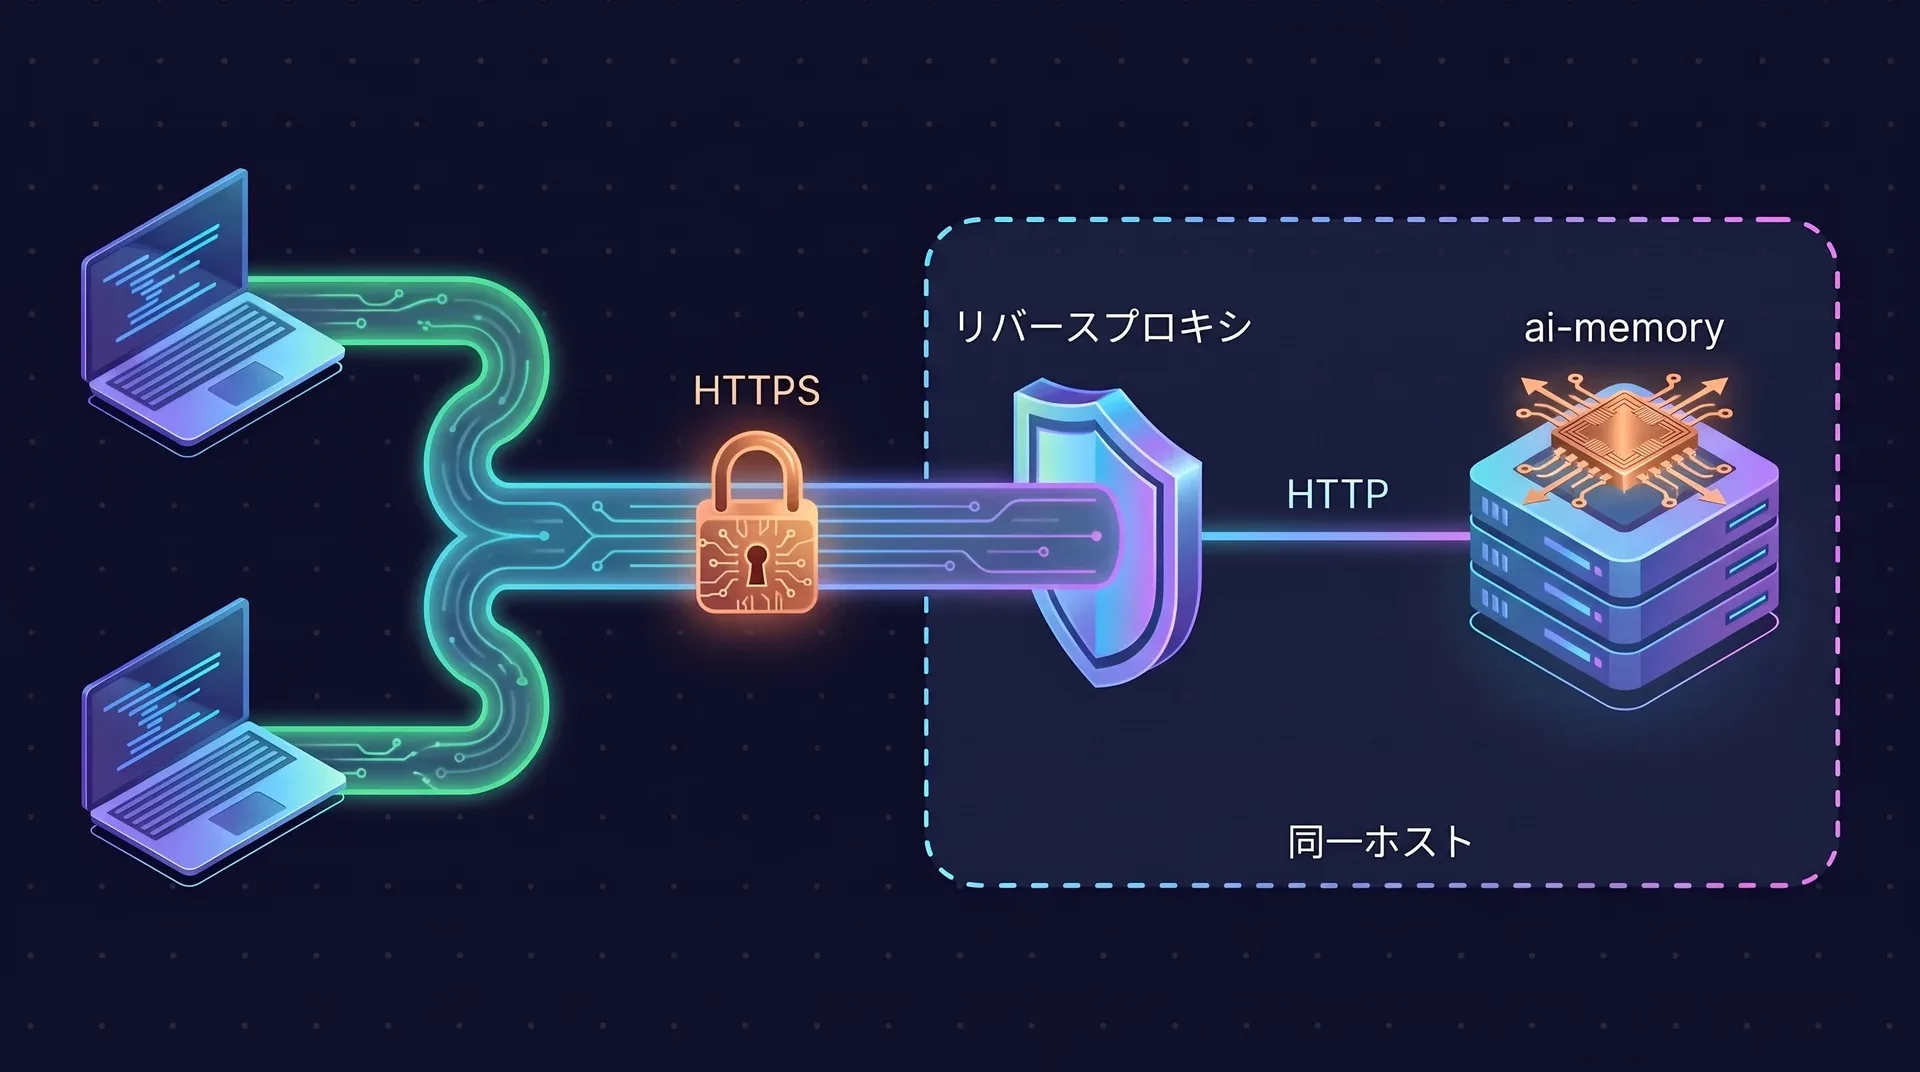
公開ドメインがあり、ポート80と443に外から到達できる場合の構成です。Let’s Encryptの証明書はCaddyが自動で発行、更新します。完全なcomposeファイルはリポジトリのdocker/compose.tls.caddy.ymlにあります。
memory.example.com {
    reverse_proxy ai-memory:49374
}
ドメインなし、外部公開なしの構成です。Caddyの内部CAが証明書に署名するので、そのルート証明書をすべてのクライアントマシンに一度だけインストールします。この手順を省くと、クライアントは接続を拒否するか、利用者が警告を無視してクリックする癖をつけることになります。
{
    local_certs   # LEの代わりに内部CAを使うようCaddyに指示する
}

homelab.local, 192.168.1.50 {
    reverse_proxy ai-memory:49374
}
docker compose exec caddy cat /data/caddy/pki/authorities/local/root.crt > caddy-root.crt
すでにnginxを運用していて、証明書ファイルが手元にある場合の構成です。MCPのstreamable HTTPトランスポートには、HTTP/1.1と空のConnectionヘッダーが必要です。
server {
    listen 443 ssl http2;
    server_name memory.example.com;

    ssl_certificate     /etc/nginx/certs/memory.crt;
    ssl_certificate_key /etc/nginx/certs/memory.key;

    location / {
        proxy_pass http://ai-memory:49374;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
アウトバウンド専用のトンネルなので、ルーターのポートを開ける必要がありません。Cloudflareで管理するドメインが必要で、無料プランで足ります。ダッシュボードで公開ホスト名をhttp://ai-memory:49374に向けてください。完全なcomposeファイルはdocker/compose.tls.cloudflared.ymlです。
cloudflared:
    image: cloudflare/cloudflared:latest
    container_name: ai-memory-tunnel
    restart: unless-stopped
    command: tunnel --no-autoupdate run
    environment:
      - TUNNEL_TOKEN=${CLOUDFLARE_TUNNEL_TOKEN}
次にサーバーへ設定する
許可リストには公開ホスト名を含めてください。含めないと、DNSリバインディング対策がプロキシからのリクエストを拒否します。ループバックの外のリスナー経由でログインする人がいる場合は、secure cookieの設定が必須です。
AI_MEMORY_AUTH_TOKEN=...long-random-token-from-generate-auth-token...
AI_MEMORY_AUTH__SECURE_COOKIE=true
AI_MEMORY_ALLOWED_HOSTS=memory.example.com,localhost,127.0.0.1
AI_MEMORY_BIND=0.0.0.0:49374
クライアントの接続先を変える
MCPのURLは末尾が/mcpです。フックのURLはオリジンのみです。
ai-memory install-mcp   --client claude-code --apply \
    --server-url "https://memory.example.com/mcp" --auth-token "$AI_MEMORY_AUTH_TOKEN"
ai-memory install-hooks --agent  claude-code --apply \
    --server-url "https://memory.example.com" --auth-token "$AI_MEMORY_AUTH_TOKEN"
サーバーを動かし続ける
ai-memoryは自分では再起動しません。再起動は各OSのサービスマネージャーに任せます。
1人で使うワークステーション向けです。ユニットはAURパッケージがインストールします。sudoは不要で、状態は~/.local/share/ai-memoryに保存されます。lingeringを有効にしない限り、ユーザーユニットはログアウト時に止まります。
systemctl --user daemon-reload
systemctl --user enable --now ai-memory.service
systemctl --user status ai-memory.service
journalctl --user -u ai-memory.service -f

# ログアウト後も動かし続ける
loginctl enable-linger "$USER"
共有ワークステーションやLAN上のマシン向けです。データは/var/lib/ai-memory、設定は/etc/ai-memory/config.toml、シークレットは/etc/ai-memory/envに置かれます。同じバインドアドレスで両方のユニットを動かさないでください。
sudo systemd-sysusers /usr/lib/sysusers.d/ai-memory.conf
sudo systemd-tmpfiles --create /usr/lib/tmpfiles.d/ai-memory.conf
sudo -u ai-memory ai-memory \
  --data-dir /var/lib/ai-memory \
  --config /etc/ai-memory/config.toml \
  init

sudo systemctl daemon-reload
sudo systemctl enable --now ai-memory.service
journalctl -u ai-memory.service -f
macOS用のtarballには、プレースホルダーが2つ入ったLaunchAgentのplistが含まれています。展開したtarballの中で次を実行してください。LaunchAgentはログアウト時に止まり、macOSにはlingeringに相当する仕組みがありません。2つのログファイルはローテーションされません。
mkdir -p ~/Library/Logs/ai-memory
AI_MEMORY_BIN=~/Applications/ai-memory/ai-memory

sed -e "s|__AI_MEMORY_BIN__|$AI_MEMORY_BIN|" \
    -e "s|__HOME__|$HOME|" \
    packaging/launchd/com.github.akitaonrails.ai-memory.plist \
    > ~/Library/LaunchAgents/com.github.akitaonrails.ai-memory.plist

launchctl bootstrap gui/$(id -u) \
    ~/Library/LaunchAgents/com.github.akitaonrails.ai-memory.plist
ai-memoryにはWindowsサービスのディスパッチャーがないため、exeを指定したsc createは動きません。Start-Processを使ったタスクスケジューラのタスクも、次の再起動で止まります。そこでWinSWでラップします。パスは絶対パスで書いてください。サービスはLocalSystemとして動くので、%LOCALAPPDATA%は別のプロファイルに展開されてしまいます。
<service>
  <id>ai-memory</id>
  <name>ai-memory MCP server</name>
  <description>Long-term memory server for AI coding agents.</description>
  <executable>C:\Users\you\AppData\Local\ai-memory\ai-memory.exe</executable>
  <arguments>--data-dir "C:\Users\you\AppData\Local\ai-memory" serve --transport http --bind 127.0.0.1:49374</arguments>
  <startmode>Automatic</startmode>
  <onfailure action="restart" delay="5 sec"/>
  <log mode="roll"/>
</service>
& "$Dest\ai-memory-service.exe" install
& "$Dest\ai-memory-service.exe" start
& "$Dest\ai-memory-service.exe" status
データディレクトリとバックアップ
正はwikiです。中身はgitリポジトリに入ったプレーンなmarkdownで、検索インデックスはそこから生成されます。
reindexは、ページ、リンク、全文検索をwikiから再構築します。セッション、オブザベーション、引き継ぎ、ユーザー、キー、監査の行、埋め込みは復元されないため、データベースもバックアップに含める必要があります。
| ディレクトリ | 中身 | 種類 | バックアップする? |
|---|---|---|---|
wiki/ | markdownで書かれたすべてのページ。1つのgitリポジトリに入っています | 正 | はい。バックアップのtarballに含まれます。rsyncやgit pushでも退避できます |
raw/ | マネージド起動で記録した、サニタイズ済みで変更不可のトランスクリプト断片 | 正 | ai-memory runを使っているなら、はい。別途コピーしてください |
db/ | memory.sqlite: 全文検索インデックス、エンティティ、埋め込み、セッション、ユーザー、監査の行 | 大部分が派生 | はい。ページ、リンク、検索はwikiから再構築できます。セッション、引き継ぎ、ユーザー、キーはここにしかありません |
models/ | ローカルの埋め込みモデル。約87 MB | 再取得可能 | いいえ。再ダウンロードされます。自分でファイルを置くこともできます |
logs/ | ローテーションされるトレース出力 | 破棄可能 | いいえ |
デフォルトの場所: Linuxでは~/.local/share/ai-memory、macOSでは~/Library/Application Support/ai-memory、Windowsでは%LOCALAPPDATA%\ai-memory、コンテナ内では/dataです。AI_MEMORY_DATA_DIRで変更できます。
バックアップとリストア
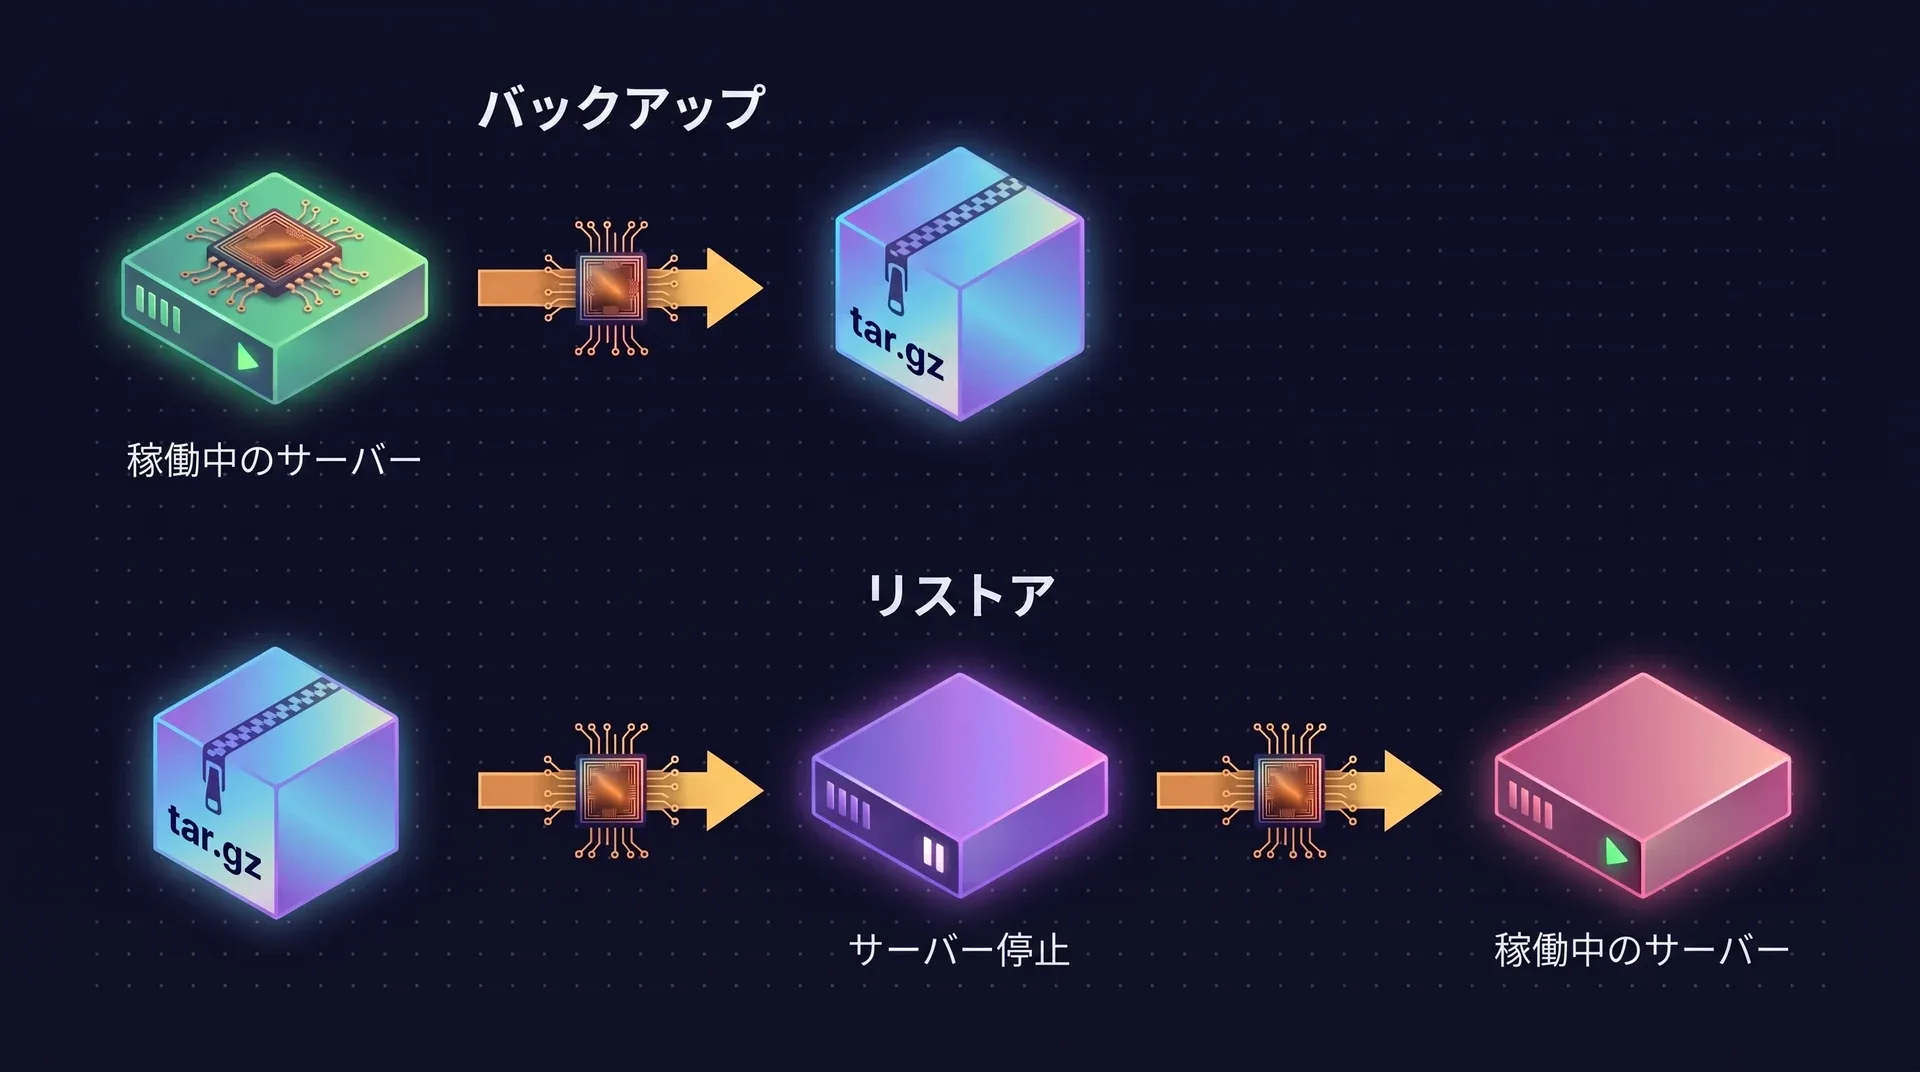
バックアップ
SQLiteのオンラインバックアップAPIを使うので、スナップショット中に書き込みがあっても整合性が保たれます。tarballには、wikiのツリー、データベースのスナップショット、config.tomlが入ります。
# サーバー稼働中でも安全
ai-memory backup --to /tmp/ai-memory-backup.tar.gz
リストア
--data-dirには、ボリュームのホスト側のパスを指定します。ここに書いたパスはデプロイガイドのものです。自分の環境のパスに置き換えてください。
# 先にサーバーを止める。
docker compose -f ~/deploy/ai-memory/docker-compose.yml down
# リストアする(コンテナがまだ動いているとsysinfoが拒否する)。
ai-memory restore --from /tmp/ai-memory-backup.tar.gz --data-dir /var/opt/docker/utils/ai-memory/data --force
# 起動し直す。
docker compose -f ~/deploy/ai-memory/docker-compose.yml up -d
ルーティングとアイデンティティ
共有サーバーは2つの問いに答える必要があります。このセッションはどのプロジェクトのものか。そして、リクエストしているのは誰か。
マーカーファイル
デフォルトでは、現在のディレクトリ名がプロジェクトになり、defaultというワークスペースに入ります。変更するには、上位のいずれかのディレクトリに.ai-memory.tomlを置きます。フックは作業ディレクトリから上へたどり、最初に見つけたマーカーを使います。
仕事用と個人用
親ディレクトリごとにマーカーを1つ置きます。その下のリポジトリはすべてそのワークスペースに入り、ディレクトリ名がプロジェクトになります。
# ~/projects/movvia/.ai-memory.toml
workspace = "movvia"

# ~/personal/.ai-memory.toml
workspace = "personal"
モノレポ
projectを指定したマーカーは、すべてのサブディレクトリをその1つのプロジェクトに固定します。最も近いマーカーが優先されます。
# ~/projects/movvia/pe-portais/.ai-memory.toml
workspace = "movvia"
project = "pe-portais"
gitのワークツリー
リンクされたワークツリーとサブディレクトリは、メインのリポジトリに解決されます。ワークツリーがリポジトリの外にあっても同じです。
# ~/projects/.ai-memory.toml
workspace = "oss"
project_strategy = "repo-root"
同じファイルに、ignore_pathsを使う[capture]ルールも書けます。ai-memory install-hooks --apply --capture-mode allowlistを実行するとマーカーがオプトインの印になり、マーカーのないリポジトリはイベントを一切送りません。ネイティブフックはどちらも強制します。Dockerラッパーのシェルフックは強制しません。マーカーファイルのリファレンスを読む。
自動スコープのモード
プロジェクトを明示しないMCP呼び出しは、「現在のプロジェクト」ポインターを通して解決されます。そのポインターを誰が共有するかを決めるのがモードです。サーバーは起動時に、有効なモードをログに出力します。
| モード | 使いどころ |
|---|---|
per_actor | デフォルトです。1台のサーバー上で、並行して動くハーネスや別々の利用者を分離します。 |
per_session | MCPリクエストのたびにフックのセッションIDを転送する、セッション対応クライアント向けです。 |
single | v1.39より前の挙動です。プロセス全体でスロットは1つ、最後の書き込みが勝ちます。共有サーバーでは安全ではありません。 |
[auto_scope]
mode = "per_actor"        # "per_actor"(v1.39以降のデフォルト)| "per_session" | "single"
session_ttl_secs = 3600   # キーごとのエントリのTTL(デフォルトは1時間)
max_entries = 4096        # 上限値。挿入が古いものから破棄される
SSOとOIDC
各開発者は、OIDCのデバイスフローで一度だけログインします。Keycloak、Okta、Entra IDなど、標準に準拠した発行者ならどれでも使えます。静的なベアラートークンが設定されていない場合、このトークンがネイティブのライフサイクルフックとCLIコマンドを認証します。
ai-memory auth login oidc-device \
  --issuer "https://issuer.example.com/realms/team" \
  --client-id "ai-memory-cli"
オフライン、上限、アップグレード
セキュリティレビュー、キャパシティ計画、メンテナンス時間帯のそれぞれで必要になる情報です。
エアギャップ環境へのインストール
バイナリ
すべてのリリースアセットに.sha256ファイルが付いています。ネットワークにつながるマシンでダウンロードして検証し、持ち込んでください。リリースに付くのはチェックサムだけで、SLSAのプロベナンスやアーティファクトのアテステーションはありません。
ソースからのビルド
SQLiteは同梱、libgit2はベンダリングされているので、ビルドに必要なのはCツールチェーンとcratesのミラーです。cargo vendorも使えます。
埋め込みモデル
デフォルトのインストールでは、初回起動時にHugging Faceからモデルを取得します。外向きのリクエストを一切出さないようにするには、あらかじめmodel.safetensors、tokenizer.json、config.jsonを<data_dir>/models/all-MiniLM-L6-v2/に置いてください。チェックサムはソースコード内に固定されています。
バイナリにテレメトリはありません。Dockerラッパーは、新しいイメージがないかDocker Hubを最大で24時間に1回確認します。AI_MEMORY_NO_VERSION_CHECK=1で無効にできます。エアギャップ環境での更新は、インストールと同じく手作業です。オフラインインストールのページを読む。
キャパシティ
すべての書き込みは1つのライターを通ります。その限界を、プロジェクトはcargo test -p ai-memory-store --test writer_throughput -- --ignored --nocaptureで計測しました。
| 同時ライター数 | スループット | 平均レイテンシ |
|---|---|---|
| 1 | 42/秒 | 23.9 ms |
| 8 | 295/秒 | 3.4 ms |
| 32 | 698/秒 | 1.43 ms |
| 128 | 700/秒 | 1.43 ms |
- 上限は毎秒約700書き込みで、ライターが32前後のときに達します。
- 書き込みキューの上限は1024です。それを超えると書き込む側が減速しますが、書き込みはすべて反映されます。
- シェルフックは200 msでサーバーへの送信を諦め、イベントをローカルにスプールします。サーバーが遅くてもエージェントは止まりません。
AI_MEMORY_HOOK_RATE_PER_SECとAI_MEMORY_HOOK_RATE_BURSTで、アクターとセッションごとのレート制限を追加できます。デフォルトでは無効です。
アップグレード
ai-memory upgrade
- Dockerラッパーの場合、このコマンドはラッパーを検証して置き換え、イメージをpullし、フックスクリプトを配置し直します。別ホストのサーバーは個別にアップグレードします。
- スキーマとwikiのマイグレーションは起動時に走ります。前方向のみです。古いバイナリはマイグレーション済みのディレクトリを開くことを拒否するので、ロールバックの可能性があるなら先に
ai-memory backupを実行してください。
よくある質問
ai-memoryにTLSは必要ですか?
127.0.0.1にバインドした1人用のノートPCや、stdio経由なら不要です。アカウントがある場合、サーバーをループバックの外にバインドする場合、別のマシンからWeb UIを開く場合、LANの外から到達できる場合は、TLSプロキシを追加してください。ai-memoryは自分ではTLSを終端しません。
何をバックアップすればよいですか?
ai-memory backupを実行してください。サーバー稼働中でも安全です。tarballには、wikiのツリー、整合性のあるSQLiteスナップショット、config.tomlが入ります。信頼できる唯一の情報源はwikiです。ページ、リンク、検索はai-memory reindexでwikiから再構築できますが、セッション、引き継ぎ、ユーザー、キーはデータベースにしかありません。
ai-memoryはSSOに対応していますか?
ライフサイクルフックとCLIコマンド向けに、標準準拠の発行者に対するOIDCデバイス認証をサポートしています。サーバー自身はOIDCトークンを検証しないため、サーバーのAPIをIDプロバイダーの背後に置くには、手前にOIDC対応のゲートウェイが必要です。
2つのサーバーで1つのデータディレクトリを共有できますか?
できません。データディレクトリ1つにつきサーバーは1つです。2.0以降、サーバーは.serve.lockに排他ロックをかけ、2つ目のサーバーは起動を拒否します。