
Producto
Investigación y fundamentos
Cada parte de ai-memory tiene un motivo que puedes comprobar: una idea de la que viene, un bug de una herramienta anterior que evita o una cifra contra la que se midió. Esta página los recorre en seis capítulos cortos.
Compila, no recuperes
En abril de 2026, Andrej Karpathy publicó un breve “idea file” sobre lo que llamó una LLM wiki. ai-memory es esa idea, adaptada a agentes de programación que nunca dejan de producir material.
“El conocimiento se compila una vez y después se mantiene al día, en lugar de volver a derivarse en cada consulta.”
Tres capas
Fuentes en bruto que nunca cambian, una wiki de páginas markdown que mantiene el LLM y un archivo de esquema que le dice al agente cómo funciona la wiki.
Tres operaciones
Ingerir una fuente y actualizar las páginas que toca. Consultar la wiki. Pasarle lint en busca de contradicciones y páginas huérfanas.
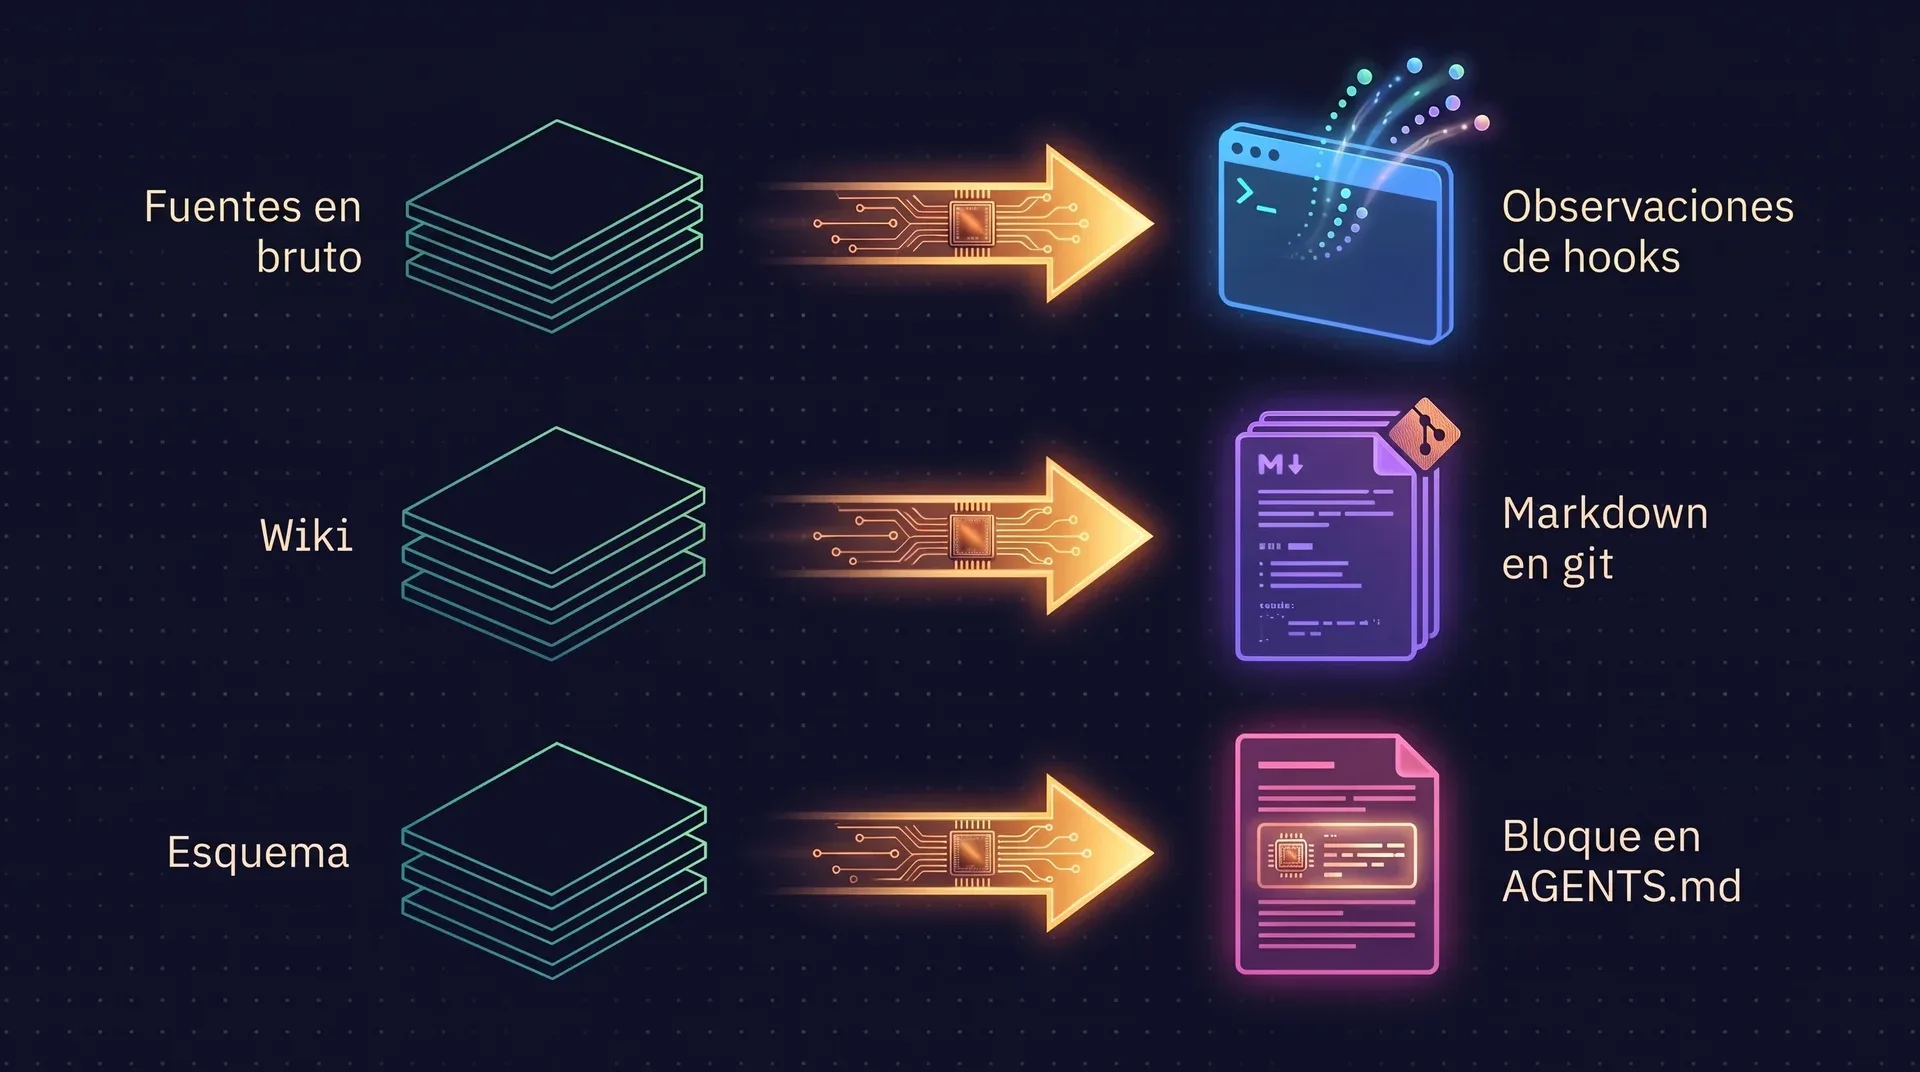
Qué conservó ai-memory
- Archivos markdown en un repositorio git, como aquello que una persona puede abrir, comparar con diff y leer.
- Compilar el conocimiento cuando llega, con una sesión que se reparte en varias páginas.
- Los wikilinks entre páginas como grafo.
- Lint para contradicciones, páginas obsoletas, huérfanas y títulos duplicados.
- Un bloque de esquema instalado en CLAUDE.md o AGENTS.md para que el agente sepa usar la wiki.
Qué cambió
El patrón de Karpathy lo cura una persona, fuente por fuente. Un agente de programación produce material sin parar y nadie lo está mirando.
| En el gist | En ai-memory |
|---|---|
| Le pasas al LLM una fuente cada vez | Los hooks de ciclo de vida capturan cada sesión por su cuenta |
| El agente lee primero index.md | Un índice fusionado: texto completo, entidades, enlaces y vectores |
| Un LLM hace todo el mantenimiento | Resúmenes basados en reglas por defecto. El LLM es opt-in |
| Una persona, una wiki | Traspasos entre agentes, varios usuarios, alcance por proyecto |
| Las páginas viven para siempre | Niveles, decaimiento, reemplazo y TTL dejan fuera las páginas obsoletas |
Los niveles, el decaimiento y el reemplazo no están en el gist de Karpathy. Vienen de agentmemory y de los textos sobre “LLM Wiki v2” que lo rodean. Las notas de lectura completas están en el repositorio.
Tu memoria ya está en un formato abierto
Open Knowledge Format es una especificación que Google Cloud publicó en junio de 2026. Describe el conocimiento como un directorio plano de archivos markdown con frontmatter YAML, un concepto por archivo y un único campo obligatorio: type. No hay SDK ni runtime.
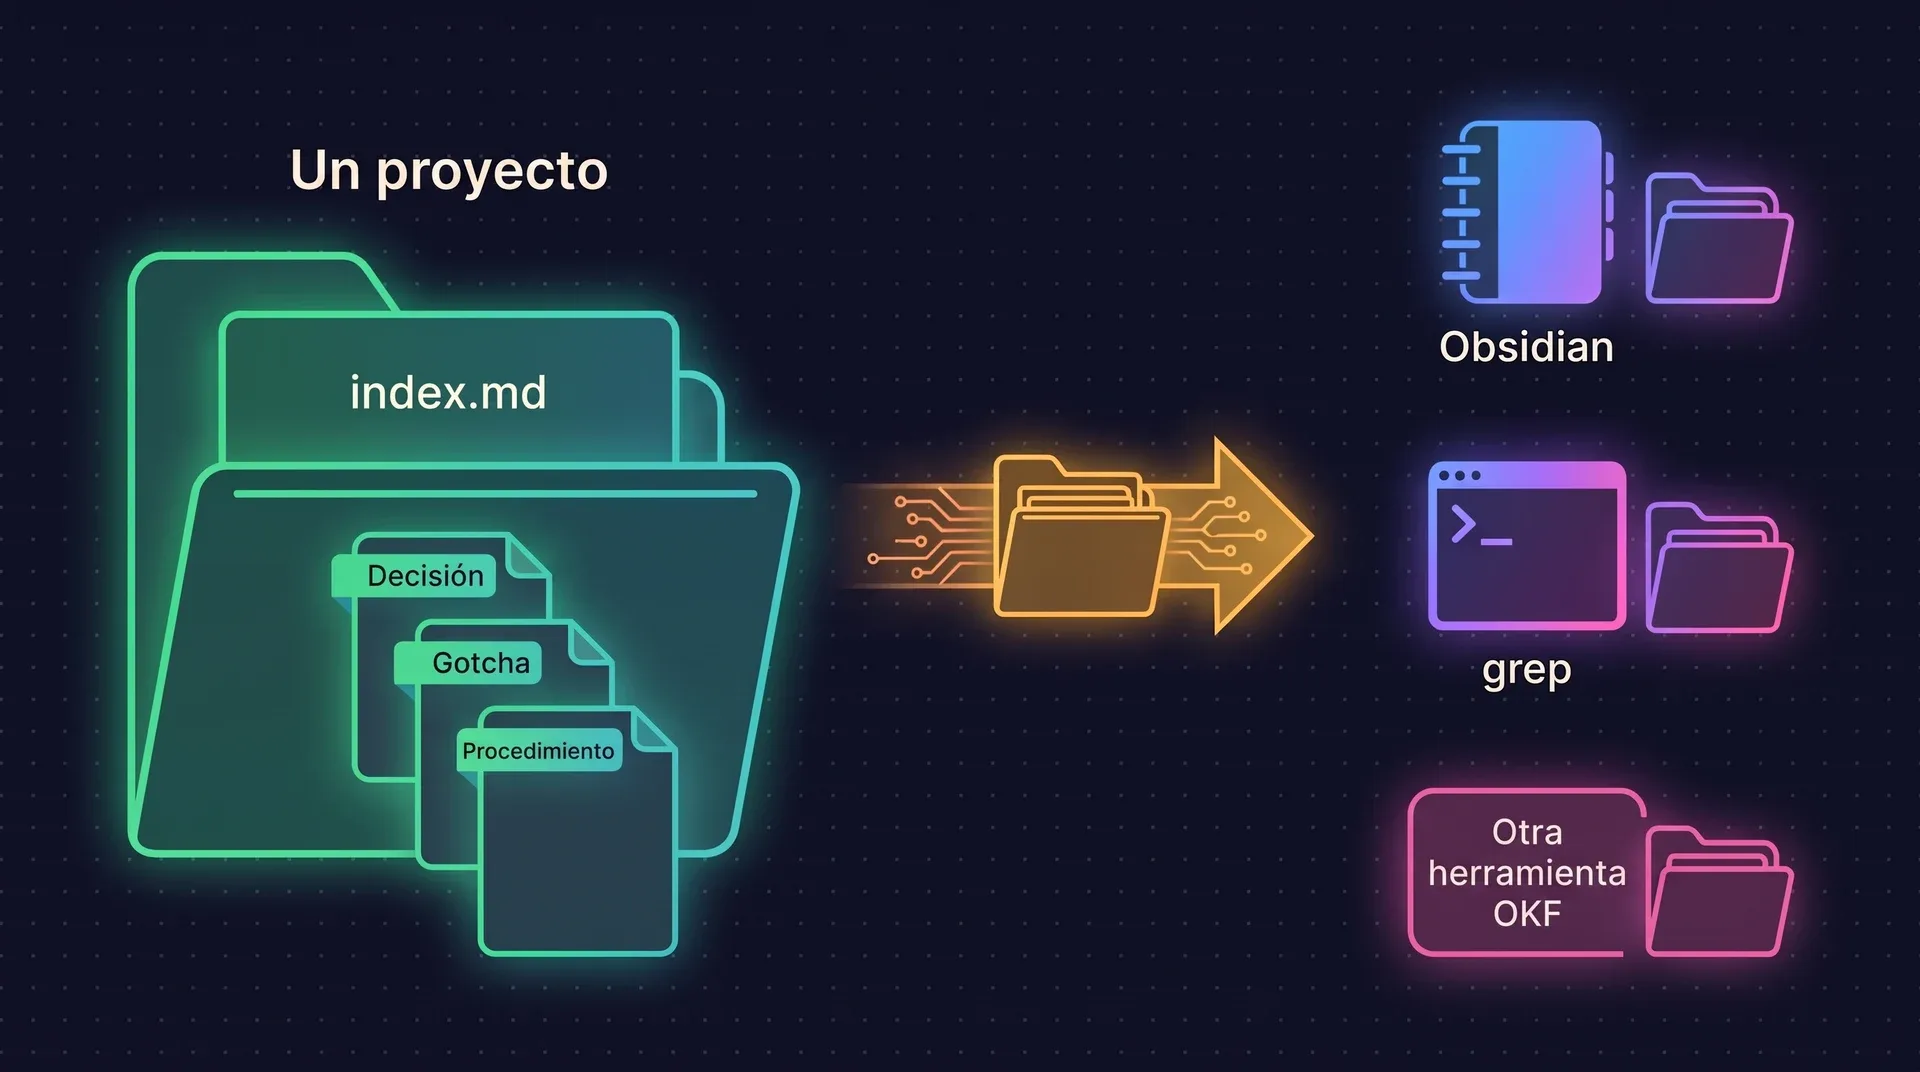
- Desde la 2.0, la wiki es de forma nativa un bundle OKF v0.2. Los archivos con los que trabaja ai-memory son los archivos OKF, así que no hay un paso de exportación que pueda desviarse de la verdad.
- Un proyecto es un bundle, con un
index.mdgenerado en su raíz. - Cada página tiene frontmatter YAML con un
type, derivado de la carpeta en la que vive. - Actualizar desde la 1.x reescribe el frontmatter en el sitio después de una copia de seguridad verificada. Si la copia falla, la migración se detiene.
ai-memory export-okf --project myproject -o myproject-bundle.tar.gz
No hay comando de importación. Descomprime un bundle en el directorio de la wiki de un proyecto y el file watcher lo indexa. El mapeo a OKF está documentado campo por campo, y la especificación vive en el repositorio knowledge-catalog de Google Cloud.
| Carpeta | Tipo OKF |
|---|---|
sessions/ | Session Summary |
decisions/ | Decision |
gotchas/ | Gotcha |
procedures/ | Procedure |
concepts/ | Concept |
_rules/ | Rule |
notes/ | Note |
runbooks/ | Runbook |
_slots/ | Invariant o State |
“El modelo y el harness son alquilados, la memoria del proyecto es tuya.”
Ocho decisiones, y el motivo de cada una
La mayoría se remonta a un issue concreto de una herramienta de memoria anterior.
Elegimos
Markdown en git como la verdad
porque hacer una copia o mudarse es un git clone o un rsync. La base de datos se puede reconstruir desde los archivos, así que la corrupción tiene arreglo, y cualquier herramienta que lea markdown puede leer tu memoria.
Elegimos
Un solo archivo SQLite
porque el texto completo, los vectores empaquetados y las tablas de enlaces viven en un único archivo embebido. Los issue trackers de otros proyectos mostraron cuántos bugs de corrección cuesta sincronizar tres almacenes.
Elegimos
Cero llamadas a LLM por defecto
porque los resúmenes de sesión se basan en reglas, así que una instalación nueva no gasta nada. La lección vino de funciones con LLM activadas por defecto en otros proyectos, que sorprendieron a sus usuarios con facturas de tokens.
Elegimos
Un solo binario
porque SQLite va incluido, libgit2 va vendorizado y el embedder es Rust puro. Un motor sidecar aparte fue el mayor foco de problemas para los usuarios del proyecto al que este sucede.
Elegimos
Sin base de datos de grafos
porque el grafo son tablas SQL: una tabla de enlaces y consultas recursivas. Eso cubre la expansión a un salto y las aristas tipadas sin un motor de grafos embebido que mantener vivo.
Elegimos
Los vectores son opcionales
porque los embeddings locales vienen activados desde la 2.0 y siguen sin ser obligatorios. La búsqueda es coseno por fuerza bruta dentro de SQLite; una extensión vectorial espera hasta que el número de páginas o la latencia la pidan.
Elegimos
Traspasos como protocolo tipado que se reclama una sola vez
porque cada ronda de investigación señaló la transferencia entre agentes como el punto débil de las herramientas anteriores. Un traspaso es un registro tipado que se asocia por directorio, y exactamente una sesión puede aceptarlo.
Elegimos
Páginas en vez de filas de hechos
porque una página sobre una decisión se puede leer, editar y explicar en prosa. Una tabla de hechos extraídos no se puede abrir en Obsidian ni revisar en un diff.
A hombros de otros
El proyecto leyó el código y los issue trackers de las herramientas que llegaron antes, se quedó con las ideas que aguantaron y dejó fuera las partes que se rompían una y otra vez.
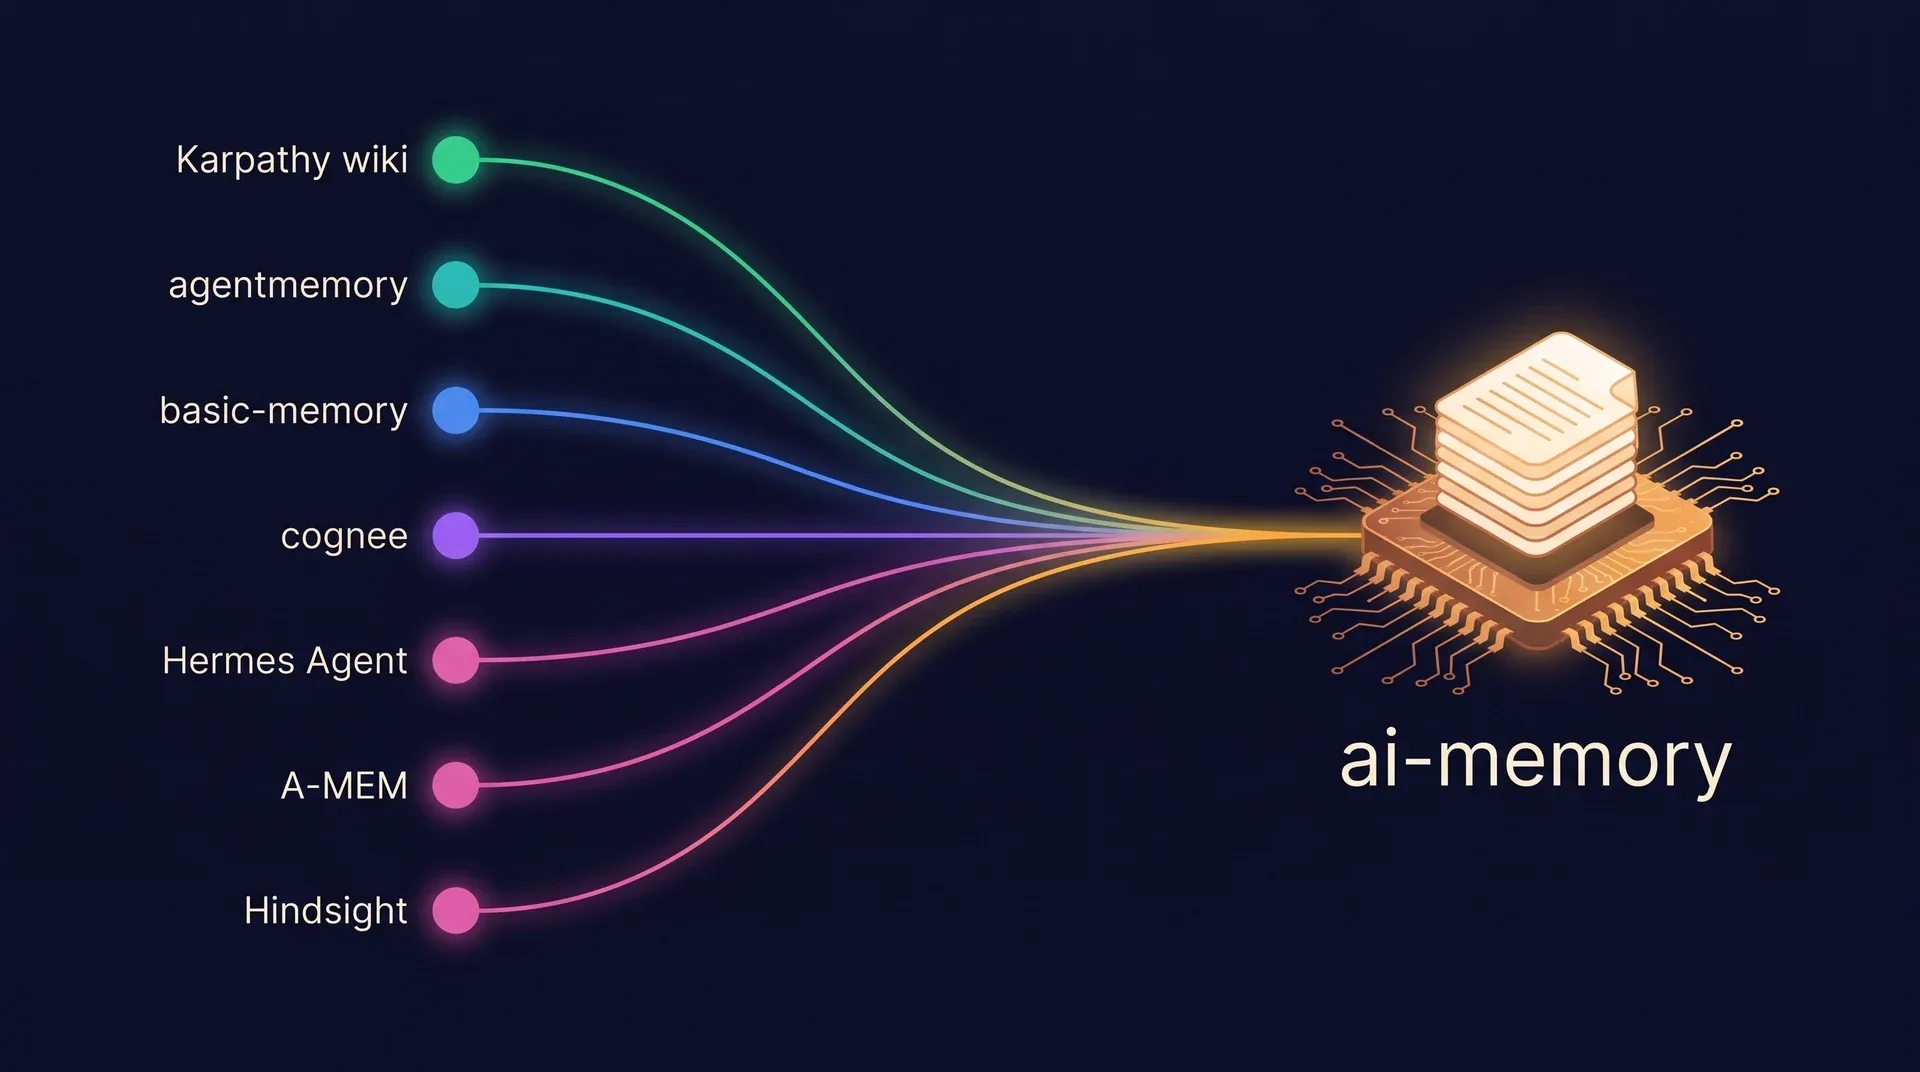
- Karpathy LLM Wiki
- Compila, no recuperes. La wiki en disco es el artefacto.
- agentmemory
- Captura automática con hooks, niveles de memoria, reemplazo, decaimiento como fórmula y ranking fusionado. ai-memory es su sucesor en Rust: las ideas se quedaron, el sustrato cambió.
- basic-memory
- Los archivos como fuente de verdad con un índice derivado, y enlaces hacia páginas que todavía no existen.
- cognee
- La forma del pipeline de tareas, los sellos de procedencia en cada página y el feedback que ajusta el ranking.
- Hermes Agent
- El diseño del bucle de automejora que revisa en segundo plano las sesiones terminadas.
- A-MEM
- Notas atómicas al estilo Zettelkasten que se enlazan entre sí automáticamente.
- Hindsight
- Etiquetas de redacción tipadas, recuentos de evidencia por página y un resumen que abre con las reglas ya asentadas.
- Honcho
- Las respuestas con citas, los niveles de razonamiento y la planificación de la pasada de sueño: disparo por inactividad, cancelación ante actividad, lo más novedoso primero.
Ninguno de estos proyectos avala ai-memory. Para saber dónde va por delante cada uno, mira la comparación.
Qué se midió
El stack de recuperación se evalúa con LongMemEval-S: 470 preguntas sobre historiales de chat largos, pasadas por la ruta real de hooks y la búsqueda real. El harness de evaluación está en el repositorio.
- Solo texto completo, antes de la 2.00,617
- Texto completo con stopwords filtradas0,666
- Más embeddings locales (la opción por defecto)0,815
Qué fue cada paso
- Quitar las stopwords de las consultas de texto completo sumó 5,1 puntos de hit@5 y 8,5 de hit@1.
- El modelo de embeddings dentro del proceso sumó el resto. Acertar con el masked-mean pooling valió por sí solo unos 6,6 puntos.
- En ninguna fila intervienen una clave de API ni un LLM.
| Métrica | Antes de la 2.0 | Texto completo filtrado | Embeddings locales |
|---|---|---|---|
| hit@1 | 0,449 | 0,532 | 0,536 |
| hit@5 | 0,617 | 0,666 | 0,815 |
| recall@5 | 0,472 | 0,536 | 0,677 |
Ejecútalo tú mismo
Añade --candidate-embeddings local al segundo comando para ejecutar texto completo y embeddings locales lado a lado. La ejecución publicada es del 21 de septiembre de 2026, en un Ryzen 9 7950X3D.
cargo build --release -p ai-memory-cli
cargo run --release -p ai-memory-eval -- retrieval --fetch
Resultados completos, por tipo de pregunta
También se midió el rendimiento de escritura. Los números están en la página de arquitectura.
Qué aportan los embeddings locales, y qué cuestan
Las mismas 470 preguntas, ejecutadas dos veces: primero solo con texto completo y luego con el modelo local de embeddings por defecto. Los embeddings encuentran la evidencia entre los diez primeros resultados con mucha más frecuencia, y añaden unos 90 ms a cada consulta.
| Métrica | Texto completo, sin LLM | Embeddings locales | Cambio |
|---|---|---|---|
| hit@1 | 0,532 | 0,536 | +0,004 |
| hit@5 | 0,666 | 0,815 | +0,149 |
| hit@10 | 0,694 | 0,891 | +0,198 |
| recall@10 | 0,564 | 0,817 | +0,254 |
| Tiempo de consulta, mediana | 5 ms | 94 ms | +89 ms |
| Tiempo de consulta, percentil 95 | 40 ms | 162 ms | +122 ms |
| Tokens de contexto por consulta, media | 350,3 | 415,7 | +65,4 |
- Dos ejecuciones completas sobre el mismo commit obtuvieron 0,815 y 0,821, así que conviene leer hit@5 como aproximadamente 0,82, más o menos 0,005. La ejecución anterior, del 1 de septiembre de 2026, obtuvo 0,823, que es el mismo resultado. El envejecimiento de la memoria viene desactivado por defecto, así que la búsqueda por defecto no cambió.
- Dentro de una misma ejecución el harness es determinista: ejecutar una configuración dos veces da una precisión y un número de tokens idénticos. Entre ejecuciones separadas, los tipos de pregunta más pequeños se mueven hasta 0,03 en cualquier dirección, así que una caída en uno de ellos en una sola ejecución significa poco.
Qué viene después, y dónde va por detrás
Son recomendaciones documentadas en el repositorio. Ninguna tiene fecha.
Lo siguiente recomendado
Precisión de las respuestas a escala completa
El segundo harness ya tiene una ejecución completa de recuperación, con precisión, tiempo de consulta y tokens de contexto. Su modo de precisión de respuestas solo cuenta por ahora con una muestra de 20 preguntas, y los puntos de abajo dependen de él.
Un reranker local
Un cross-encoder que corre dentro del proceso, sin LLM. Espera a que el harness de arriba demuestre que vale la pena.
Valores por defecto respaldados por cifras
La puntuación de confianza y las funciones de envejecimiento se publican desactivadas. Cada una pasa a ser valor por defecto solo después de que el harness muestre que ayuda. Los tipos de enlace siguen sin peso en el ranking.
Un comando de sync acotado
O una descripción más clara del modelo de un solo servidor, o un ai-memory sync construido sobre la wiki de git.
Un arranque más fácil para quien usa Claude Code
Un importador para quien viene de la memoria integrada de Claude.
No está previsto: una base de datos de grafos, un sistema operativo de memoria que se edita a sí mismo, conectores a la nube ni aumentar el número de herramientas porque sí.
Dónde va por detrás hoy
La puntuación bruta de recuperación queda por debajo de las herramientas que hacen rerank, y el envejecimiento de la memoria todavía no tiene ningún resultado medido. La lista completa está en la página de comparación.
“La 1.x demostró que la idea funcionaba. La 2.0 es la versión que recomendaría sin asterisco a otra persona para ponerla en un equipo.”
Preguntas y respuestas
¿Qué es la idea de la LLM Wiki de Karpathy que hay detrás de ai-memory?
El gist de Andrej Karpathy de abril de 2026 describe un LLM que construye y mantiene una wiki persistente de archivos markdown entre tú y tus fuentes en bruto, de modo que el conocimiento se compila una vez y se mantiene al día. ai-memory aplica eso a los agentes de programación, con captura automática desde los hooks de ciclo de vida y una ruta por defecto que no hace llamadas a un LLM.
¿ai-memory es compatible con el Open Knowledge Format?
Desde la 2.0, cada proyecto de la wiki es de forma nativa un bundle OKF v0.2. Cada página tiene frontmatter YAML con un type, cada proyecto tiene un index.md generado, y ai-memory export-okf empaqueta un proyecto en un tarball validado.
¿Qué mide el benchmark LongMemEval-S en ai-memory?
Solo recuperación: si una sesión que contiene la evidencia aparece entre los primeros resultados, sobre 470 preguntas. hit@5 es 0,815 con los embeddings locales por defecto y 0,666 con solo texto completo. No mide la precisión de las respuestas.
Lee el razonamiento. Después, pruébalo.
Gratis y de código abierto. La instalación por defecto no hace llamadas a un LLM y solo escucha en tu máquina.