
プロダクト
単一バイナリ、markdownファイル、派生インデックス
フックがエージェントの動作をキャプチャします。学んだことはgit上のmarkdownに残ります。SQLiteは、捨てて作り直せる検索インデックスです。このページでは、フックから次のセッションのブリーフィングまでの経路をたどり、設計がまだ手薄な箇所も示します。
単一バイナリ、データディレクトリも1つ。
SQLiteは同梱、libgit2はベンダリング、埋め込み処理はピュアRustです。サイドカーも、データベースサーバーも、運用すべきキューもありません。知っていることはすべて1つのフォルダに入っています。
<data_dir>/
wiki/YAMLフロントマター付きのmarkdownページ。gitリポジトリで管理します。信頼できる唯一の情報源です。db/memory.sqlite派生インデックス。全文、エンティティ、リンク、埋め込み、セッション、監査。WALモード。raw/ai-memory runのマネージドセッションから得た、サニタイズ済みで変更不可のJSONL断片。models/ローカルの埋め込みモデルall-MiniLM-L6-v2。約87 MBで、SHA-256を固定しています。logs/日次でローテーションされるログ出力。config.toml起動時に一度だけ読み込みます。すべての値はAI_MEMORY_*で上書きできます。サーバーはデフォルトで127.0.0.1:49374にバインドします。バックアップはai-memory backupで取るか、wikiをgit pushしたうえでフォルダをrsyncします。
フックから次のブリーフィングまで。
8つのステップのうち7つは、モデルもAPIキーもなしで動きます。LLMのステップは、プロバイダーを設定するまでオフです。
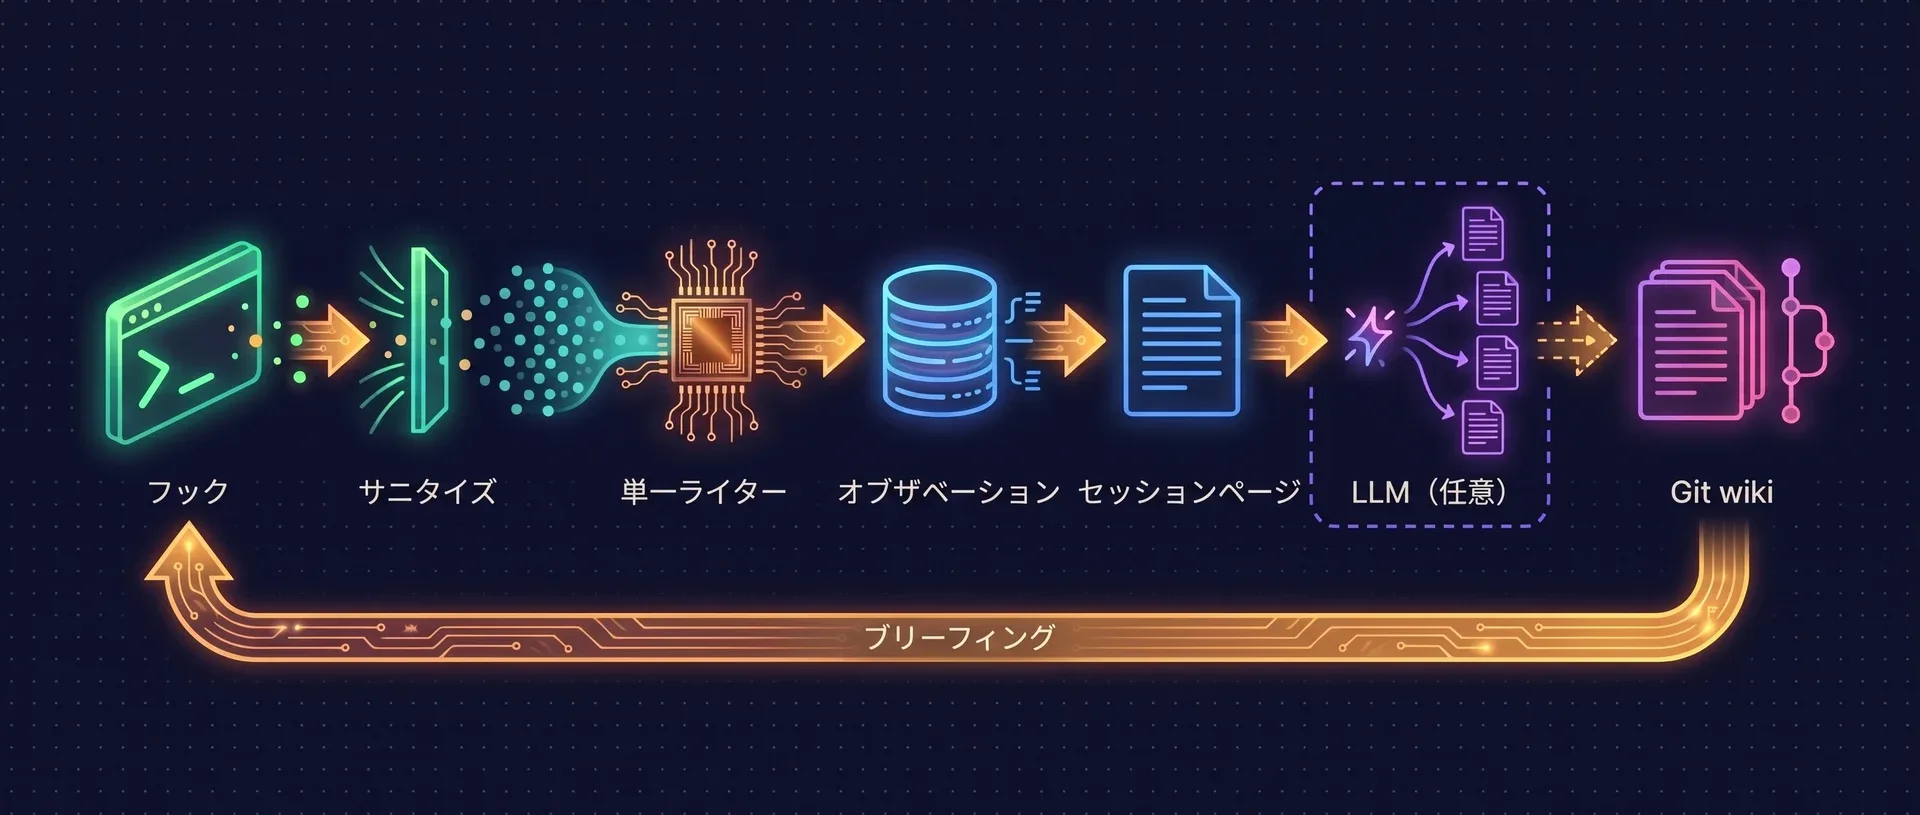
フックLLM不要
エージェントのCLIがライフサイクルフックを発火します。送りっぱなしで、持ち時間は200 msです。ネイティブフックはイベントをローカルにスプールし、切り離されたヘルパーが配送します。サーバーは202を返し、飽和時は429を返します。
サニタイズLLM不要
/hookルーターがシークレットを取り除き、サイズに上限をかけます。信頼できないテキストがストアに入る経路はここだけです。
単一ライターLLM不要
サニタイズ済みのイベントは1本のキューに入ります。キューを処理するのは、唯一の書き込み接続を持つ1つのスレッドです。
オブザベーションLLM不要
イベントは、運用上の監査証跡としてSQLiteに記録されます。これはセッションをサイズ制限つきで投影したもので、完全なトランスクリプトになることはありません。
セッション終了LLM不要
モデルを使わずルールだけで、オブザベーションをsessions/<id>.mdにまとめ、次のエージェント向けのHandoff行を開きます。すべて1つのトランザクションで行います。
統合LLMは任意
プロバイダーを設定している場合、LLMが要約を書き直すか、concepts/、decisions/、gotchas/、procedures/へ展開します。リトライ可能なキューから実行され、フックのレイテンシには影響しません。
コミットとインデックスLLM不要
ページの書き込みはどれもアトミック(tmp、rename、fsync)で、gitにコミットされ、その行と同じSQLiteトランザクションの中でインデックスされます。
クエリとブリーフィングLLM不要
memory_queryがインデックスを検索します。次のSessionStartで、フックはそのディレクトリ向けの未受理の引き継ぎと、構造化されたブリーフィングを取得します。
2つの層、正は1つ。
ファイルとインデックスが食い違ったら、ファイルが正です。
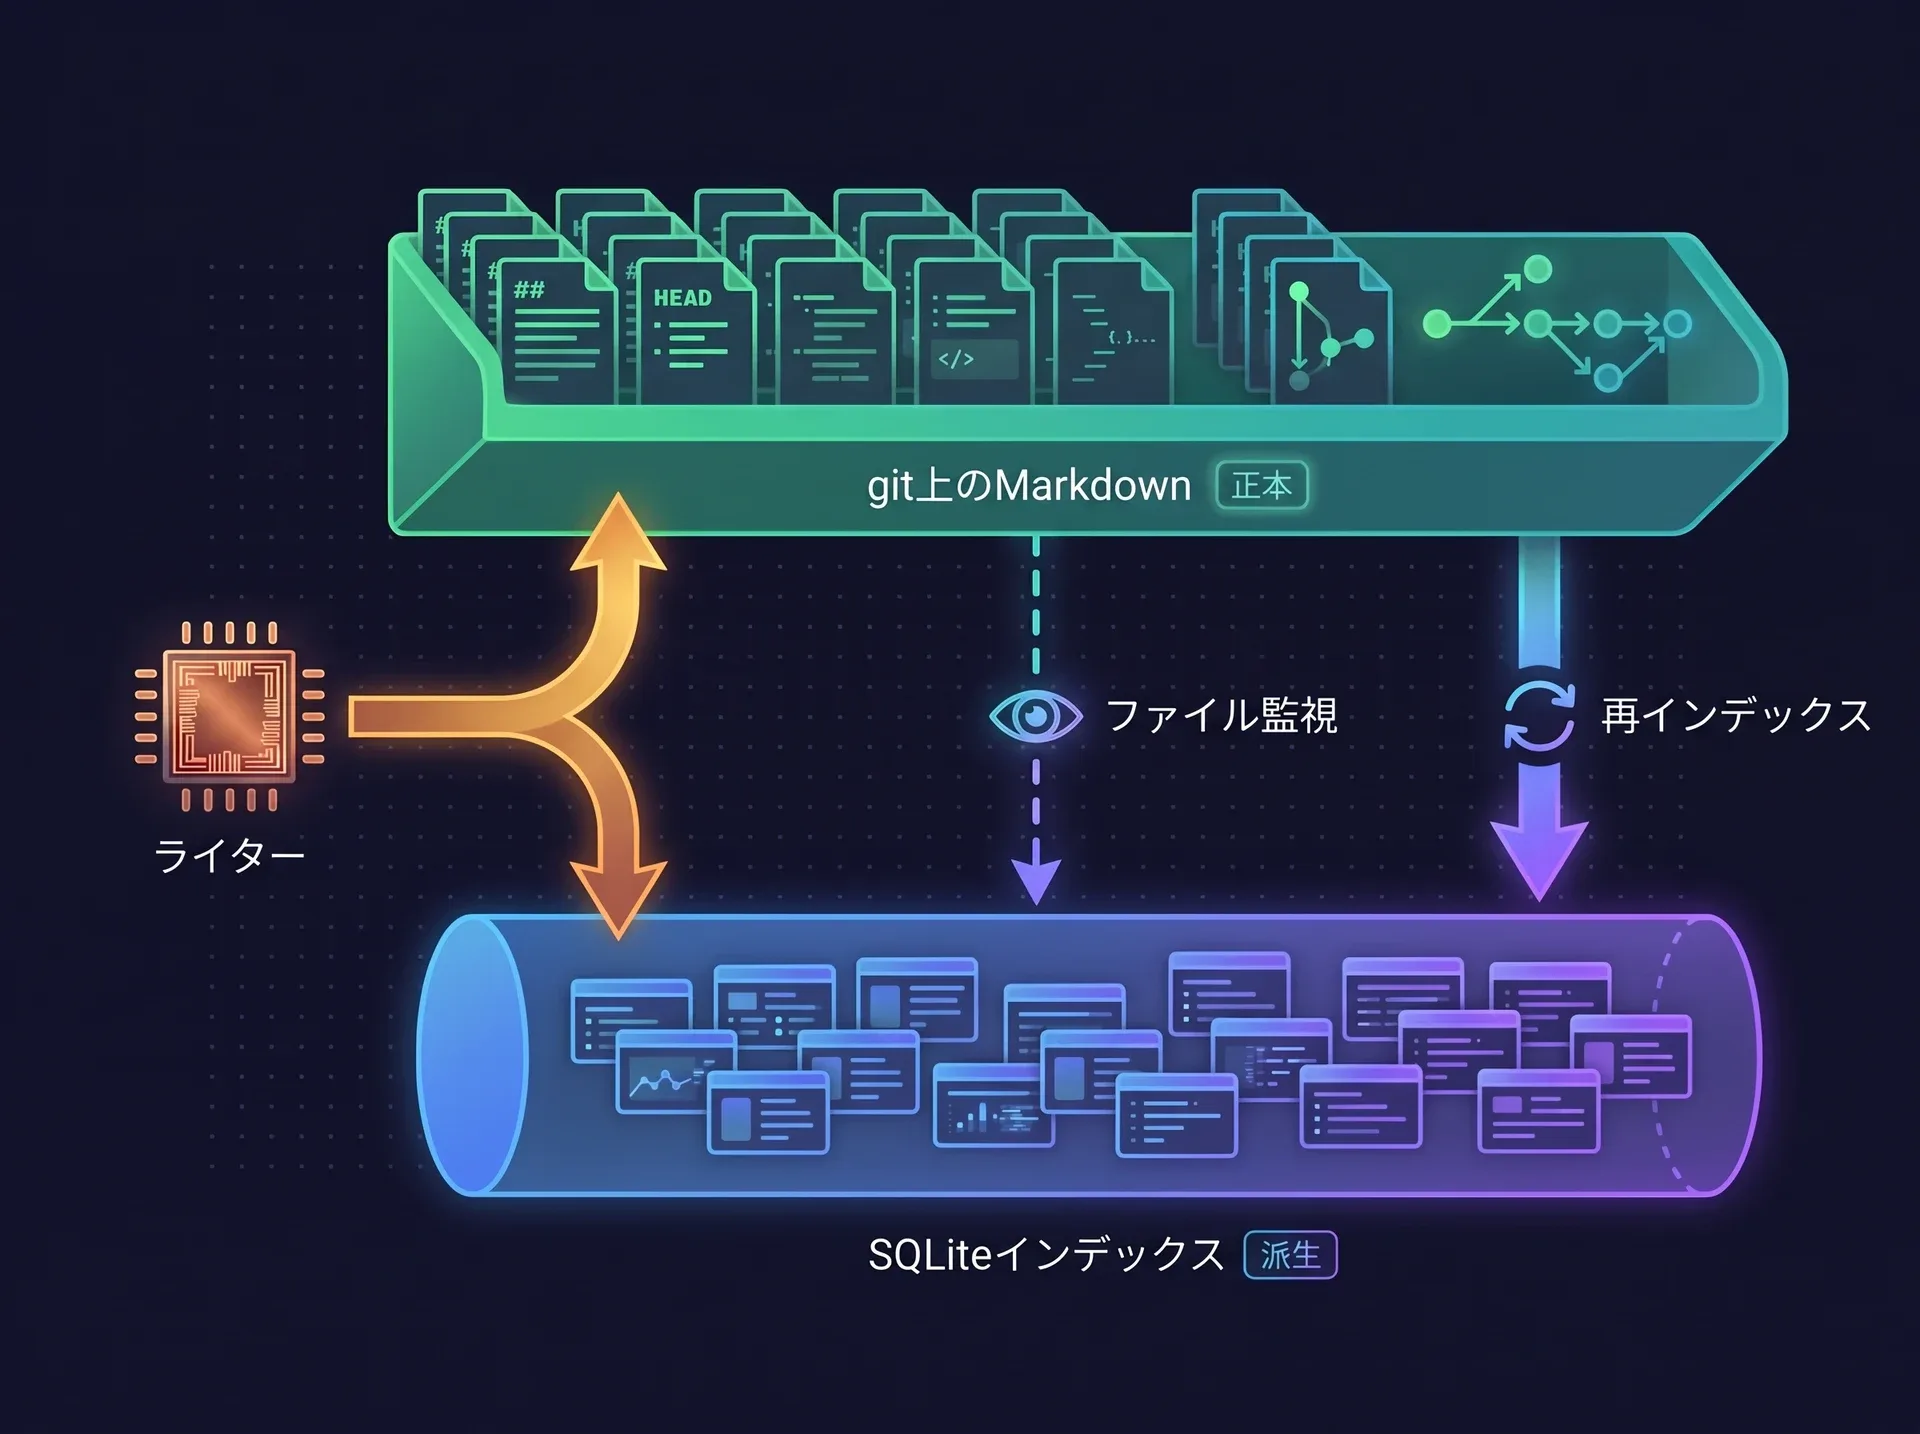
ファイルが正
ページは、wiki/
/ /の下にあるYAMLフロントマター付きのmarkdownです。Obsidianで開くことも、grepすることも、リモートにpushすることもできます。 SQLiteは派生
memory.sqliteの中でページを記述している情報は、すべてai-memory reindexでファイルから再構築できます。インデックスが壊れても復旧できます。
書き込みはサーバーが担う
通常の書き込みはwikiレイヤーを通り、ファイル、git履歴、インデックスがまとめて更新されます。
残りはウォッチャーが拾う
vimやObsidianでの編集は、ファイルウォッチャーが検知します。見逃したイベントは、30秒ごとの全体diffで拾います。
検索: 4つの系統、1つのランキング。
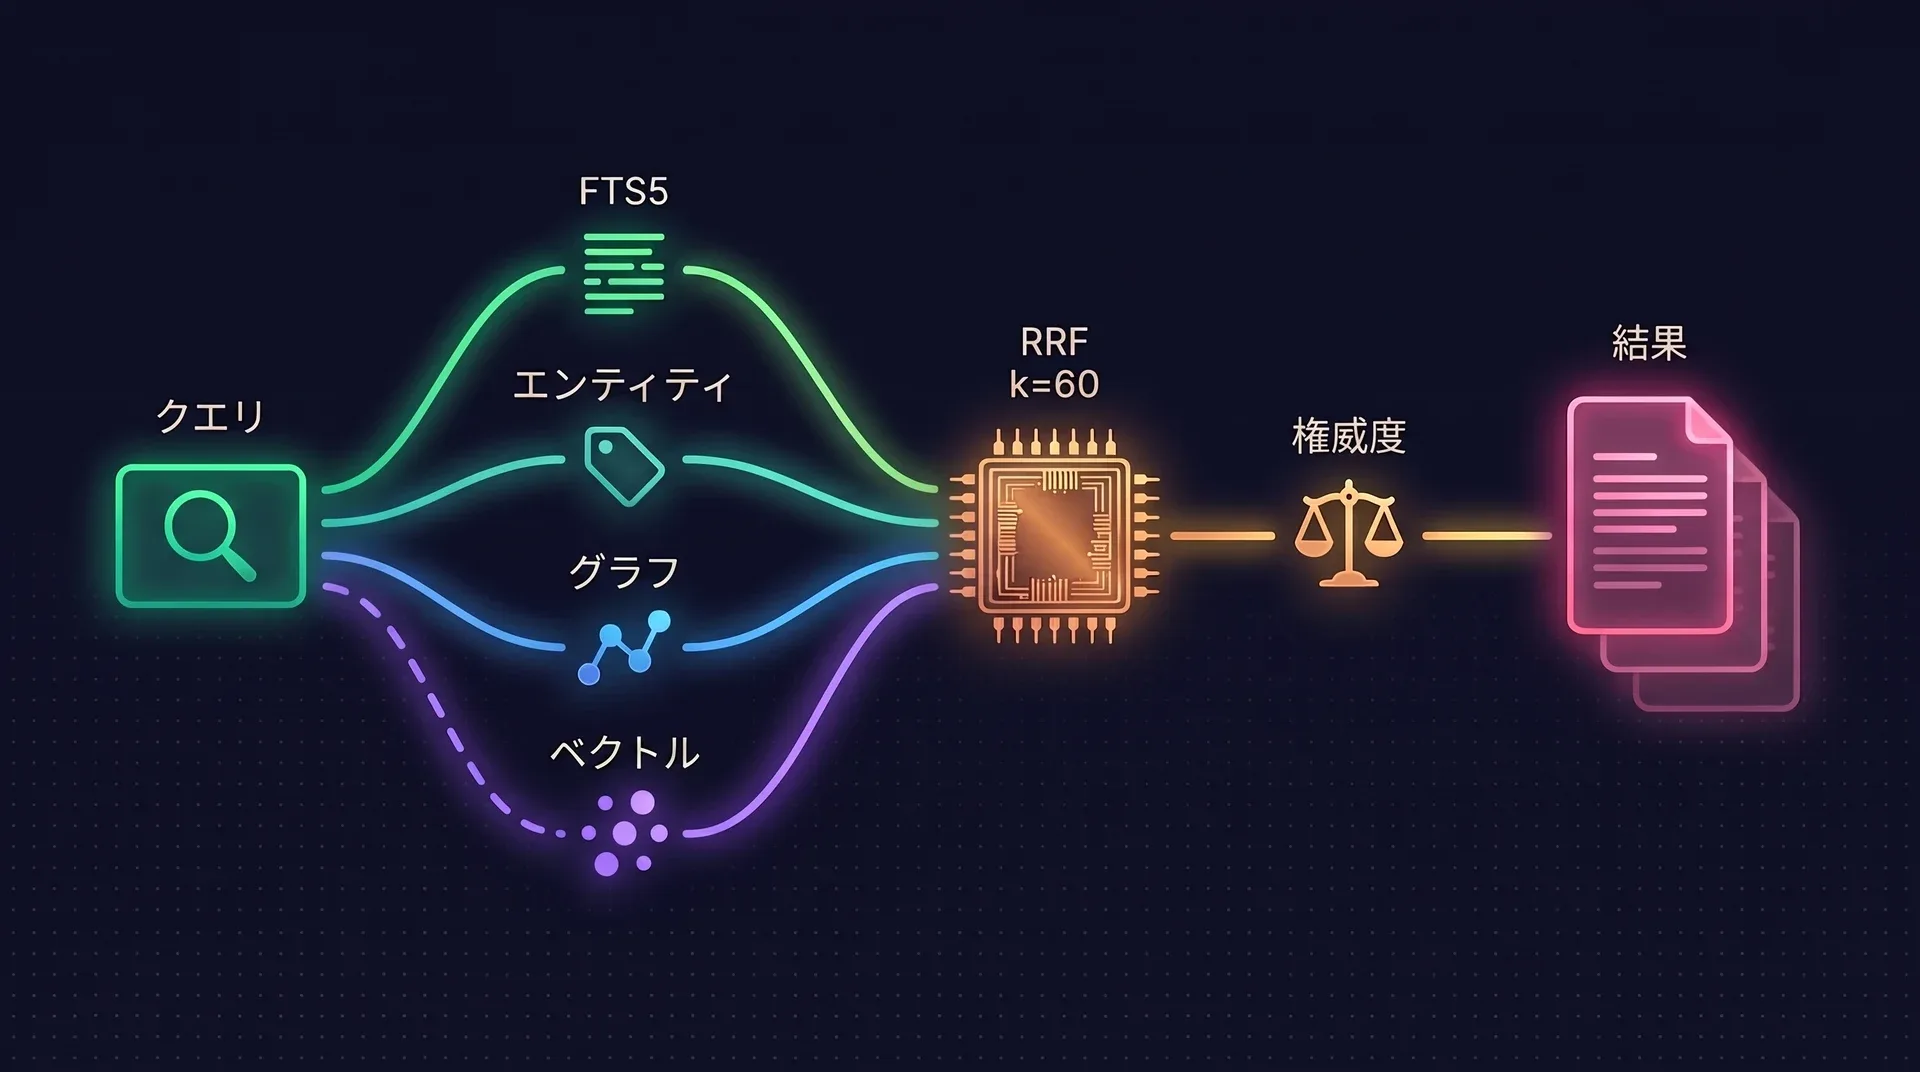
全文検索
ページのタイトルと本文を対象にしたSQLite FTS5です。単純なクエリからはストップワードを除外します。
エンティティ一致
フロントマターのentitiesとtagsにある名前の字句インデックスです。ページ頻度の逆数で重み付けします。
グラフの隣接ページ
linksテーブルを1ホップたどります。対象はwikilink、markdownリンク、型付きエッジ、プロジェクト間リンクです。素のSQLで、グラフデータベースは使いません。
ベクトル(任意)
プロセス内のローカルモデルによる埋め込みのコサイン類似度です。2.0以降はデフォルトで有効ですが、必須ではありません。意図的に総当たりで計算しています。
融合のあと
- k=60のReciprocal Rank Fusionが、各系統を順位ベースで融合します。そのため、どの系統もスコアの較正が要りません。
- 次に、上限つきの権威度の乗数が、僅差の結果を、メンテナンスされているルール、決定事項、手順、落とし穴のページ寄りに調整します。エピソード的なページや過去のページも検索対象のままで、完全に除外されるものはありません。
- 任意のLLMリランク: クエリごとに1回、最大30件のタイトルとスニペットに対して呼び出します。失敗した場合はローカルの順位をそのまま使います。ローカルのリランカーはまだありません。これはプロジェクトで最もよく指摘される不足点です。
- コンパイル済みのページが1件もヒットしない場合は、生のオブザベーションを範囲を限って検索し、raw_hitsを返します。
- explain=trueを渡すと、ヒットごとに系統別の順位、RRFの寄与、乗数を確認できます。
時間: as_of
- ISO形式の日付を渡すと、その時点でwikiに何と書かれていたかを調べられます。
- 記録するのは取り込み時刻だけです。ai-memoryがある事実をいつ知り、いつ置き換えたかであって、それが現実の世界でいつ正しかったかは記録しません。
- その日付に検索が返したはずのランキングを再現するものではありません。
型付きエッジ
- フロントマターの
relations:が受け付けるのは、causes、fixes、contradictsという閉じた集合です。タイプミスで新しい種類が生まれることはありません。 contradictsはLLMなしでlintの入力になり、誰かが矛盾を解消するまで報告され続けます。- 検索ではexplain専用です。通常のリンクとしてグラフに加わりますが、ランキングには影響しません。ベンチマークから重みの根拠が得られなかったためです。
memory_read_pageはこのエッジをたどって関連ページを一覧できます。
受け取るのは1人、書くのも1人。
正しさの大部分は2つのルールが支えています。引き継ぎを受け取れるのは一度だけ。SQLiteに書き込むスレッドは1つだけ。
引き継ぎはプロトコル
- 引き継ぎは型付きのレコードです。引き継ぎ元と引き継ぎ先のエージェント、プロジェクト、cwd、要約、未解決の質問、触れたファイル、次のステップを持ちます。
- 受理はアトミックなcompare-and-setです。2番目に問い合わせたエージェントには何も返りません。
- cwdはパスの境界で照合します。
/repoは/repo/apiを含みますが、/repo-otherは含みません。 - 手動の引き継ぎは自動のものより優先されます。受理すると、古い自動の候補が同じトランザクションの中で失効します。
- 共有サーバーでは、
shared=trueを付けて送らない限り、引き継ぎは所有者のものです。
単一ライターのルールを実測
すべての書き込みは、上限1024の1本のキューを通って1つのOSスレッドに届きます。読み取りには別の読み取り専用プールを使います。書き込みが集中すると書き込む側が減速しますが、書き込みが捨てられることはありません。
- ライター142/秒23.9 ms
- ライター8295/秒3.4 ms
- ライター32698/秒1.43 ms
- ライター128700/秒1.43 ms
- 上限は毎秒約700書き込みで、ライター32以上では横ばいです。ライター1つの場合を律速するのはfsyncで、CPUではありません。
- 高速なローカルディスクでの計測です。ネットワークボリュームや遅いボリュームでは大幅に下がります。
- テストはストアを直接駆動し、HTTPの入口を通りません。
cargo test -p ai-memory-store --test writer_throughput -- --ignored --nocaptureで再現できます。
古いセッションページにはスコアが付き、コールドなものは追い出し、コンパクション、マージのいずれかの対象になります。記憶はどう古くなるか。
クレートごとに見るコード。
クレートは9つ。それぞれ役割は1つで、型付きのAPIを持ち、循環依存はありません。
| クレート | 責務 |
|---|---|
ai-memory-core | ドメインの型、エラー、ID。IOなし。 |
ai-memory-store | SQLite、ライターアクター、リーダープール、減衰の計算。 |
ai-memory-wiki | markdownのアトミックな書き込み、ファイルウォッチャー、git。 |
ai-memory-mcp | MCPのトランスポートとツールルーター。 |
ai-memory-hooks | ペイロードのスキーマ、サニタイザー、/hookの受け口。 |
ai-memory-llm | プロバイダー認証の境界、LLMと埋め込み処理のトレイト。 |
ai-memory-consolidate | 取り込み、lint、スイープ、自動改善のパイプライン。 |
ai-memory-workstream | 読み取り専用のネイティブトランスクリプトアダプターと起動アダプター。 |
ai-memory-cli | ai-memoryバイナリと、薄いHTTPサブコマンド。 |
MCPツールは23個。意図して絞っています
日常のキャプチャはフックが行うので、エージェントがこれらを手動で呼ぶ必要はほとんどありません。
想起 (7)
memory_querymemory_recentmemory_read_pagememory_read_session_observationsmemory_briefingmemory_explorememory_status
引き継ぎ (4)
memory_handoff_beginmemory_handoff_listmemory_handoff_acceptmemory_handoff_cancel
プロジェクト間メッセージ (4)
memory_message_sendmemory_message_listmemory_message_popmemory_message_cancel
書き込みとメンテナンス (8)
memory_write_pagememory_delete_pagememory_consolidatememory_auto_improvememory_feedbackmemory_lintmemory_forget_sweepmemory_install_self_routing
よくある質問
ai-memoryはデータをどこに保存しますか?
1つのデータディレクトリの中です。wiki/にmarkdownページのgitリポジトリ、db/に派生のSQLiteインデックス、raw/にサニタイズ済みのworkstream断片、models/にローカルの埋め込みモデルがあり、ほかにログがあります。
ai-memoryにLLMは必要ですか?
いいえ。キャプチャ、セッションの要約、引き継ぎ、インデックス作成、検索、ブリーフィングは、プロバイダーを設定しなくても動きます。LLMによる統合、自動改善、リランクはオプトインです。
SQLiteインデックスが失われたり壊れたりしたらどうなりますか?
信頼できる唯一の情報源はmarkdownファイルです。ai-memory reindexで、ファイルからページのインデックスを再構築できます。ファイルシステムとSQLiteをまたぐトランザクションはなく、クラッシュで生じた食い違いの解消にもreindexを使います。
検索結果はどのようにランク付けされますか?
4つの候補系統(FTS5の全文検索、エンティティ一致、グラフの隣接ページ、任意のベクトル)をk=60のReciprocal Rank Fusionで融合し、上限つきの情報源の権威度の乗数で調整します。LLMリランクは任意で、生のオブザベーションはフォールバックです。
毎秒何件の書き込みに耐えられますか?
ストアの実測値は、ライター1つで毎秒42書き込み、8つで295、32以上では約700で頭打ちです。数値は高速なローカルディスクで計測したもので、テストはHTTPの入口を通さずストアを直接駆動しています。