
ソリューション
他のメモリツールからの移行
どのメモリツールも、1つの賭けを軸に作られています。このページでは、それぞれが何のためのツールか、移行すると何が変わるか、ai-memoryのほうが劣る選択になるのはどこかを説明します。
ツールごとに最適化の対象は1つ
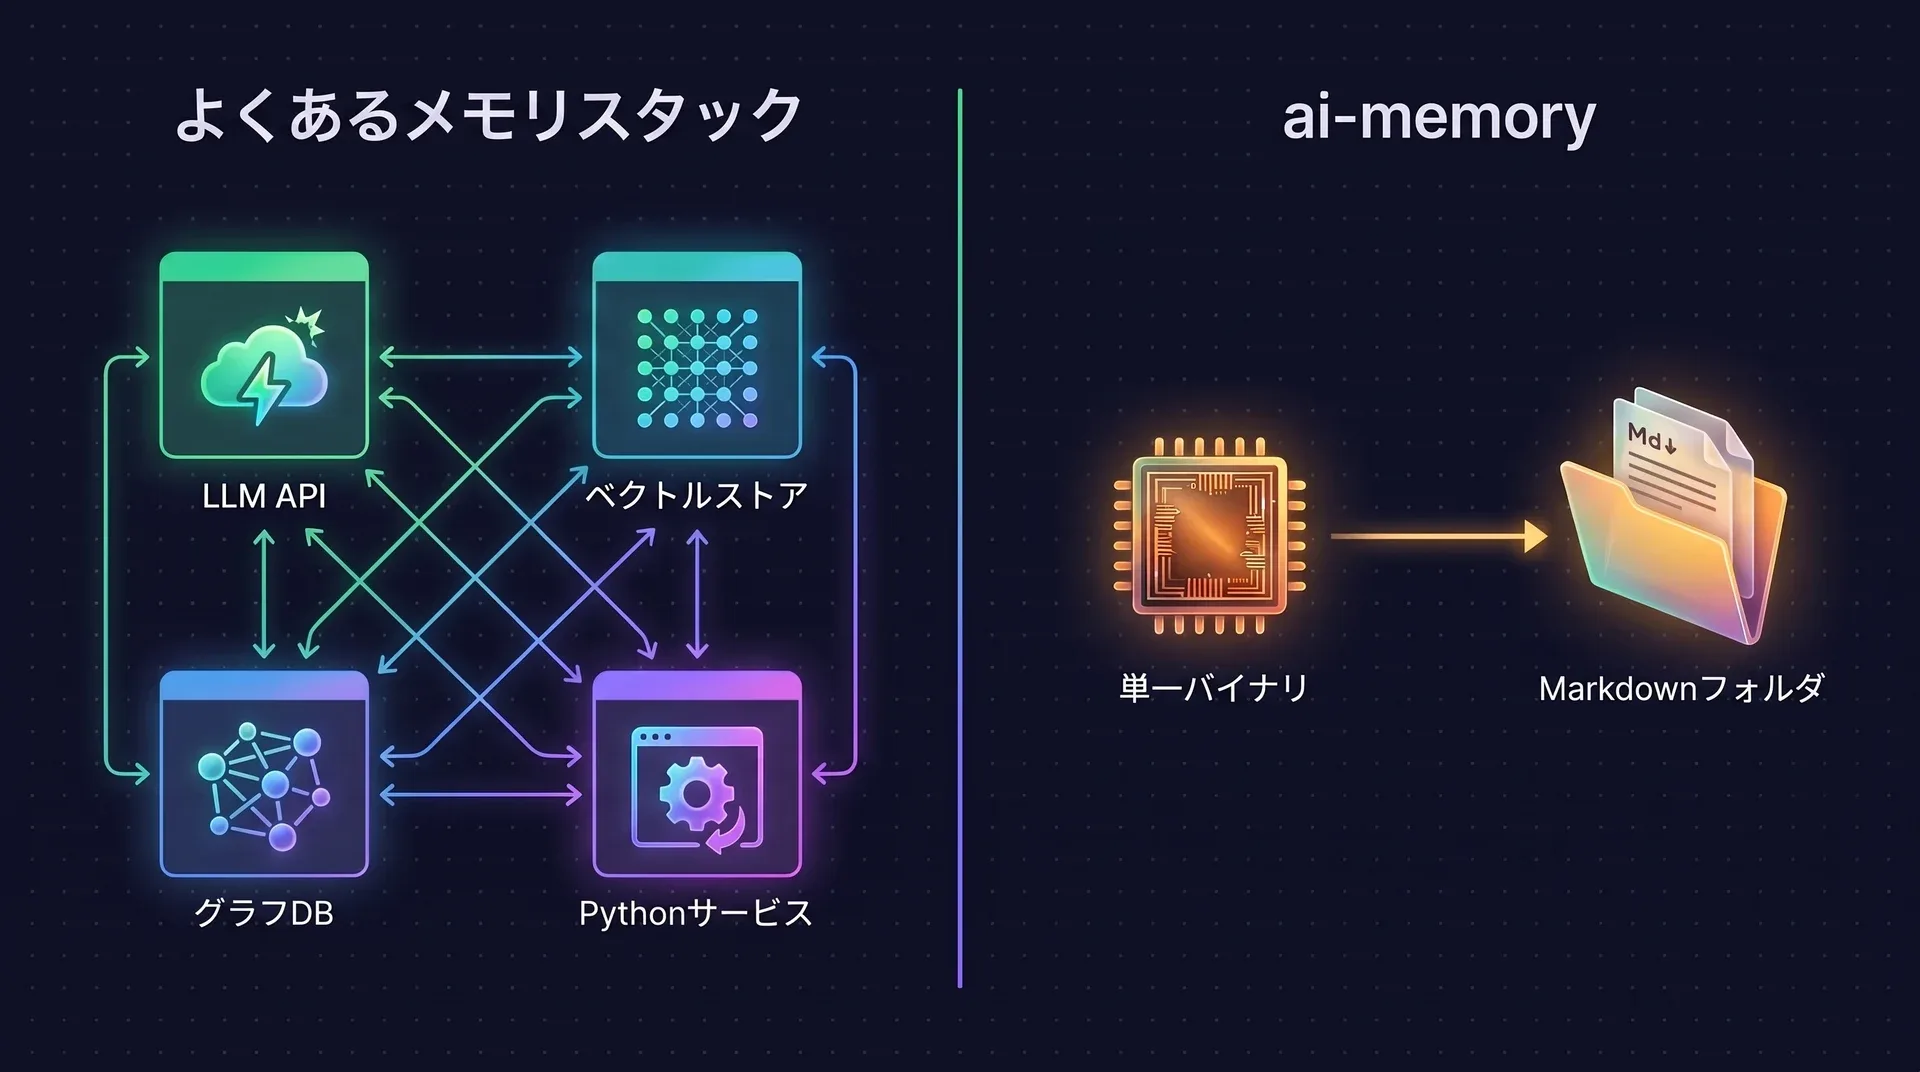
ai-memoryが最適化しているのは、gitで管理するmarkdownページのwikiと派生した検索インデックスで、デフォルトではLLM呼び出しがゼロです。他のツールは、別の利用者に向けて別の賭けをしています。
ファクト抽出型
Mem0とLangMemは、毎ターンLLMに最小単位のファクトを抜き出させ、アプリをエンドユーザーごとにパーソナライズします。
時系列グラフ型
Zep、Graphiti、cogneeは、知識を時間軸を持つグラフとしてモデル化します。グラフクエリに応え、グラフデータベースの上で動きます。
メモリOS型
LettaとMemGPTは、階層化されたメモリをエージェント自身に編集させます。そのエージェントランタイムを採用する人に向いています。
ホスト型API
Supermemoryや各社のマネージドクラウドは、記憶をアカウントの向こう側に置きます。その代わりにコネクタが手に入り、運用は不要になります。
すべてを備えたツールは他にない
プロジェクトは、競合ツールを自分たちのコードと突き合わせて監査しました。ほとんどのツールはこの6項目のうち1つか2つを備えており、6つすべてを備えたものはありません。
デフォルトでLLM呼び出しゼロ
キャプチャ、検索、引き継ぎはAPIキーなしで動きます。
ファイルが正
git管理のmarkdownフォルダです。データベースは再構築できるインデックスです。
自己完結型の単一バイナリ
グラフデータベースも、Pythonランタイムも、サイドカープロセスも要りません。
すべてのエージェントで自動
20種以上のコーディングエージェントに対応するライフサイクルフック。
型付きで、一度だけ受け取れる引き継ぎ
引き継ぎはプロトコルです。それぞれに型とオーナーがあり、受け取れるのは1つのセッションだけです。
有料プランなしでチーム利用
アカウント、作業者の記録、監査ログが最初から入っています。
動かす必要があるもの
メモリツールを比べるいちばん手早い方法は、何かを記憶できるようになるまでに必要なサービスの数を数えることです。
| ツール | LLM | ベクトルまたは埋め込みのサービス | グラフデータベース | 別のランタイムやデータベース | クラウドアカウント | 必要なもの |
|---|---|---|---|---|---|---|
| ai-memory | 任意 | 不要 | 不要 | 不要 | 不要 | 単一バイナリとmarkdownのフォルダ1つ |
| Claude Code組み込みのメモリ | 不要 | 不要 | 不要 | 不要 | 不要 | Claude Code · 1台のマシン |
| Mem0とLangMem | 必要 | 必要 | 不要 | 不要 | 不要 | 毎ターンのLLM呼び出し · ベクトルストア |
| ZepとGraphiti | 必要 | 不要 | 必要 | 不要 | 不要 | Neo4j、FalkorDB、Neptuneのいずれか · LLM |
| cognee | 必要 | 必要 | 必要 | 必要 | 不要 | 同期が必要な3つのストア · チャンクごとのLLM呼び出し · Python |
| OpenVikingとHindsight | 必要 | 必要 | 不要 | 必要 | 不要 | LLMまたはVLM · 埋め込み(embeddings) · Postgresまたはホスト型サービス |
| basic-memory | 不要 | 不要 | 不要 | 不要 | 不要 | ノートを手で書くあなた自身 |
| mcp-memory-service | 不要 | 不要 | 不要 | 不要 | 不要 | ほぼClaude Code専用 |
| agentmemory | 不要 | 不要 | 不要 | 必要 | 不要 | Nodeのサイドカー · 50以上のMCPツール |
| LettaとMemGPT | 不要 | 不要 | 不要 | 必要 | 不要 | 同プロジェクトのエージェントランタイムの採用 |
| Supermemory | 不要 | 不要 | 不要 | 不要 | 必要 | クラウドアカウント · API費用 |
| Honcho | 必要 | 不要 | 不要 | 必要 | 不要 | LLM · Postgres、Redis、ワーカー |
- 必要
- 任意
- ai-memoryには不要
- 不要
3つの行には印がありません。Claude Codeのメモリは組み込みで、basic-memoryとmcp-memory-serviceも軽く動かせます。違いは次のセクションで説明します。
ツール別に見る
使っているツールを開いてください。どのブロックにも、変わらない点、得られる点、そのツールが勝っている点を書いています。
Claude Code組み込みのメモリノートPCごとのMEMORY.md
変わらない点
「プロジェクトを覚えておいて」の手軽さと、markdown形式。
得られる点
- 同じ記憶をCodex、Cursor、Gemini CLIほか20種以上で利用
- 複数のマシンで同じ内容を参照
- チームで共有
- 実用的な検索と、ツールが実際に行った操作のキャプチャ
このツールが勝っている点
セットアップが不要です。最初から有効で、動かすサーバーもありません。1台のマシンでClaude Codeだけを使う開発者なら、これで足りるかもしれません。
結論 移行の目安は、エージェント、マシン、人のどれかが2つ目になったときです。
Mem0とLangMem事実抽出ツール
変わらない点
自動キャプチャ。「これを覚えて」と毎回頼む必要はありません。
得られる点
- 中身の見えない事実の行に代わる、開いて編集できるページ
- 全文、エンティティ、リンク、ベクトルを融合した検索
- キャプチャにも検索にもAPI費用がかからない
このツールが勝っている点
大きなSDKエコシステムと、エンドユーザー向けにアプリをパーソナライズするためのマネージドクラウド。
結論 想定ユーザーが違います。Mem0はアプリのユーザーを覚え、ai-memoryはリポジトリを覚えます。
ZepとGraphiti時間軸つきナレッジグラフ
変わらない点
事実は置き換えられるだけで、削除されません。ある時点で何が正しかったかを問い合わせられます。
得られる点
- 時点指定クエリと型付きリンクを、SQLite入りの単一バイナリで
- グラフデータベースの運用が不要
- コーディングエージェントにネイティブ対応、20種以上にフックを用意
このツールが勝っている点
本格的なバイテンポラルモデリング、Cypherによるグラフクエリ、カスタムエンティティ型。ai-memoryは設計上、取り込み時刻しか追跡しません。
結論 コーディング用にセルフホストするなら移行を。エンタープライズ向けのグラフクエリが必要なら今のままで。
cogneeグラフ、ベクトル、リレーショナルのパイプライン
変わらない点
来歴の記録、フィードバックで重み付けするランキング、Claude Codeプラグイン。
得られる点
- バックアップ対象は1つ、markdownのフォルダだけ
- 取り込みにLLMの費用がかからない
- ホームラボのマシンで動く単一バイナリ
このツールが勝っている点
機能の幅広さ。14種以上の検索モード、オントロジーによるグラウンディング、PDFやCSV、Webページの取り込み。
結論 コーディングセッションの記憶が欲しいなら移行を。ドキュメントを取り込むなら今のままで。
OpenVikingとHindsight更新され続けるドキュメント型の記憶、LLM必須
変わらない点
バックグラウンドの統合ループが、記憶を更新され続けるページにまとめます。ai-memoryにもオプトインの夢見パスとページごとの信頼度スコアがあります。
得られる点
- LLM呼び出しゼロでのキャプチャ、検索、引き継ぎ
- ファイルは自分のもの。MITライセンスで、AGPLやSaaSの制約なし
- バンク単位の厳密な分離に代わる、プロジェクト単位のチーム共有
このツールが勝っている点
LLMを組み込んだ場合の公表精度が高いこと。HindsightはLongMemEvalで91.4%を、OpenVikingは大幅なトークン削減を報告しています。どちらもベンダー自身の数値です。Hindsightの信念の強さは、デフォルトでランキングに影響します。ai-memoryでは、評価による裏付けが得られるまでオフです。
結論 セルフホスト、オフライン、チームでの利用なら移行を。その精度が必要で、LLM必須を受け入れられるなら今のままで。
basic-memoryMCP経由のmarkdownナレッジベース
変わらない点
ディスク上のmarkdownが信頼できる唯一の情報源で、インデックスはそこからの派生です。
得られる点
- ライフサイクルフックによる自動キャプチャ
- 古いバージョンは検索から外れ、コールドなセッションページは追い出しかコンパクションの対象になる
- エージェント間の引き継ぎと複数ユーザーでの共有
このツールが勝っている点
ローカルのクロスエンコーダーによるリランカー、リアルタイム共同編集、ホスト型のモバイルアプリ。
結論 複数エージェントでコーディングを続けたいなら移行を。Obsidian風の個人用ナレッジベースなら今のままで。
mcp-memory-service最も近い兄弟プロジェクト
変わらない点
SQLite、ローカル埋め込み、フックによるキャプチャ、型付きリンク、正直な数値。記憶のエイジングも共通です。階層ごとの減衰、コンパクション、クラスタ単位の重複排除、矛盾の検出があります。
得られる点
- 事実の行に代わる、読めるページ
- デフォルトでオフのエイジングと、すべて復元できる書き換え
- エージェント間で一度だけ受け取れる引き継ぎと、プロジェクト間メッセージング
このツールが勝っている点
エイジングが設定なしで自動的に動きます。マルチバックエンドのレプリケーションとグラフのビジュアライザーもあります。セッション単位のスコアは0.860で、ai-memoryの約0.82を上回ります。
結論 フックによるキャプチャが気に入っていて、すべてのエージェントで使いたいなら移行を。
agentmemoryこのプロジェクトの祖先
変わらない点
ほぼすべての概念。階層、置き換え、減衰、融合ランキング、フック、LLMを必要としない圧縮。
得られる点
- サイドカー不要の自己完結型単一バイナリ
- 1つのトランザクションでコミットされる本物のSQLインデックス
- ファイルが正、Windowsでも同等の機能、より充実した認証
このツールが勝っている点
素の検索精度で約13ポイント。リランクを行うため、LongMemEval-Sで0.952を報告しています。ai-memoryは約0.82です。P2P同期もあります。
結論 運用のしやすさとデータの所有を重視するなら移行を。
LettaとMemGPTメモリのオペレーティングシステム
変わらない点
記憶の階層と、ホットパスの外で行う統合。
得られる点
- 今使っているエージェントの下で動く記憶
- 採用すべきランタイムがなく、自己編集にトークンを使わない
このツールが勝っている点
本格的なエージェントフレームワークと開発環境。長いタスクでも一貫性を保ちます。
結論 Letta上で開発しているなら今のままで。コーディングエージェントに覚えてほしいだけなら移行を。
Supermemoryホスト型のメモリAPI
変わらない点
自動取り込みと置き換えを備えたセカンドブレイン。その「dreaming」パスは、ai-memoryの夢見パスの参考元の1つです。
得られる点
- gitでバージョン管理された、自分のものであるmarkdown
- オフラインで動作
- 対象はリポジトリ単位。Supermemoryは汎用の保管庫です
このツールが勝っている点
Drive、Gmail、Notion、S3向けのマネージドコネクタ、マルチモーダルの取り込み、ユーザープロファイル。
結論 想定ユーザーが違います。
Honchoエージェント向けのユーザーモデリング
変わらない点
memory_queryの引用付き回答、推論レベル、そしてアイドル時に動いて新規性の高い材料から処理する夢見パス。
得られる点
- キャプチャにも検索にもLLMが要らない、同じ便利機能
- 3つのサービスに代わる、単一バイナリとフォルダ1つ
- リポジトリ単位でチームと共有する記憶
このツールが勝っている点
各人が何を知り、何を信じているかをモデル化する推論エンジン。ユーザーに関する事実の想起で、LongMemEval-Sの90.4%を報告しています。これは別のタスクでのベンダー公表値です。
結論 解く問題が違います。Honchoはユーザーを覚え、ai-memoryはプロジェクトを覚えます。
「このツールが勝っている点」の記述は、プロジェクト自身の監査に基づいています。GitHubで比較の全文と自己批判的な機能比較の監査を読めます。
ベンチマークと、その但し書き
ai-memoryが公開している数値は1つで、リポジトリに同梱されたハーネスを使ってLongMemEval-Sで計測したものです。リランクを行うシステムのほうが高いスコアを出します。
- 2.0より前のai-memory全文検索のみ0.617
- ai-memory、全文検索のみストップワードのフィルタリングを追加0.666
- ai-memoryのデフォルトローカル埋め込み、APIキー不要0.815
- mcp-memory-serviceベンダー公表値、セッション単位0.860
- agentmemoryベンダー公表値、リランクあり0.952
- hit@5は、根拠を含むセッションが上位5件の結果に入っているかを見ます。計測しているのは検索です。回答の正確さについては何も示しません。
- 500問のうち470問を採点しています。回答を控えるべき30問は除外しています。計測は2026年9月21日のものです。同じコミットでの2回目の計測は0.821だったので、デフォルトのスコアは約0.82と読んでください。
- 0.815は、APIキーもLLMも使わず、デフォルトのプロセス内埋め込みモデルで出した値です。0.666は全文検索、エンティティ、リンクだけの値です。
- 競合との直接対決の計測は存在しません。Hindsightの91.4%のような正確さの数値は別の指標で、hit@5とは比較できません。
- 保存される抜粋はプライバシーのため2 KBが上限なので、1つの長いターンの奥深くにある根拠は見つけられません。ベンチマークは出荷されているシステムをそのまま計測しています。
- LongMemEvalはチャットアシスタントの履歴です。コーディングセッションのベンチマークは計画中で、まだ存在しません。
チェックアウトから再現できます。データセットのハッシュとスライスごとの結果はベンチマークのノートにあります。
# テスト対象のサーバー
cargo build --release -p ai-memory-cli
# フル実行。--fetchはデータセットをダウンロードしてハッシュを検証する
cargo run --release -p ai-memory-eval -- retrieval --fetch
# 10問のスモークテスト
cargo run -p ai-memory-eval -- retrieval --sample 10
ai-memoryが遅れている点
このリストはリポジトリ自身の監査から取ったものです。このうちのどれかが必要なら、今のツールを使い続けてください。
ローカルのリランカーがない
検索スコアは、リランクを行うシステムを下回ります。リランカーはLLMを使うものだけで、デフォルトではオフです。引用付きの回答にもLLMが必要で、その正確さはまだ評価していません。
リンクの種類はランキングに影響しない
ページから関連ページへたどれます。検索では、リンクの種類は今も結果の説明に使われるだけで、重みを持ちません。
エイジング機能は効果が未検証
信頼度スコア、コンパクション、重複排除、夢見パスはデフォルトではオフです。これらについて想起の評価はまだ実施していないため、プロジェクトが主張するのは仕組みまでで、測定された改善は主張しません。
時間軸は1つ
時点指定検索は、ファクトが記録された時刻を使います。Zepは、出来事が起きた時刻とそれを知った時刻の両方をモデル化します。
コーディングセッションのテキストのみ
PDF、CSV、画像は取り込まず、ビジョンモデルもありません。Cypherでクエリできるグラフデータベースでもありません。
サーバーは1つ、ホスト型プランなし
多数のマシンが、あなたの動かす1つのサーバーにつながります。自動レプリケーションも、SaaSも、エンタープライズ向けコンソールもありません。
組み込みメモリよりセットアップが多い
Claude Code自身のメモリは最初から有効です。ai-memoryは、個人開発者にもまずサーバーの起動を求めます。
移行の進め方
一度に切り替える必要はありません。比較している間、同じプロジェクトで両方のツールを動かせます。
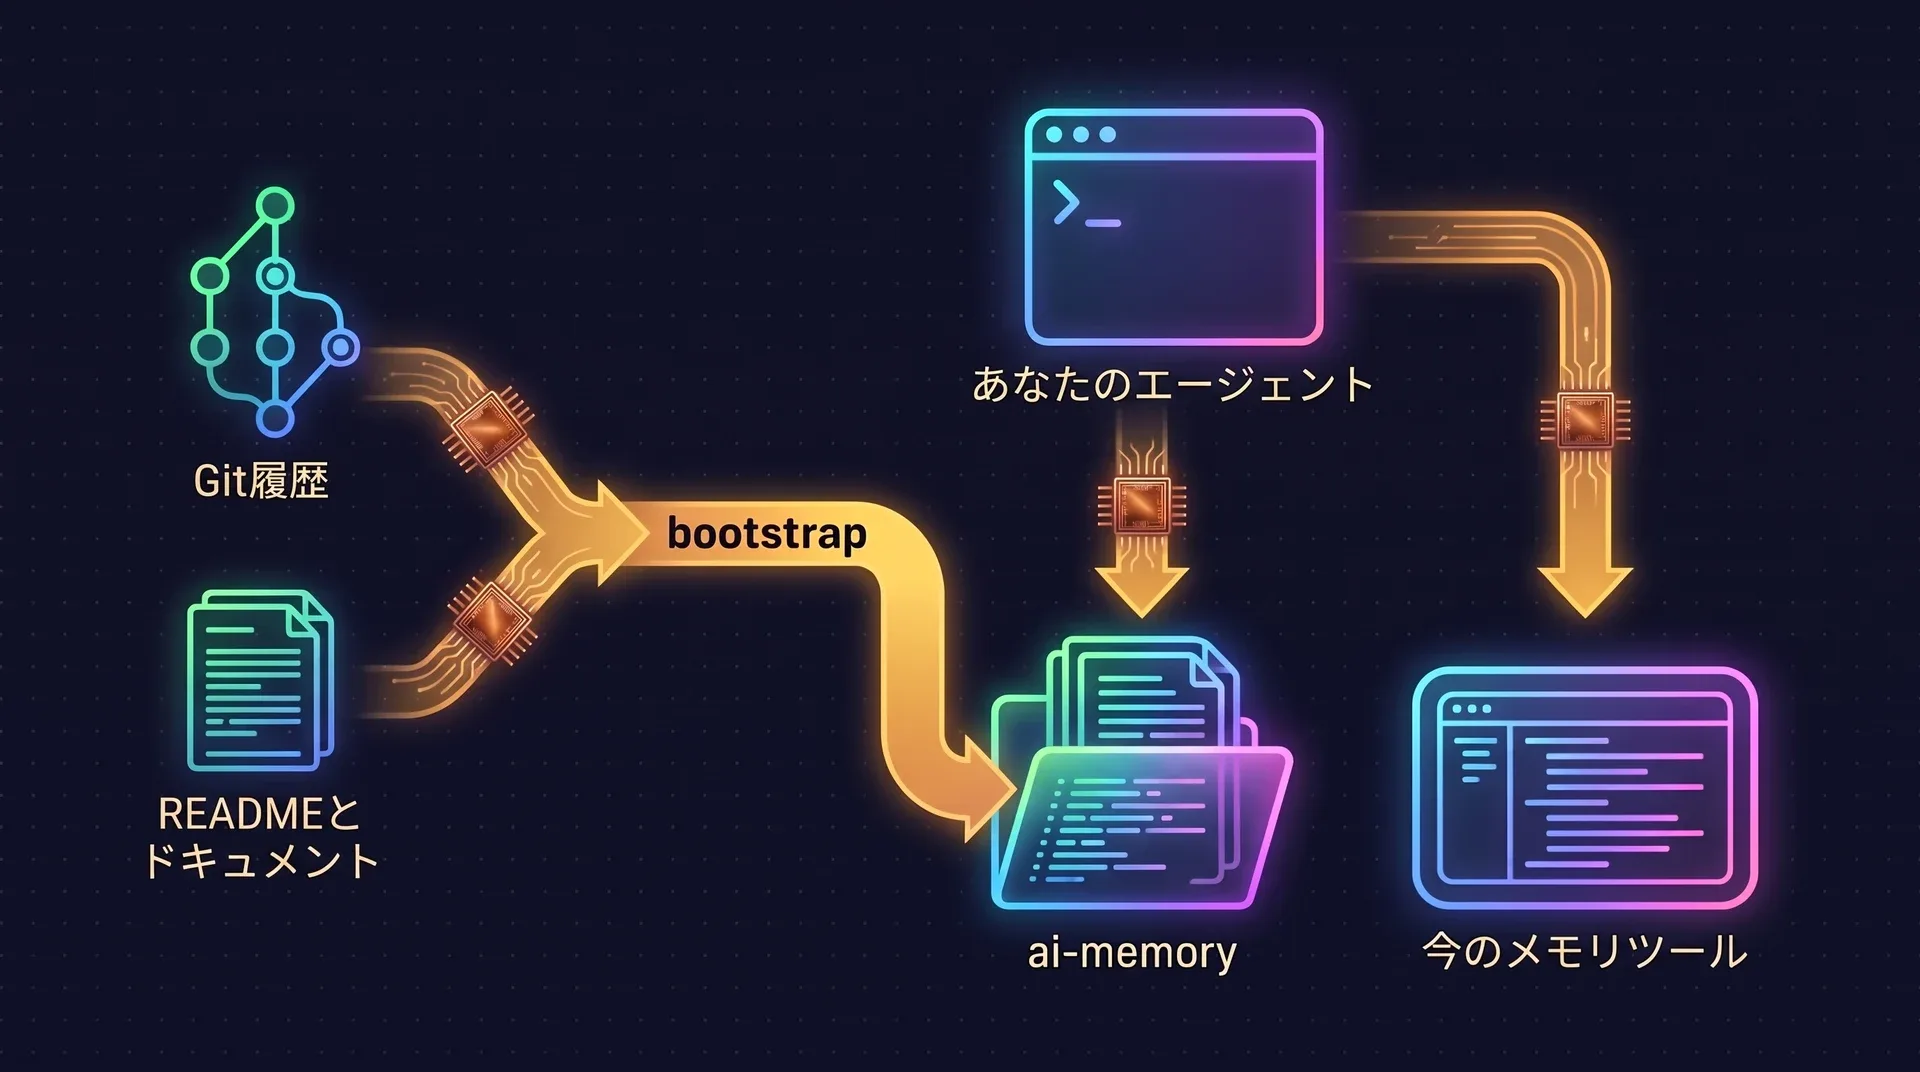
今あるツールの隣にインストールする
ai-memoryは自分のMCPエントリと自分のフックを追加し、他のツールのエントリには手を付けません。コマンドはクイックセットアップにあります。
プロジェクト自体からwikiの初期ページを作る
ai-memory bootstrapは、gitの履歴、README、docs/、エージェントのルールファイルを読み、初期ページを書きます。LLMプロバイダーが必要です。先にドライランを実行して、何が送信されるかを確認してください。書かれた内容もレビューしてください。LLMはもっともらしいのに間違った詳細を書くことがあり、wikiはgit管理なので元に戻せます。既存のプロジェクト cd /path/to/project ai-memory bootstrap --dry-run ai-memory bootstrapインポーターが読める形式なら、古いノートや会話を持ち込む
companions/ai-memory-importerにあるスタンドアロンのインポーターが現在読めるのは2種類です。oh-my-claudecode(OMC)のmarkdown wikiフォルダと、小さな汎用JSONエンベロープに入った会話です。Mem0、Zep、cognee用のアダプターはないので、それらのエクスポートは先にエンベロープ形式へ変換する必要があります。デフォルトはドライランで、削除は一切行いません。ドライラン、リポジトリのチェックアウトから cargo run --manifest-path companions/ai-memory-importer/Cargo.toml -- \ omc-wiki --dir /path/to/omc/wiki --workspace default --project my-projectしばらく両方を動かしてから決める
比較している間は、古いツールも接続したままにします。プロジェクトについて同じ質問を両方にしてみてください。使わなくなったほうを外します。
インポーターの対応形式と安全ルールはコンパニオンクレートのガイドにあります。ドキュメントを取り込む他の方法はクックブックにあります。
乗り換える前によく聞かれる質問
LLMのAPIキーは必要ですか?
いいえ。キャプチャ、検索、引き継ぎはキーもLLMもなしで動きます。プロバイダーを追加すると、LLMによる統合、ブートストラップ、より詳しいlint、自動改善、任意のリランクが有効になります。CodexやGitHub Copilotなどのサブスクリプションログインもプロバイダーとして使えます。
ホスト型のバージョンはありますか?
いいえ。ai-memoryは、ノートPC、ホームラボのマシン、LAN内のホストなどで自分で動かす単一のサーバーです。SaaSプランもエンタープライズ向けコンソールもありません。
Mem0、Zep、cogneeからデータをインポートできますか?
直接はできません。コンパニオンのインポーターが読めるのは、oh-my-claudecodeのmarkdown wikiと汎用の会話JSON形式です。特定の製品向けのアダプターはリポジトリの外にあります。既存のコードベースなら、ai-memory bootstrapがgitの履歴とドキュメントからwikiの初期ページを作ります。
今のメモリツールと並べてai-memoryを動かせますか?
はい。独自のMCPサーバーエントリと独自のライフサイクルフックとしてインストールされ、他のツールの設定には触れません。どちらかを外す前に、同じプロジェクトで両方を比較できます。
検索スコアは他と比べてどうですか?
LongMemEval-Sでのhit@5は、デフォルトのローカル埋め込みで0.815、全文検索のみで0.666です。この数値は検索を計測したもので、回答の正確さについては何も示しません。リランクを行うシステムのほうがスコアは高く、セッション単位でagentmemoryは0.952、mcp-memory-serviceは0.860を公表しています。
マシン間で記憶を同期しますか?
すべてのマシンがネットワーク越しにつながる1つのサーバーを使います。サーバー間の自動レプリケーションはありません。