
自分だけで使う
バイナリを1つインストールし、ローカルサーバーを1つ起動して、エージェントを立ち上げます。サーバーは127.0.0.1:49374にバインドするので、このマシンの外からは届かず、トークンも要りません。
バイナリをインストールする
miseは、お使いのOSとCPUに合ったリリースアーカイブをダウンロードし、公開されている
.sha256ファイルと照合します。RustのツールチェーンもDockerも要りません。ターミナル mise use -g github:akitaonrails/ai-memoryデータディレクトリを作成し、サーバーを起動する
initはデータディレクトリを作るだけです。serveは動かし続ける必要があるので、専用のターミナルを用意してください。待ち受けるのはこのマシン上だけで、トークンは要りません。ターミナル ai-memory init ai-memory serve --transport http --bind 127.0.0.1:49374ai-memory経由でエージェントを起動する
ハーネスの初回起動時に、フックとMCPエントリがなければインストールします。その後は
claudeを直接起動しても引き続き動きます。ターミナル ai-memory run claude
パッケージをインストールする
-binパッケージは、ビルド済みのx86_64またはaarch64バイナリです。どちらのパッケージにも、systemdのユーザーユニットとシステムユニットが入っています。ターミナル yay -S ai-memory-bin # ビルド済みのLinux x86_64/aarch64バイナリ yay -S ai-memory # ソースからビルドデータディレクトリを作成する
ターミナル mkdir -p ~/.config/ai-memory ~/.local/share/ai-memory ai-memory --data-dir ~/.local/share/ai-memory \ --config ~/.config/ai-memory/config.toml initユーザーサービスを起動する
sudoは要らず、状態はすべてホームディレクトリ内に収まります。システムユニットとログアウト後の実行についてはサービスのセクションで説明しています。
ターミナル systemctl --user enable --now ai-memory.serviceai-memory経由でエージェントを起動する
ターミナル ai-memory run claude
ダウンロードして展開する
このアーカイブはApple Silicon用です。Intel Macでは
aarch64をx86_64に置き換えてください。ブラウザでダウンロードした場合は、xattr -d com.apple.quarantine ./ai-memoryを1回実行する必要があります。curlでダウンロードした場合は不要です。ターミナル mkdir -p ~/Applications/ai-memory && cd ~/Applications/ai-memory curl -fsSL -O https://github.com/akitaonrails/ai-memory/releases/latest/download/ai-memory-macos-aarch64.tar.gz tar -xzf ai-memory-macos-aarch64.tar.gzデータディレクトリを作成し、サーバーを起動する
serveはこのターミナルで動かしたままにします。launchdエージェントを使えば、代わりにログイン時に起動できます。ターミナル ./ai-memory init ./ai-memory serve --transport http --bind 127.0.0.1:493742つ目のターミナルからエージェントを接続する
展開したバイナリは動かさないでください。フックのコマンドがそのパスを指しています。
ターミナル cd ~/Applications/ai-memory ./ai-memory install-hooks --agent claude-code --apply ./ai-memory install-mcp --client claude-code --apply
ラッパースクリプトをインストールする
ラッパーは
~/.local/bin/ai-memoryに置かれる小さなシェルスクリプトです。READMEにインストールスクリプトがあり、インストール前にダウンロードしたファイルをSHA-256ファイルと照合します。そこからコピーしてください。サーバーを起動する
イメージは
linux/amd64とlinux/arm64に対応しています。Podmanのホストではdockerをpodmanに置き換えてください。Dockerがインストールされていなければ、ラッパーは自動でrootlessのPodmanを使います。ターミナル docker run -d --name ai-memory \ --restart unless-stopped \ -p 127.0.0.1:49374:49374 \ -v ai-memory-data:/data \ docker.io/akitaonrails/ai-memory:latestエージェントを接続する
これ以降、Claude Codeはいつもどおり起動してください。この経路には制限が1つあります。ラッパーのシェルフックは、リポジトリごとの
ignore_pathsキャプチャルールを適用しません。ネイティブバイナリは適用します。ターミナル ai-memory install-mcp --client claude-code --apply ai-memory install-hooks --agent claude-code --apply
エージェントをどこで動かすか決める
WSL2の中で起動するエージェントには、WSL2の中のai-memoryが必要です。この経路はサポートされていて、手順はDockerのタブと同じです。WSL2のシェルでREADMEからラッパーをインストールしてください。Docker Desktopを使う場合は、先にそのディストリビューションのWSL統合を有効にします。
WSL2の中でサーバーを起動する
ターミナル docker run -d --name ai-memory \ --restart unless-stopped \ -p 127.0.0.1:49374:49374 \ -v ai-memory-data:/data \ akitaonrails/ai-memory:latestエージェントの接続もWSL2の中で行う
ネイティブWindowsは実験的です。
ai-memory.exe入りのリリースzip、PowerShell製のDockerラッパー、WinSWのサービス設定例があります。3つともWindowsガイドにあります。ターミナル ai-memory install-mcp --client claude-code --apply ai-memory install-hooks --agent claude-code --apply
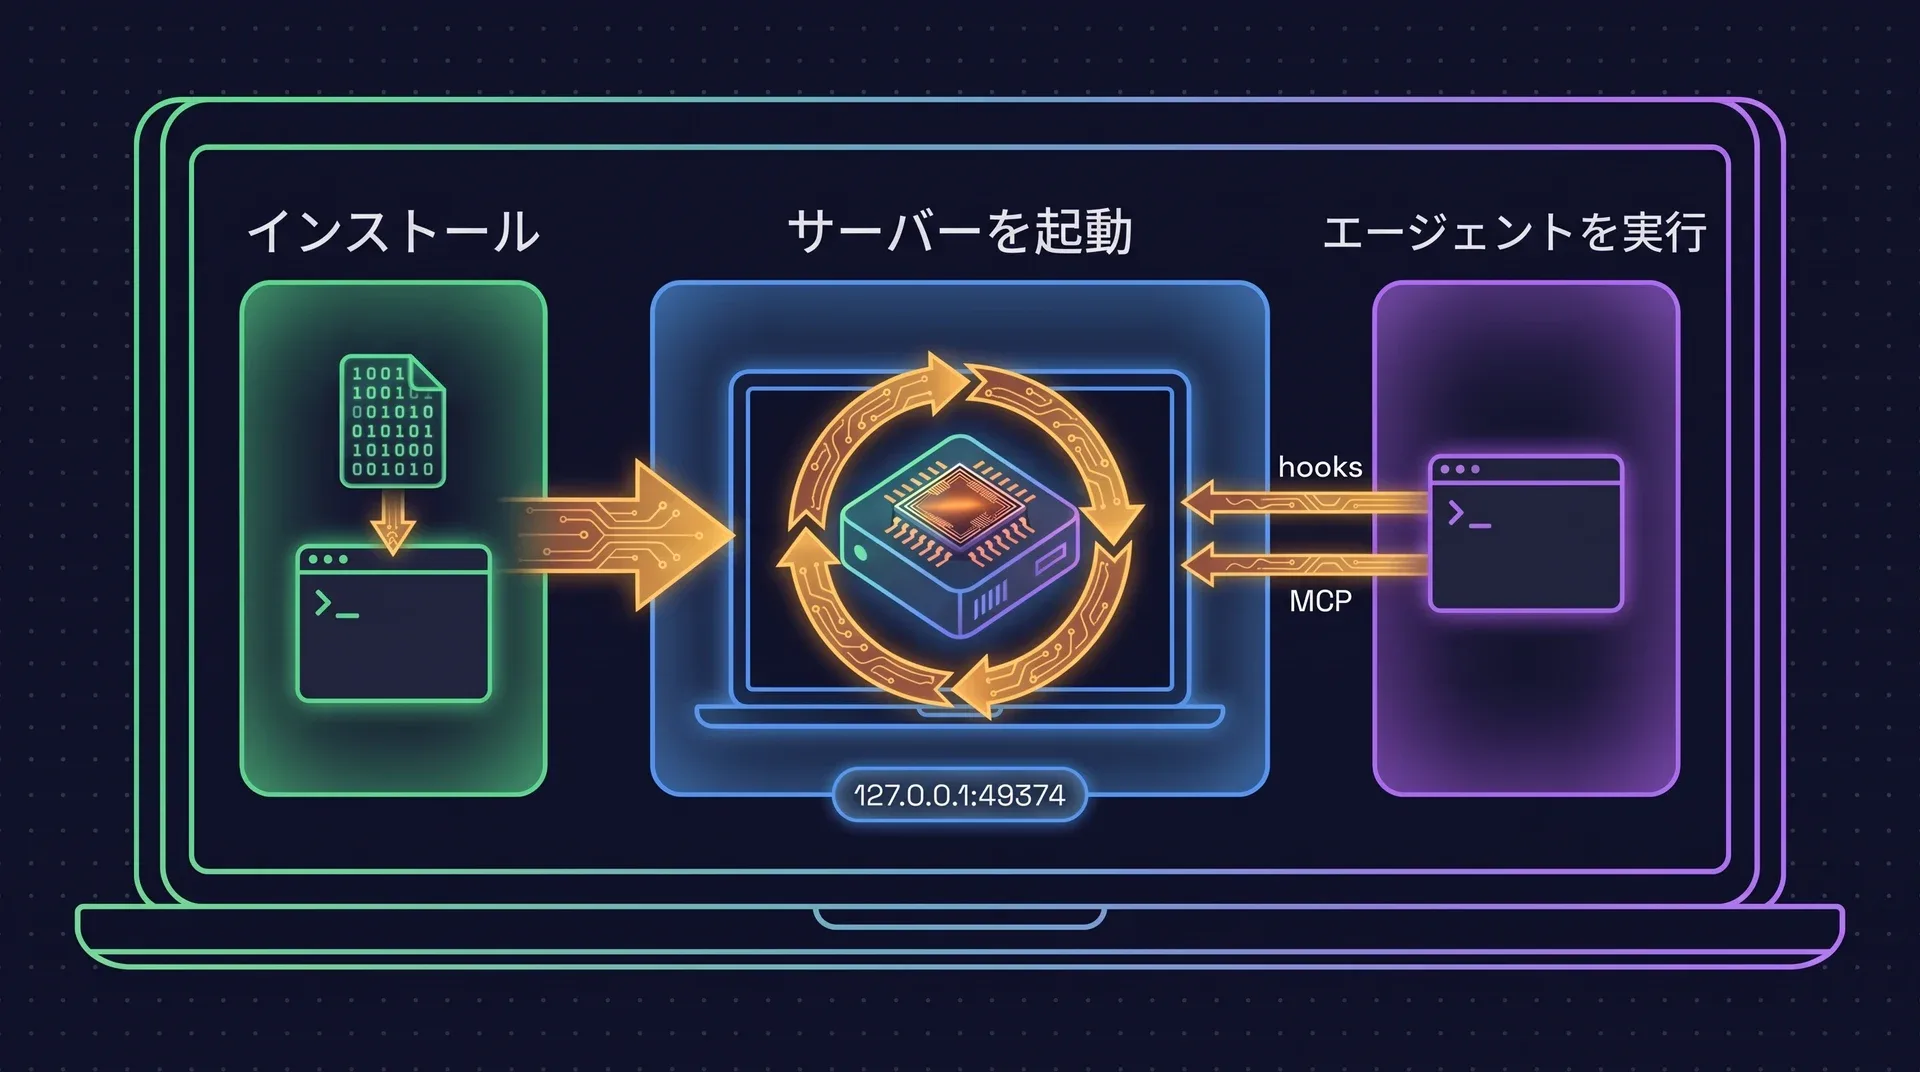
ai-memory runは推奨のランチャーですが、使わなくても構いません。初回起動時にハーネスを接続し、ハーネスをまたいだネイティブのセッション再開を加えます。引き継ぎ(ハンドオフ)はフックだけでも運ばれるので、エージェントを直接起動しても引き続き動きます。マネージド起動の仕組みを読む。
動作を確認する
ネットワークからエージェントまで、下から順に3つ確認します。
サーバーが応答する
JSON-RPCのエラーが返れば正解です。ポートに届いていて、サーバーが応答しているという意味です。
curl http://127.0.0.1:49374/mcp
CLIがサーバーに届く
CLIは薄いHTTPクライアントです。ここでステータスが表示されれば、フックもサーバーに届きます。
ai-memory status
エージェントが覚えている
数分作業して終了し、同じディレクトリで2つ目のセッションを開きます。そしてこう尋ねてください。
「どこまでやったっけ?」
最初のエージェントのあとで
3つとも任意です。必要になったときに行ってください。
別のエージェントを追加する
同じ2つのコマンドを、名前だけ替えて実行します。これで両方のエージェントが1つのプロジェクト記憶を共有します。
ai-memory install-mcp   --client codex --apply
ai-memory install-hooks --agent  codex --apply
任意:LLMで要約の質を上げる
プロバイダーがなくても、キャプチャ、検索、ルールベースの要約はすべてコストなしで動きます。プロバイダーを設定すると、セッションページが読みやすい文章に書き直されます。サーバーの環境にこの2つの変数を設定し(Dockerなら-eフラグ、systemdのユーザーサービスなら~/.config/ai-memory/env)、再起動してください。
AI_MEMORY_LLM_PROVIDER=anthropic
ANTHROPIC_API_KEY=sk-ant-...
すべて元に戻す
削除されるのはai-memoryがインストールしたものだけです。インストールコマンドは冪等で、ファイルに手を加えるときは必ず、その隣にタイムスタンプ付きのバックアップを書き出します。
ai-memory uninstall --apply
チームで使う
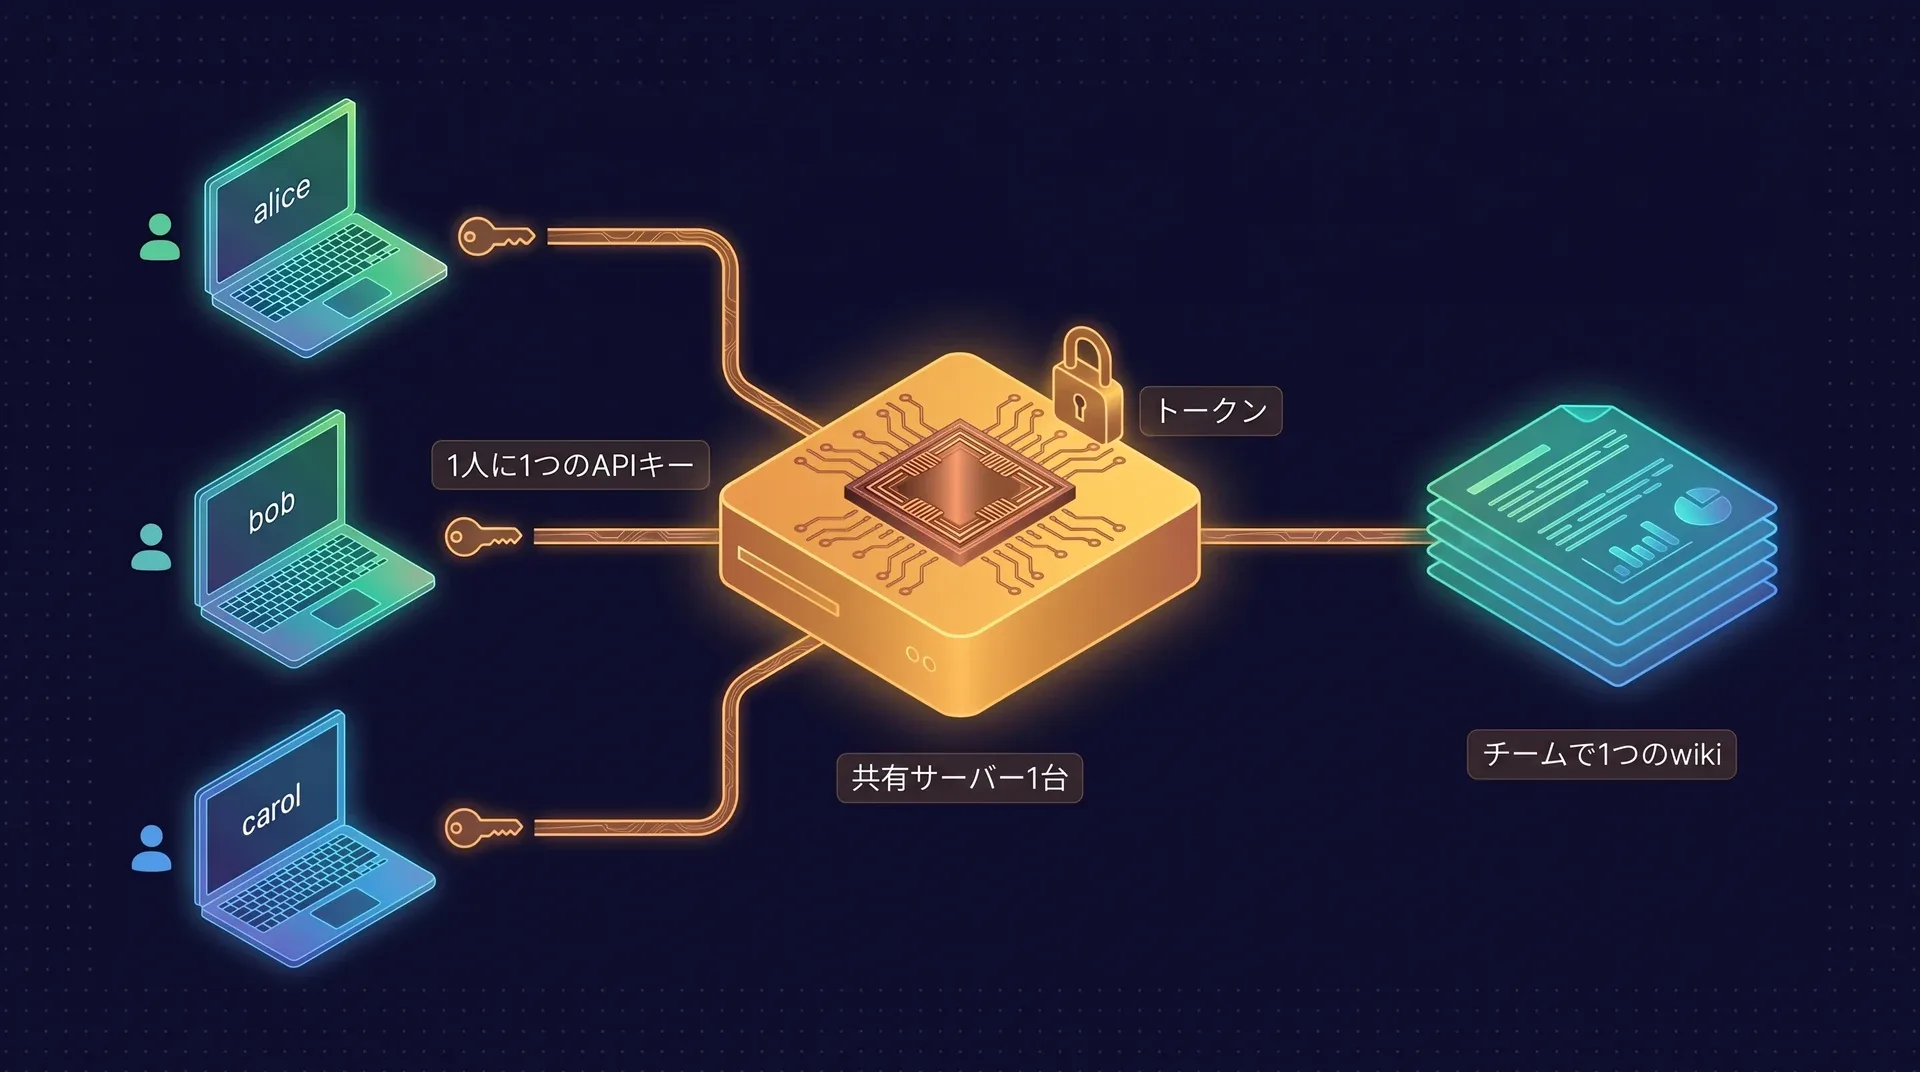
すべてのマシンとすべてのチームメンバーがつながる1つのサーバーです。サーバー間のレプリケーションはありません。記憶の共有とは、全員が同じサーバーに接続することです。
トークン付きで共有サーバーを起動する
ホームラボのマシンかLAN内のホストを選びます。ループバック以外にバインドするサーバーには、ベアラートークンとホストの許可リストの両方が必要です。許可リストには、各マシンがサーバーへの接続に使う名前やIPをすべて入れます。
サーバー上で TOKEN=$(ai-memory generate-auth-token) docker run -d --name ai-memory \ --restart unless-stopped \ -p 0.0.0.0:49374:49374 \ -v ai-memory-data:/data \ -e AI_MEMORY_AUTH_TOKEN="$TOKEN" \ -e AI_MEMORY_ALLOWED_HOSTS="<server-ip>,localhost,127.0.0.1" \ akitaonrails/ai-memory:latestメンバーを作成する
rootトークンをexportした状態で実行します。一時パスワードは1回だけ表示され、本人が初回ログイン時に変更します。このコマンドはAPIキーを発行しません。
[auth]のroot識別情報についてはユーザーガイドで説明しています。ターミナル ai-memory user add-human --username alice --email alice@home --name "Alice Smith"各メンバーにAPIキーを渡す
aim_のシークレットは1回だけ表示されます。ai-memory api-key rotate <id>とai-memory api-key revoke <id>は即座に反映されます。ターミナル ai-memory api-key add --username alice --label codex-laptop各マシンをサーバーに向ける
各メンバーは自分のキーをトークンとして使います。キーはデータディレクトリ内の
0600のファイルに保存され、フックのコマンドラインには現れません。--as-userはインストールにラベルを付けるだけです。すべてのノートPCで # ここでのTOKENは本人のaim_キー。rootトークンではない export AI_MEMORY_SERVER_URL="http://<server-ip>:49374" export AI_MEMORY_AUTH_TOKEN="$TOKEN" ai-memory install-mcp --client claude-code --apply ai-memory install-hooks --apply --agent claude-code \ --as-user alice --auth-token aim_XGq...<secret>LANの外に出す前にTLSを追加する
ベアラートークンはリクエストを認証しますが、暗号化はしません。素のHTTPではキーもWebのCookieも平文で流れます。アカウントを作成したあとや、サーバーが手元のネットワークの外から届くようになったら、Caddy、nginx、Cloudflare Tunnelのいずれかを前段に置いてください。
どこかの手順で詰まりましたか?
GitHubのインストールクックブックに、エージェントごとのコマンド、リモートサーバー、Windowsの手順があります。Issueトラッカーも開いています。