
솔루션
다른 메모리 도구에서 옮겨 오기
메모리 도구는 저마다 하나의 선택에 베팅해 만들어졌습니다. 이 페이지는 각 도구가 무엇을 위한 것인지, 옮기면 무엇이 달라지는지, ai-memory가 더 약한 선택인 경우는 언제인지 설명합니다.
도구마다 최적화하는 것은 하나입니다
ai-memory는 markdown 페이지로 이루어진 git 기반 위키와 파생 검색 인덱스에 최적화되어 있고, 기본값으로는 LLM을 한 번도 호출하지 않습니다. 다른 도구들은 다른 사용자를 위해 다른 선택을 했습니다.
팩트 추출형
Mem0와 LangMem은 매 턴마다 LLM에게 원자적 사실을 뽑게 해서, 앱을 최종 사용자에게 맞게 개인화합니다.
시간 그래프형
Zep, Graphiti, cognee는 지식을 시간 축이 있는 그래프로 모델링합니다. 그래프 쿼리를 제공하며 그래프 데이터베이스 위에서 실행됩니다.
메모리 운영체제형
Letta와 MemGPT는 에이전트가 계층화된 자기 메모리를 직접 편집하게 합니다. 이들의 에이전트 런타임을 도입하는 사람에게 맞습니다.
호스팅형 API
Supermemory와 매니지드 클라우드는 메모리를 계정 뒤에 보관합니다. 그 대가로 커넥터를 제공하고 운영 부담을 없애 줍니다.
다른 어떤 도구도 전부 갖추지 못한 것
프로젝트는 자체 코드를 기준으로 경쟁 도구들을 점검했습니다. 대부분 이 여섯 가지 중 하나나 둘을 갖췄고, 여섯 가지를 모두 갖춘 곳은 없습니다.
기본값은 LLM 호출 0회
캡처, 검색, 인수인계가 API 키 없이 동작합니다.
파일이 단일 진실 공급원
git으로 관리되는 markdown 폴더입니다. 데이터베이스는 다시 만들 수 있는 인덱스입니다.
혼자 동작하는 단일 바이너리
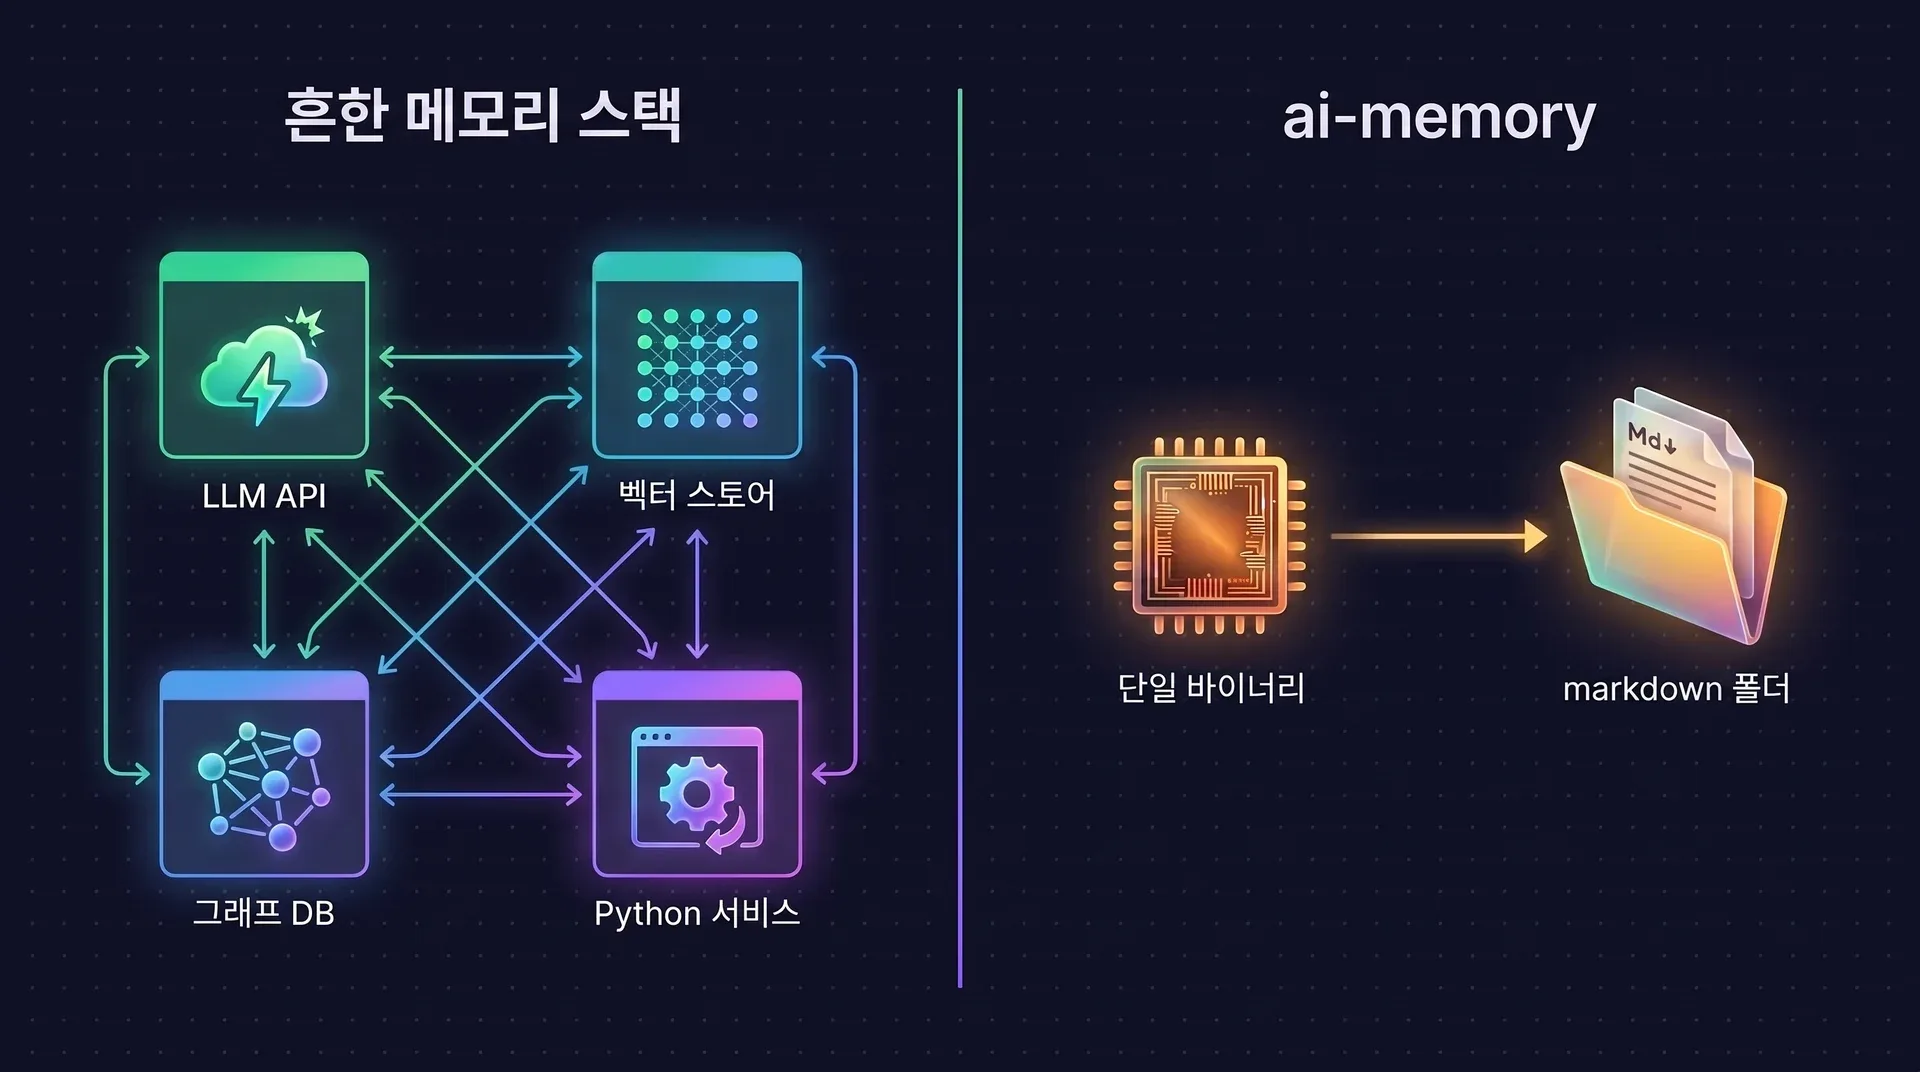
그래프 데이터베이스, Python 런타임, 사이드카 프로세스 없이 실행됩니다.
모든 에이전트에서 자동으로
20종 이상의 코딩 에이전트용 라이프사이클 훅.
타입이 있고 한 번만 수령되는 인수인계
프로토콜입니다. 인수인계마다 타입과 소유자가 있고, 단 하나의 세션만 수령할 수 있습니다.
유료 플랜 없이 쓰는 팀 기능
계정, 작성자 표시, 감사 로그가 기본으로 들어 있습니다.
직접 운영해야 하는 것
메모리 도구를 가장 빠르게 비교하는 방법은, 무언가를 기억하기 전에 각 도구가 필요로 하는 서비스 수를 세어 보는 것입니다.
| 도구 | LLM | 벡터 또는 임베딩 서비스 | 그래프 데이터베이스 | 별도의 런타임 또는 데이터베이스 | 클라우드 계정 | 필요한 것 |
|---|---|---|---|---|---|---|
| ai-memory | 선택 사항 | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | 단일 바이너리와 markdown 폴더 하나 |
| Claude Code 내장 메모리 | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | Claude Code · 컴퓨터 한 대 |
| Mem0와 LangMem | 필요함 | 필요함 | 필요 없음 | 필요 없음 | 필요 없음 | 매 턴마다 LLM · 벡터 스토어 |
| Zep과 Graphiti | 필요함 | 필요 없음 | 필요함 | 필요 없음 | 필요 없음 | Neo4j, FalkorDB 또는 Neptune · LLM |
| cognee | 필요함 | 필요함 | 필요함 | 필요함 | 필요 없음 | 동기화해야 하는 저장소 세 개 · 청크마다 LLM 호출 · Python |
| OpenViking과 Hindsight | 필요함 | 필요함 | 필요 없음 | 필요함 | 필요 없음 | LLM 또는 VLM · 임베딩 · Postgres 또는 호스팅 서비스 |
| basic-memory | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | 노트를 직접 쓰는 나 자신 |
| mcp-memory-service | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | 주로 Claude Code |
| agentmemory | 필요 없음 | 필요 없음 | 필요 없음 | 필요함 | 필요 없음 | Node 사이드카 · 50개 이상의 MCP 도구 |
| Letta와 MemGPT | 필요 없음 | 필요 없음 | 필요 없음 | 필요함 | 필요 없음 | 자체 에이전트 런타임 도입 |
| Supermemory | 필요 없음 | 필요 없음 | 필요 없음 | 필요 없음 | 필요함 | 클라우드 계정 · API 비용 |
| Honcho | 필요함 | 필요 없음 | 필요 없음 | 필요함 | 필요 없음 | LLM · Postgres, Redis, 워커 |
- 필요함
- 선택 사항
- ai-memory에는 필요 없음
- 필요 없음
세 행에는 표시가 없습니다. Claude Code의 메모리는 내장되어 있고, basic-memory와 mcp-memory-service도 가볍게 돌릴 수 있습니다. 차이점은 다음 섹션에 있습니다.
도구별 비교
쓰고 있는 도구를 열어 보세요. 블록마다 그대로인 것, 새로 얻는 것, 그 도구가 더 나은 부분이 나옵니다.
Claude Code 내장 메모리노트북마다 따로 있는 MEMORY.md
그대로인 것
"내 프로젝트를 기억해 줘"라는 편리함을 markdown으로 그대로.
새로 얻는 것
- Codex, Cursor, Gemini CLI 외 20종에서 쓰는 같은 기억
- 내 컴퓨터 여러 대에서 동기화
- 팀과 공유
- 제대로 된 검색, 그리고 도구가 실제로 한 일의 캡처
이 도구가 더 나은 부분
설정이 전혀 필요 없습니다. 이미 켜져 있고 운영할 서버도 없습니다. 컴퓨터 한 대에서 Claude Code만 쓰는 개발자라면 이것으로 충분할 수 있습니다.
결론 두 번째 에이전트, 두 번째 컴퓨터, 두 번째 사람이 생기면 옮기세요.
Mem0와 LangMem사실 추출기
그대로인 것
자동 캡처. “이거 기억해”라고 따로 말할 필요가 없습니다.
새로 얻는 것
- 불투명한 사실 행 대신 열어서 읽고 고칠 수 있는 페이지
- 전문 검색, 엔티티, 링크, 벡터를 융합하는 검색
- 캡처와 검색에 API 비용이 들지 않음
이 도구가 더 나은 부분
큰 SDK 생태계, 그리고 최종 사용자 맞춤형 앱을 위해 만든 매니지드 클라우드가 있습니다.
결론 대상 고객이 다릅니다. Mem0는 앱의 사용자를 기억하고, ai-memory는 저장소를 기억합니다.
Zep과 Graphiti시간축 지식 그래프
그대로인 것
사실은 삭제되지 않고 새 사실로 대체됩니다. 특정 시점에 무엇이 참이었는지 물을 수 있습니다.
새로 얻는 것
- SQLite를 쓰는 단일 바이너리에서 시점 기준 쿼리와 타입 있는 링크
- 운영할 그래프 데이터베이스가 없음
- 코딩 에이전트 전용 설계, 20종 이상의 훅 제공
이 도구가 더 나은 부분
진짜 이중 시간(bi-temporal) 모델링, Cypher 그래프 쿼리, 사용자 정의 엔티티 타입이 있습니다. ai-memory는 설계상 수집 시각만 추적합니다.
결론 코딩용으로 셀프 호스팅한다면 옮기세요. 엔터프라이즈급 그래프 쿼리가 필요하면 그대로 쓰세요.
cognee그래프, 벡터, 관계형 파이프라인
그대로인 것
출처 추적, 피드백 가중 랭킹, Claude Code 플러그인.
새로 얻는 것
- 백업할 저장소는 markdown 폴더 하나
- 수집에 LLM 비용이 들지 않음
- 홈랩 서버에서 돌아가는 단일 바이너리
이 도구가 더 나은 부분
폭이 넓습니다. 14가지 이상의 검색 모드, 온톨로지 기반 그라운딩, PDF와 CSV, 웹 페이지 수집을 지원합니다.
결론 코딩 세션용 기억이 필요하면 옮기세요. 문서를 수집한다면 그대로 쓰세요.
OpenViking과 Hindsight살아 있는 문서형 메모리, LLM 필수
그대로인 것
백그라운드 통합 루프가 기억을 살아 있는 페이지로 정리합니다. ai-memory에도 옵트인 꿈 패스와 페이지별 신뢰도 점수가 있습니다.
새로 얻는 것
- LLM 호출 없이 동작하는 캡처, 검색, 인수인계
- 내가 소유하는 파일, MIT 라이선스, AGPL이나 SaaS 부담 없음
- 뱅크별 엄격한 격리 대신 프로젝트 단위 팀 공유
이 도구가 더 나은 부분
LLM을 끼운 구조라 보고된 정확도가 더 높습니다. Hindsight는 LongMemEval에서 91.4%를, OpenViking은 큰 폭의 토큰 절감을 보고합니다. 둘 다 벤더가 직접 밝힌 수치입니다. Hindsight의 신뢰 강도는 기본으로 랭킹에 반영됩니다. ai-memory의 것은 평가로 뒷받침되기 전까지 꺼져 있습니다.
결론 셀프 호스팅, 오프라인, 팀 용도라면 옮기세요. 그 정확도가 필요하고 LLM 필수 조건을 받아들일 수 있다면 그대로 쓰세요.
basic-memoryMCP로 쓰는 markdown 지식 베이스
그대로인 것
디스크의 markdown이 단일 진실 공급원이고, 인덱스는 파생됩니다.
새로 얻는 것
- 라이프사이클 훅을 통한 자동 캡처
- 이전 버전은 검색에서 빠지고, 콜드 세션 페이지는 퇴출되거나 압축됨
- 에이전트 간 인수인계와 다중 사용자 공유
이 도구가 더 나은 부분
로컬 cross-encoder 리랭커, 실시간 공동 편집, 호스팅형 모바일 앱이 있습니다.
결론 여러 에이전트로 코딩을 이어 가려면 옮기세요. Obsidian 스타일의 개인 지식 베이스가 목적이면 그대로 쓰세요.
mcp-memory-service가장 가까운 형제 프로젝트
그대로인 것
SQLite, 로컬 임베딩, 훅 캡처, 타입 있는 링크, 정직한 수치. 기억 노화도 같습니다: 계층별 감쇠, 압축, 클러스터 중복 제거, 모순 표시.
새로 얻는 것
- 사실 행 대신 읽을 수 있는 페이지
- 기본값이 꺼짐인 노화 기능, 다시 쓴 페이지는 모두 복원 가능
- 에이전트 사이에서 한 번만 수령되는 인수인계, 프로젝트 간 메시징
이 도구가 더 나은 부분
노화 기능이 설정 없이 알아서 동작합니다. 멀티 백엔드 복제와 그래프 시각화 도구도 있고, 세션 단위 점수도 0.860으로 약 0.82인 ai-memory보다 높습니다.
결론 훅 캡처가 마음에 들었고 모든 에이전트에서 쓰고 싶다면 옮기세요.
agentmemory이 프로젝트의 원조
그대로인 것
거의 모든 개념: 티어, 대체 처리, 감쇠, 융합 랭킹, 훅, LLM이 필요 없는 압축.
새로 얻는 것
- 사이드카 없이 혼자 동작하는 단일 바이너리
- 하나의 트랜잭션으로 커밋되는 실제 SQL 인덱스
- 파일이 단일 진실 공급원, Windows 동등 지원, 더 완전한 인증
이 도구가 더 나은 부분
순수 검색 성능이 약 13포인트 앞섭니다. 리랭킹을 하기 때문에 LongMemEval-S에서 약 0.82 대비 0.952를 보고합니다. P2P 동기화도 있습니다.
결론 운영 편의성과 데이터 소유권이 중요하면 옮기세요.
Letta와 MemGPT메모리 운영체제
그대로인 것
메모리 티어, 그리고 핫 패스 밖에서 이뤄지는 통합.
새로 얻는 것
- 이미 쓰는 에이전트 아래에 놓이는 기억
- 도입할 런타임이 없고, 자기 편집에 토큰을 쓰지 않음
이 도구가 더 나은 부분
완전한 에이전트 프레임워크와 개발 환경이 있고, 긴 호흡의 작업에서 일관성이 뛰어납니다.
결론 Letta 위에서 개발한다면 그대로 쓰세요. 코딩 에이전트가 기억하기만 하면 된다면 옮기세요.
Supermemory호스팅형 메모리 API
그대로인 것
자동 수집과 대체 처리를 갖춘 두 번째 뇌. 이 도구의 "dreaming" 패스는 ai-memory 꿈 패스의 출처 중 하나입니다.
새로 얻는 것
- 내가 소유하는, git으로 버전 관리되는 markdown
- 오프라인에서 동작
- 범위는 내 저장소. Supermemory는 범용 보관함
이 도구가 더 나은 부분
Drive, Gmail, Notion, S3용 매니지드 커넥터, 멀티모달 수집, 사용자 프로필이 있습니다.
결론 대상 고객이 다릅니다.
Honcho에이전트를 위한 사용자 모델링
그대로인 것
memory_query의 인용이 붙은 답변, 추론 수준, 그리고 유휴 상태일 때 실행되어 가장 새로운 내용부터 처리하는 꿈 패스.
새로 얻는 것
- 같은 편의 기능, 캡처와 검색에는 LLM 불필요
- 서비스 세 개 대신 단일 바이너리와 폴더 하나
- 저장소 단위로 범위가 정해지고 팀과 공유되는 기억
이 도구가 더 나은 부분
사람마다 무엇을 알고 무엇을 믿는지 모델링하는 추론 엔진이 있습니다. 사용자에 관한 사실을 회상하는 LongMemEval-S에서 90.4%를 보고하는데, 이는 다른 과제에 대한 벤더 발표치입니다.
결론 다른 문제를 풉니다. Honcho는 사용자를 기억하고, ai-memory는 프로젝트를 기억합니다.
"이 도구가 더 나은 부분" 항목은 프로젝트의 자체 점검에서 가져왔습니다. GitHub에서 전체 비교와 자기비판적 패리티 점검을 읽어 보세요.
벤치마크와 그 단서들
ai-memory는 수치를 하나만 공개합니다. 저장소에 포함된 하네스로 LongMemEval-S에서 측정한 값입니다. 리랭킹을 하는 시스템은 더 높은 점수를 냅니다.
- ai-memory 2.0 이전전문 검색만0.617
- ai-memory, 전문 검색만불용어 필터링 추가0.666
- ai-memory 기본값로컬 임베딩, API 키 없음0.815
- mcp-memory-service벤더 발표치, 세션 단위0.860
- agentmemory벤더 발표치, 리랭킹 포함0.952
- hit@5는 근거가 담긴 세션이 상위 5개 결과 안에 있는지를 봅니다. 검색 성능을 측정하는 지표이며, 답변 정확도에 대해서는 아무것도 말해 주지 않습니다.
- 500개 질문 중 470개를 채점합니다. 답변 보류(abstention) 질문 30개는 제외됩니다. 실행 시점은 2026년 9월 21일입니다. 같은 커밋에서 한 번 더 실행한 점수는 0.821였으므로, 기본 점수는 약 0.82로 읽으면 됩니다.
- 기본 인프로세스 임베딩 모델을 쓴 값이 0.815이며, API 키도 LLM도 없습니다. 전문 검색, 엔티티, 링크만 쓴 값이 0.666입니다.
- 어떤 경쟁 도구와도 직접 맞대결한 실행은 없습니다. Hindsight의 91.4% 같은 정확도 수치는 다른 지표이므로 hit@5와 비교할 수 없습니다.
- 저장되는 발췌문은 프라이버시를 위해 2 KB로 제한되므로, 긴 턴 하나의 깊숙한 곳에 있는 근거는 찾을 수 없습니다. 벤치마크는 실제 배포되는 시스템을 측정합니다.
- LongMemEval은 채팅 어시스턴트의 대화 기록입니다. 코딩 세션용 벤치마크는 계획 중이며 아직 없습니다.
체크아웃에서 직접 재현해 보세요. 벤치마크 노트에 데이터셋 해시와 슬라이스별 결과가 있습니다.
# 테스트 대상 서버
cargo build --release -p ai-memory-cli
# 전체 실행. --fetch는 데이터셋을 내려받고 해시를 확인합니다
cargo run --release -p ai-memory-eval -- retrieval --fetch
# 질문 10개짜리 스모크 테스트
cargo run -p ai-memory-eval -- retrieval --sample 10
ai-memory가 뒤처진 부분
이 목록은 저장소의 자체 점검에서 가져왔습니다. 이 중 하나가 꼭 필요하다면 지금 쓰는 도구에 머무르세요.
로컬 리랭커가 없습니다
검색 점수는 리랭킹을 하는 시스템보다 낮습니다. 리랭커는 LLM 방식 하나뿐이고 기본값은 꺼짐입니다. 인용이 붙은 답변도 LLM이 필요하며, 정확도는 아직 평가하지 않았습니다.
링크 타입이 랭킹에 반영되지 않습니다
한 페이지에서 관련 페이지로 따라갈 수 있습니다. 검색에서는 링크의 종류가 여전히 결과를 설명할 뿐이고 가중치는 없습니다.
노화 기능은 검증되지 않았습니다
신뢰도 점수, 압축, 중복 제거, 꿈 패스는 기본값이 꺼짐입니다. 이들에 대한 회상 평가는 실행한 적이 없으므로, 프로젝트는 메커니즘만 주장하고 측정된 향상은 주장하지 않습니다.
타임라인이 하나입니다
시점 지정 검색은 사실이 기록된 시각을 사용합니다. Zep은 어떤 일이 일어난 시점과 그것을 알게 된 시점을 둘 다 모델링합니다.
코딩 세션의 텍스트만 다룹니다
PDF, CSV, 이미지는 수집하지 않고, 비전 모델도 없으며, Cypher로 쿼리할 수 있는 그래프 데이터베이스도 아닙니다.
서버 하나, 호스팅 티어 없음
여러 컴퓨터가 직접 운영하는 서버 하나에 접속합니다. 자동 복제도, SaaS도, 엔터프라이즈 콘솔도 없습니다.
내장 메모리보다 설정할 것이 많습니다
Claude Code의 자체 메모리는 이미 켜져 있습니다. ai-memory는 혼자 일하는 개발자에게도 서버부터 띄우라고 요구합니다.
옮기는 방법
한 번에 갈아탈 필요는 없습니다. 비교하는 동안 두 도구를 같은 프로젝트에서 함께 돌릴 수 있습니다.
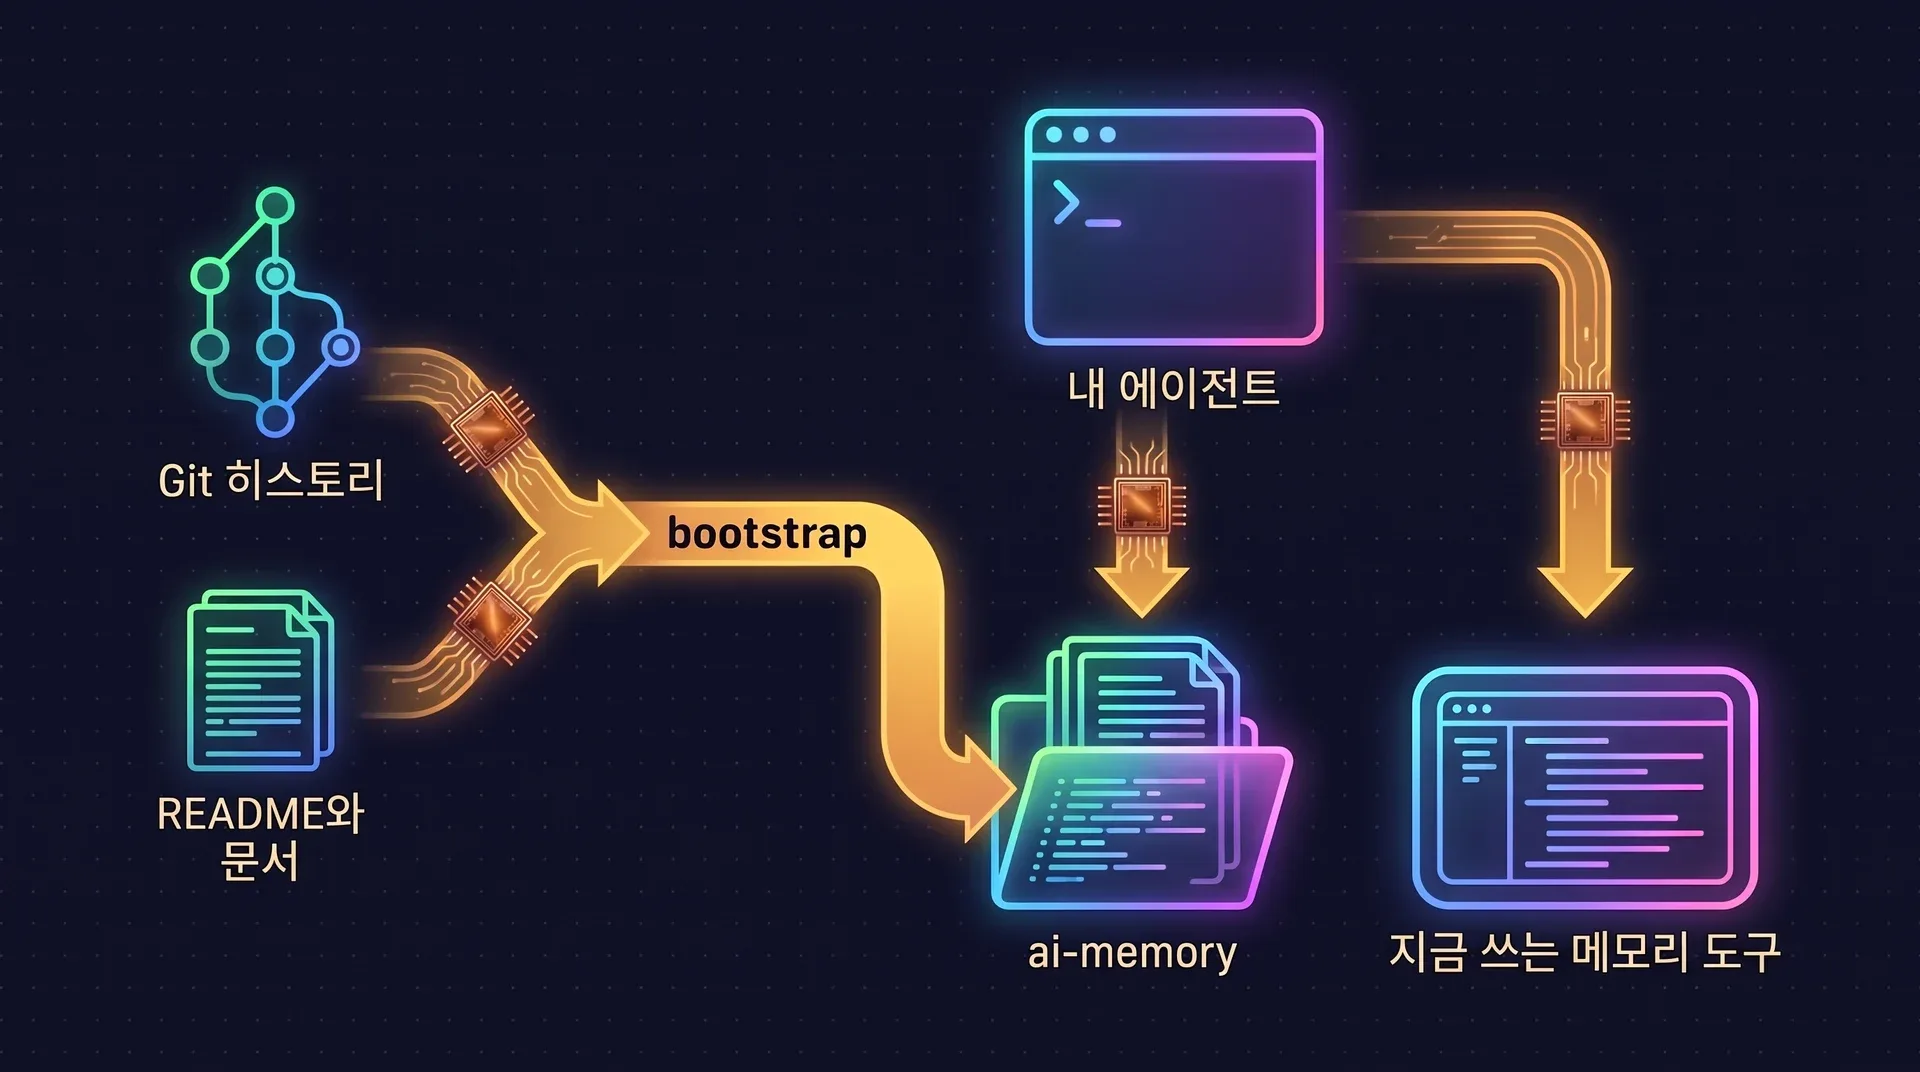
지금 쓰는 도구 옆에 설치합니다
ai-memory는 자체 MCP 항목과 자체 훅을 추가하고, 다른 도구의 항목은 그대로 둡니다. 명령어는 빠른 설치에 있습니다.
프로젝트 자체에서 위키 초기 페이지를 만듭니다
ai-memory bootstrap은 git 히스토리, README,docs/, 에이전트 규칙 파일을 읽고 초기 페이지를 작성합니다. LLM 제공자가 필요합니다. 먼저 드라이 런으로 무엇이 전송되는지 확인하세요. 결과물도 검토하세요. LLM은 그럴듯하지만 틀린 내용을 쓸 수 있고, 위키는 git에 있으니 되돌릴 수 있습니다.기존 프로젝트 cd /path/to/project ai-memory bootstrap --dry-run ai-memory bootstrap임포터가 읽을 수 있다면 예전 노트와 대화도 가져옵니다
companions/ai-memory-importer에 있는 독립 실행형 임포터가 현재 읽는 것은 두 가지입니다. oh-my-claudecode(OMC) markdown 위키 폴더, 그리고 작은 범용 JSON 엔벨로프에 담긴 대화입니다. Mem0, Zep, cognee용 어댑터는 없으므로, 이들의 내보내기 파일은 먼저 엔벨로프 형식으로 변환해야 합니다. 기본값은 드라이 런이며 아무것도 삭제하지 않습니다.드라이 런, 저장소의 체크아웃에서 cargo run --manifest-path companions/ai-memory-importer/Cargo.toml -- \ omc-wiki --dir /path/to/omc/wiki --workspace default --project my-project한동안 둘 다 돌려 보고 결정합니다
비교하는 동안 기존 도구도 연결해 두세요. 프로젝트에 대해 같은 질문을 양쪽에 해 보세요. 더 이상 손이 가지 않는 쪽을 제거하면 됩니다.
임포터의 형식과 안전 규칙은 컴패니언 크레이트 가이드에 있습니다. 문서를 가져오는 다른 방법은 쿡북에 있습니다.
갈아타기 전에 많이 묻는 질문
LLM API 키가 필요한가요?
아니요. 캡처, 검색, 인수인계는 키도 LLM도 없이 동작합니다. 제공자를 추가하면 LLM 통합, 부트스트랩, 더 풍부한 린트, 자동 개선, 선택적 리랭킹이 켜집니다. Codex나 GitHub Copilot 같은 구독 로그인도 제공자로 쓸 수 있습니다.
호스팅 버전이 있나요?
아니요. ai-memory는 노트북, 홈랩 서버, LAN 호스트에서 직접 운영하는 단일 서버입니다. SaaS 티어도 엔터프라이즈 콘솔도 없습니다.
Mem0, Zep, cognee의 데이터를 가져올 수 있나요?
직접은 안 됩니다. 컴패니언 임포터는 oh-my-claudecode markdown 위키와 범용 대화 JSON 형식을 읽습니다. 특정 제품용 어댑터는 저장소 밖에 있습니다. 기존 코드베이스라면 ai-memory bootstrap이 git 히스토리와 문서로 위키 초기 페이지를 만듭니다.
지금 쓰는 메모리 도구와 ai-memory를 함께 돌릴 수 있나요?
네. 자체 MCP 서버 항목과 자체 라이프사이클 훅으로 설치되며, 다른 도구의 설정은 건드리지 않습니다. 한쪽을 제거하기 전에 같은 프로젝트에서 둘을 비교할 수 있습니다.
검색 점수는 다른 도구와 비교해 어떤가요?
LongMemEval-S에서 hit@5는 기본 로컬 임베딩으로 0.815, 전문 검색만으로 0.666입니다. 이 수치는 검색 성능을 측정하며 답변 정확도에 대해서는 아무것도 말해 주지 않습니다. 리랭킹을 하는 시스템은 더 높습니다. 세션 단위 기준으로 agentmemory는 0.952, mcp-memory-service는 0.860을 발표했습니다.
컴퓨터 간에 기억을 동기화하나요?
모든 컴퓨터가 네트워크로 접속하는 서버 하나를 씁니다. 서버 간 자동 복제는 없습니다.