
פתרונות
מעבר מכלי זיכרון אחר
כל כלי זיכרון בנוי סביב הימור אחד. הדף הזה אומר למה כל אחד מהם מיועד, מה משתנה אם עוברים, ואיפה ai-memory הוא הבחירה החלשה יותר.
כל כלי ממטב דבר אחד
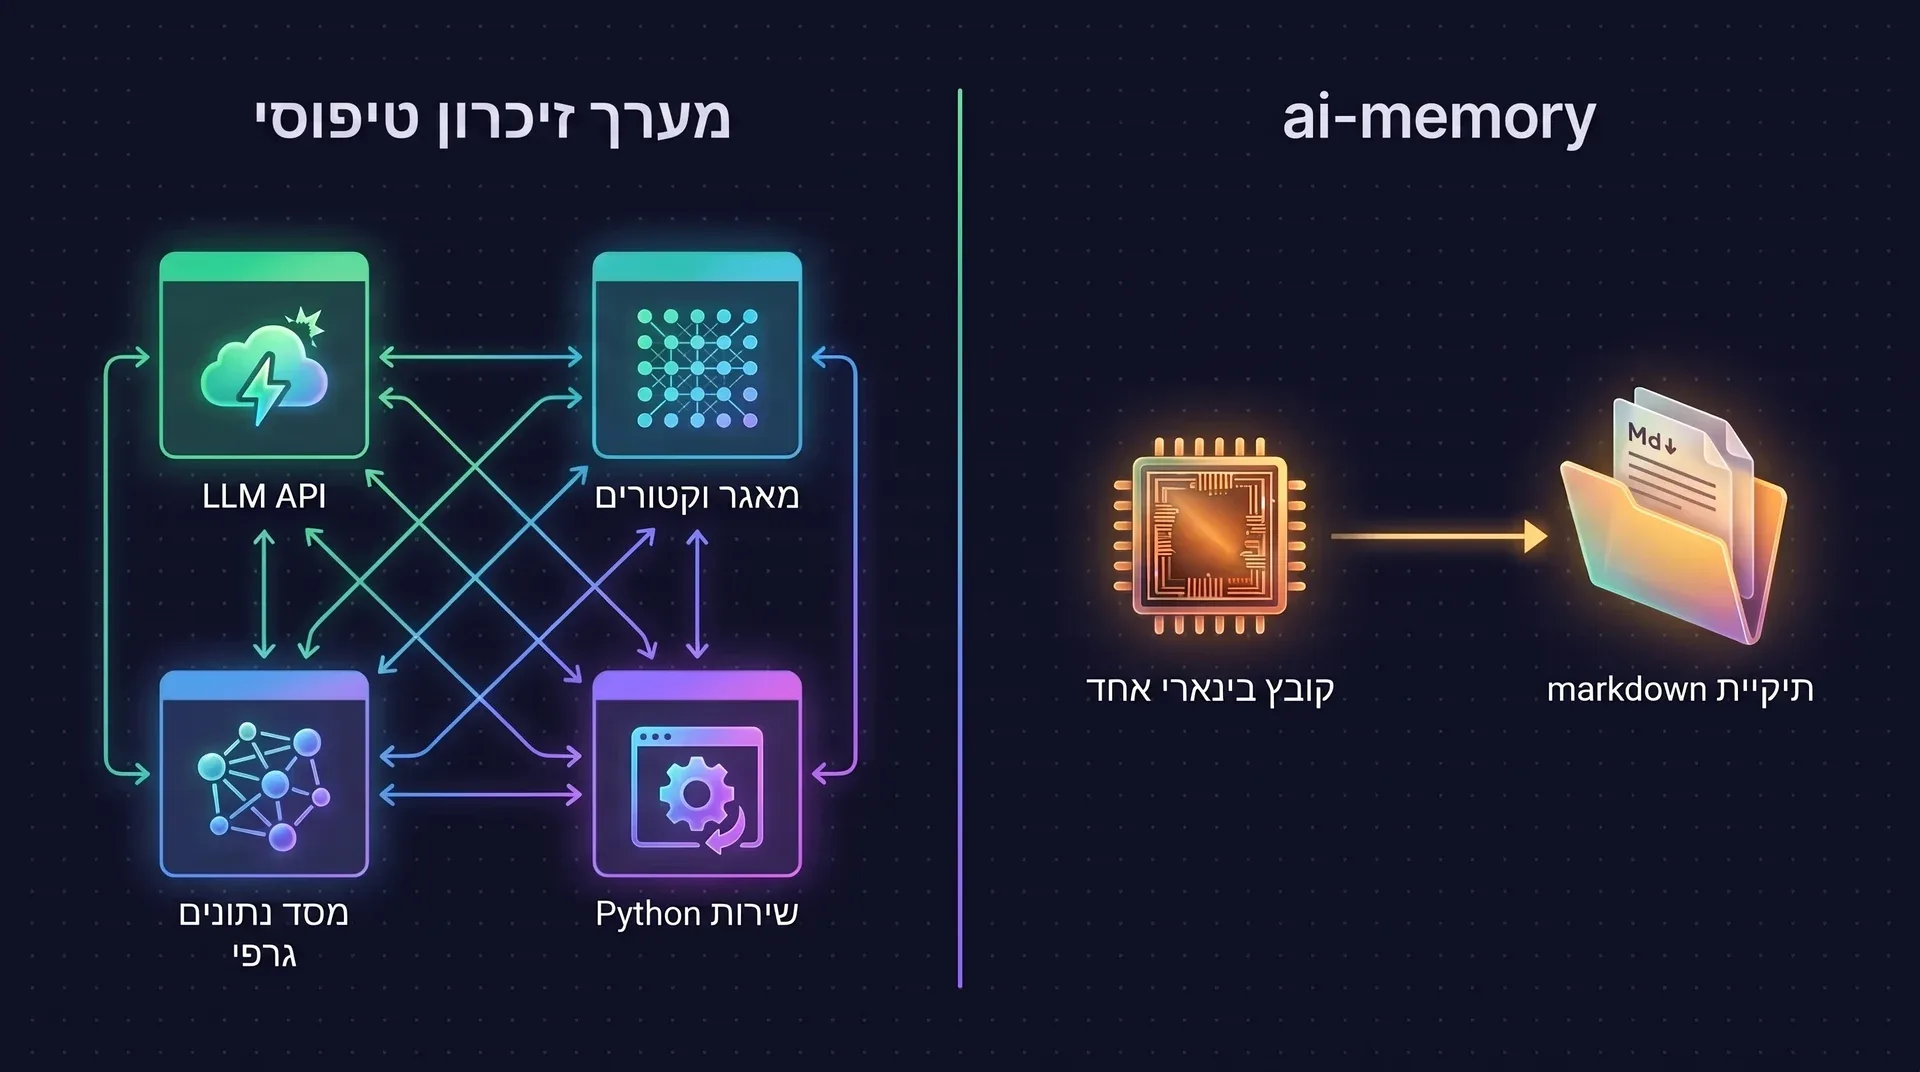
ai-memory ממטב ויקי מגובה git של דפי markdown עם אינדקס חיפוש נגזר, וכברירת מחדל הוא לא מבצע אף קריאה ל-LLM. האחרים הימרו אחרת, עבור קהלים אחרים.
מחלצי עובדות
Mem0 ו-LangMem מבקשים מ-LLM לחלץ עובדות אטומיות מכל תור בשיחה, כדי להתאים אפליקציה אישית למשתמשי הקצה שלה.
גרפים טמפורליים
Zep, Graphiti ו-cognee ממדלים ידע כגרף לאורך זמן. הם משרתים שאילתות גרף ורצים מעל מסד נתונים גרפי.
מערכות הפעלה לזיכרון
Letta ו-MemGPT נותנים לסוכן לערוך בעצמו זיכרון שבנוי בשכבות. הם מתאימים למי שמאמץ את ה-runtime שלהם לסוכנים.
API מתארח
Supermemory ושירותי הענן המנוהלים שומרים את הזיכרון שלכם מאחורי חשבון, ובתמורה נותנים מחברים ואפס תפעול.
מה שאין לאף כלי אחר במלואו
הפרויקט בדק את המתחרים שלו מול הקוד של עצמו. לרובם יש אחד או שניים מששת אלה, ולאף אחד אין את כל השישה.
אפס קריאות ל-LLM כברירת מחדל
לכידה, חיפוש והעברות מקל עובדים בלי מפתח API.
הקבצים הם מקור האמת
תיקיית markdown מגובה git. מסד הנתונים הוא אינדקס שאפשר לבנות מחדש.
קובץ בינארי עצמאי אחד
רץ בלי מסד נתונים גרפי, בלי runtime של Python ובלי תהליך sidecar.
כל סוכן, אוטומטית
hooks של מחזור החיים ליותר מ-20 סוכני קוד.
העברות מטופסות שנתפסות פעם אחת
פרוטוקול: לכל העברה יש סוג ובעלים, ורק סשן אחד יכול לתפוס אותה.
צוותים בלי מסלול בתשלום
חשבונות, ייחוס ויומן ביקורת כלולים מהקופסה.
מה צריך להריץ
הדרך המהירה ביותר להשוות כלי זיכרון היא לספור כמה שירותים כל אחד צריך לפני שהוא זוכר משהו.
| כלי | LLM | שירות וקטורים או embeddings | מסד נתונים גרפי | runtime או מסד נתונים נוסף | חשבון ענן | מה הוא צריך |
|---|---|---|---|---|---|---|
| ai-memory | אופציונלי | לא נדרש | לא נדרש | לא נדרש | לא נדרש | קובץ בינארי אחד ותיקיית markdown |
| הזיכרון המובנה של Claude Code | לא נדרש | לא נדרש | לא נדרש | לא נדרש | לא נדרש | Claude Code · מחשב אחד |
| Mem0 ו-LangMem | נדרש | נדרש | לא נדרש | לא נדרש | לא נדרש | LLM בכל תור · מאגר וקטורים |
| Zep ו-Graphiti | נדרש | לא נדרש | נדרש | לא נדרש | לא נדרש | Neo4j, FalkorDB או Neptune · LLM |
| cognee | נדרש | נדרש | נדרש | נדרש | לא נדרש | שלושה מאגרים מסונכרנים · קריאת LLM לכל chunk · Python |
| OpenViking ו-Hindsight | נדרש | נדרש | לא נדרש | נדרש | לא נדרש | LLM או VLM · Embeddings · Postgres או שירות מנוהל |
| basic-memory | לא נדרש | לא נדרש | לא נדרש | לא נדרש | לא נדרש | אותך, בכתיבת הערות ידנית |
| mcp-memory-service | לא נדרש | לא נדרש | לא נדרש | לא נדרש | לא נדרש | בעיקר Claude Code |
| agentmemory | לא נדרש | לא נדרש | לא נדרש | נדרש | לא נדרש | sidecar של Node · יותר מ-50 כלי MCP |
| Letta ו-MemGPT | לא נדרש | לא נדרש | לא נדרש | נדרש | לא נדרש | אימוץ ה-runtime שלהם לסוכנים |
| Supermemory | לא נדרש | לא נדרש | לא נדרש | לא נדרש | נדרש | חשבון ענן · הוצאות API |
| Honcho | נדרש | לא נדרש | לא נדרש | נדרש | לא נדרש | LLM · Postgres, Redis ו-worker |
- נדרש
- אופציונלי
- ai-memory לא צריך את זה
- לא נדרש
בשלוש שורות אין סימונים. הזיכרון של Claude Code מובנה, וגם basic-memory ו-mcp-memory-service קלים להרצה. ההבדלים ביניהם מופיעים בחלק הבא.
כלי אחרי כלי
פותחים את הכלי שבשימוש. כל בלוק אומר מה נשאר אותו דבר, מה מרוויחים, ואיפה הכלי ההוא מנצח.
הזיכרון המובנה של Claude Codeקובץ MEMORY.md לכל לפטופ
מה נשאר אותו דבר
הנוחות של "תזכור את הפרויקט שלי", ב-markdown.
מה מרוויחים
- אותו זיכרון ב-Codex, Cursor, Gemini CLI ועוד 20
- מסונכרן בין המחשבים שלך
- משותף עם הצוות
- חיפוש אמיתי, ולכידה של מה שהכלים עשו בפועל
איפה הוא מנצח
אפס התקנה. הוא כבר פועל, ואין שרת להריץ. למפתח אחד על מחשב אחד שמשתמש רק ב-Claude Code, ייתכן שזה כל מה שצריך.
השורה התחתונה עוברים כשמוסיפים סוכן שני, מחשב שני או אדם שני.
Mem0 ו-LangMemמחלצי עובדות
מה נשאר אותו דבר
לכידה אוטומטית, בלי טקס של "תזכור את זה".
מה מרוויחים
- דפים קריאים שאפשר לפתוח ולערוך, במקום שורות עובדות אטומות
- חיפוש שמשלב טקסט מלא, ישויות, קישורים ווקטורים
- בלי הוצאות API על לכידה או חיפוש
איפה הוא מנצח
אקוסיסטם גדול של SDKs וענן מנוהל שנבנה להתאמה אישית של אפליקציות למשתמשי קצה.
השורה התחתונה קהל אחר. Mem0 זוכר את המשתמשים של האפליקציה שלך. ai-memory זוכר את ה-repository שלך.
Zep ו-Graphitiגרף ידע טמפורלי
מה נשאר אותו דבר
עובדות מוחלפות בחדשות ולעולם לא נמחקות. אפשר לשאול מה היה נכון בנקודת זמן מסוימת.
מה מרוויחים
- שאילתות לנקודת זמן וקישורים מטופסים, על קובץ בינארי אחד עם SQLite
- בלי מסד נתונים גרפי להריץ
- מותאם לסוכני קוד, עם hooks ליותר מ-20 מהם
איפה הוא מנצח
מידול bi-temporal אמיתי, שאילתות גרף ב-Cypher וסוגי ישויות מותאמים. ai-memory עוקב רק אחרי זמן ההזנה, וזו החלטת תכנון.
השורה התחתונה עוברים אם מריצים באירוח עצמי לצורכי קוד. נשארים אם צריך שאילתות גרף ברמת enterprise.
cogneeצינור עיבוד של גרף, וקטורים ומסד רלציוני
מה נשאר אותו דבר
מעקב אחרי מקור המידע, דירוג שמשוקלל לפי פידבק ופלאגין ל-Claude Code.
מה מרוויחים
- מאגר אחד לגבות: תיקיית markdown
- בלי חשבון LLM על הזנת נתונים
- קובץ בינארי יחיד שרץ על מכונת homelab
איפה הוא מנצח
רוחב: יותר מ-14 מצבי אחזור, עיגון באונטולוגיה, והזנה של קובצי PDF, קובצי CSV ודפי אינטרנט.
השורה התחתונה עוברים אם רוצים זיכרון לסשנים של קוד. נשארים אם מזינים מסמכים.
OpenViking ו-Hindsightזיכרון של מסמכים חיים, מחייב LLM
מה נשאר אותו דבר
זיכרון שלולאת איחוד ברקע מרכיבה לדפים חיים. ל-ai-memory יש סבב חלום שהוא opt-in וציון ביטחון לכל דף.
מה מרוויחים
- לכידה, חיפוש והעברות מקל (handoffs) בלי אף קריאה ל-LLM
- קבצים בבעלותך, ברישיון MIT, בלי המשקל של AGPL או SaaS
- שיתוף צוותי לפי פרויקט, במקום בידוד קשיח לכל bank
איפה הוא מנצח
דיוק מדווח גבוה יותר כשיש LLM בלולאה: Hindsight מדווח על 91.4% ב-LongMemEval, ו-OpenViking מדווח על חיסכון גדול בטוקנים. שני המספרים הם של היצרנים עצמם. אצל Hindsight עוצמת האמונה (belief strength) משפיעה על הדירוג כברירת מחדל. אצל ai-memory היא כבויה עד שהערכה תתמוך בה.
השורה התחתונה עוברים בשביל אירוח עצמי, עבודה אופליין או שימוש צוותי. נשארים אם צריך את הדיוק שלהם ומקבלים את הדרישה ל-LLM.
basic-memoryבסיס ידע ב-markdown מעל MCP
מה נשאר אותו דבר
קובצי markdown בדיסק הם מקור האמת, ולצידם אינדקס נגזר.
מה מרוויחים
- לכידה אוטומטית מ-hooks של מחזור החיים
- גרסאות ישנות יוצאות מהחיפוש, ודפי סשן קרים מפונים או מצומצמים
- העברות בין סוכנים ושיתוף בין כמה משתמשים
איפה הוא מנצח
reranker מקומי מסוג cross-encoder, עריכה שיתופית בזמן אמת ואפליקציית מובייל מנוהלת.
השורה התחתונה עוברים בשביל רציפות בעבודת קוד עם כמה סוכנים. נשארים בשביל בסיס ידע אישי בסגנון Obsidian.
mcp-memory-serviceהקרוב ביותר במשפחה
מה נשאר אותו דבר
SQLite, embeddings מקומיים, לכידה דרך hooks, קישורים מטופסים ומספרים כנים. גם התיישנות הזיכרון דומה: דעיכה לפי שכבה, צמצום, dedup לפי אשכולות וסימון סתירות.
מה מרוויחים
- דפים שאפשר לקרוא במקום שורות עובדות
- התיישנות שכבויה כברירת מחדל, וכל שכתוב אפשר לשחזר
- העברות בין סוכנים שנתפסות פעם אחת בלבד, והודעות בין פרויקטים
איפה הוא מנצח
ההתיישנות אצלו רצה מעצמה, בלי שום הגדרה. יש לו גם רפליקציה בין כמה backends וכלי ויזואליזציה לגרף, והציון שלו ברמת הסשן, 0.860, גבוה מזה של ai-memory, שהוא בערך 0.82.
השורה התחתונה עוברים אם אהבתם לכידה דרך hooks ורוצים אותה בכל סוכן.
agentmemoryהאב הקדמון של הפרויקט הזה
מה נשאר אותו דבר
כמעט כל הרעיונות: שכבות, החלפת עובדות ישנות, דעיכה, דירוג משולב, hooks, ודחיסה שלא צריכה LLM.
מה מרוויחים
- קובץ בינארי עצמאי אחד, בלי sidecar
- אינדקסים אמיתיים ב-SQL שנכתבים בטרנזקציה אחת
- קבצים כמקור האמת, תמיכה שווה ב-Windows ואימות מלא יותר
איפה הוא מנצח
בערך 13 נקודות באחזור גולמי: הוא מדווח על 0.952 ב-LongMemEval-S מול בערך 0.82, כי הוא עושה rerank. יש לו גם סנכרון peer-to-peer.
השורה התחתונה עוברים בשביל תפעול פשוט ובעלות על הנתונים.
Letta ו-MemGPTמערכת הפעלה לזיכרון
מה נשאר אותו דבר
שכבות זיכרון ואיחוד מחוץ למסלול החם.
מה מרוויחים
- זיכרון שיושב מתחת לסוכן שכבר בשימוש
- בלי runtime לאמץ, בלי טוקנים שהולכים על עריכה עצמית
איפה הוא מנצח
framework מלא לסוכנים וסביבת פיתוח, עם קוהרנטיות טובה במשימות ארוכות.
השורה התחתונה נשארים אם בונים על Letta. עוברים אם רק רוצים שסוכן הקוד יזכור.
SupermemoryAPI זיכרון מנוהל בענן
מה נשאר אותו דבר
מוח שני עם הזנה אוטומטית והחלפת עובדות ישנות. סבב ה-"dreaming" שלו הוא אחד המקורות לסבב החלום של ai-memory.
מה מרוויחים
- קובצי markdown בבעלותך, עם גרסאות ב-git
- עובד אופליין
- ממוקד ב-repository שלך, בעוד Supermemory הוא כספת כללית
איפה הוא מנצח
מחברים מנוהלים ל-Drive, Gmail, Notion ו-S3, הזנה מולטימודלית ופרופילי משתמשים.
השורה התחתונה קהל אחר.
Honchoמידול משתמשים לסוכנים
מה נשאר אותו דבר
תשובות עם ציטוטים מ-memory_query, רמות reasoning, וסבב חלום שרץ כשאין פעילות ומטפל קודם בחומר החדשני ביותר.
מה מרוויחים
- אותן נוחויות, בלי לחייב LLM בשביל לכידה או חיפוש
- קובץ בינארי אחד ותיקייה במקום שלושה שירותים
- זיכרון בהיקף של repository, משותף לצוות
איפה הוא מנצח
מנוע reasoning שממדל מה כל אדם יודע ובמה הוא מאמין. הוא מדווח על 90.4% ב-LongMemEval-S בשליפת עובדות על משתמש, מספר של היצרן על משימה אחרת.
השורה התחתונה בעיה אחרת: Honcho זוכר את המשתמש, ו-ai-memory זוכר את הפרויקט.
שורות "איפה הוא מנצח" מגיעות מהביקורת של הפרויקט על עצמו. ב-GitHub אפשר לקרוא את ההשוואה המלאה ואת ביקורת הפערים העצמית.
הבנצ'מרק, עם ההסתייגויות שלו
ai-memory מפרסם מספר אחד, שנמדד על LongMemEval-S עם harness שנמצא ב-repository. מערכות שעושות rerank מקבלות ציון גבוה יותר.
- ai-memory לפני 2.0טקסט מלא בלבד0.617
- ai-memory, טקסט מלא בלבדנוסף סינון stopwords0.666
- ai-memory, ברירת מחדלembeddings מקומיים, בלי מפתח API0.815
- mcp-memory-serviceדיווח של היצרן, ברמת סשן0.860
- agentmemoryדיווח של היצרן, עם reranking0.952
- hit@5 בודק אם סשן שמכיל את הראיה נמצא בין חמש התוצאות הראשונות. הוא מודד אחזור. הוא לא אומר דבר על דיוק התשובות.
- 470 מתוך 500 השאלות מקבלות ציון. 30 שאלות ההימנעות לא נכללות. ההרצה היא מ-21 בספטמבר 2026. הרצה שנייה על אותו commit קיבלה 0.821, ולכן כדאי לקרוא את ציון ברירת המחדל כבערך 0.82.
- 0.815 מתקבל עם מודל ה-embeddings שרץ בתוך התהליך כברירת מחדל, בלי מפתח API ובלי LLM. 0.666 הוא טקסט מלא, ישויות וקישורים בלבד.
- אין אף הרצה ראש בראש מול מתחרה כלשהו. נתוני דיוק כמו 91.4% של Hindsight הם מדד אחר, ואי אפשר להשוות אותם ל-hit@5.
- קטעים שמורים מוגבלים ל-2 KB מטעמי פרטיות, כך שראיה שנמצאת עמוק בתוך תור ארוך אחד לא תימצא. הבנצ'מרק מודד את המערכת כפי שהיא משוחררת.
- LongMemEval הוא היסטוריה של עוזר צ'אט. בנצ'מרק של סשנים של קוד מתוכנן ועדיין לא קיים.
אפשר לשחזר את זה מתוך checkout. בהערות הבנצ'מרק מופיעים ה-hash של ה-dataset והתוצאות לפי חתך.
# השרת הנבדק
cargo build --release -p ai-memory-cli
# ההרצה המלאה; --fetch מוריד את ה-dataset ובודק את ה-hash שלו
cargo run --release -p ai-memory-eval -- retrieval --fetch
# בדיקת smoke של עשר שאלות
cargo run -p ai-memory-eval -- retrieval --sample 10
איפה ai-memory מפגר
הרשימה הזאת מגיעה מהביקורת של ה-repository על עצמו. אם אחד מאלה הוא מה שאתם צריכים, כדאי להישאר איפה שאתם.
אין reranker מקומי
ציוני האחזור נמוכים מאלה של מערכות שעושות rerank. ה-reranker היחיד הוא LLM, והוא כבוי כברירת מחדל. גם התשובות עם הציטוטים צריכות LLM, והדיוק שלהן עוד לא הוערך.
סוגי הקישורים לא משפיעים על הדירוג
אפשר לעבור מדף אל הדפים שקשורים אליו. בחיפוש, סוג הקישור עדיין רק מסביר תוצאה ואין לו שום משקל.
יכולות ההתיישנות לא הוכחו
ציון הביטחון, הצמצום, ה-dedup וסבב החלום כבויים כברירת מחדל. לא הורצה עליהם הערכת שליפה, ולכן הפרויקט טוען למנגנון ולא לשיפור מדוד.
ציר זמן אחד
חיפוש לנקודת זמן משתמש בזמן שבו העובדה נרשמה. Zep ממדל גם מתי משהו קרה וגם מתי נודע עליו.
רק טקסט מסשנים של קוד
הוא לא מזין קובצי PDF, CSV או תמונות, אין לו מודל ראייה, והוא לא מסד נתונים גרפי שאפשר לתשאל עם Cypher.
שרת אחד, בלי מסלול מתארח
הרבה מחשבים מגיעים לשרת אחד שמריצים בעצמכם. אין רפליקציה אוטומטית, אין SaaS ואין קונסולת enterprise.
יותר התקנה מזיכרון מובנה
הזיכרון של Claude Code כבר פעיל. ai-memory מבקש ממפתח עצמאי להעלות קודם שרת.
איך עוברים
לא חייבים לעבור בבת אחת. שני הכלים יכולים לרוץ על אותו פרויקט בזמן שמשווים ביניהם.
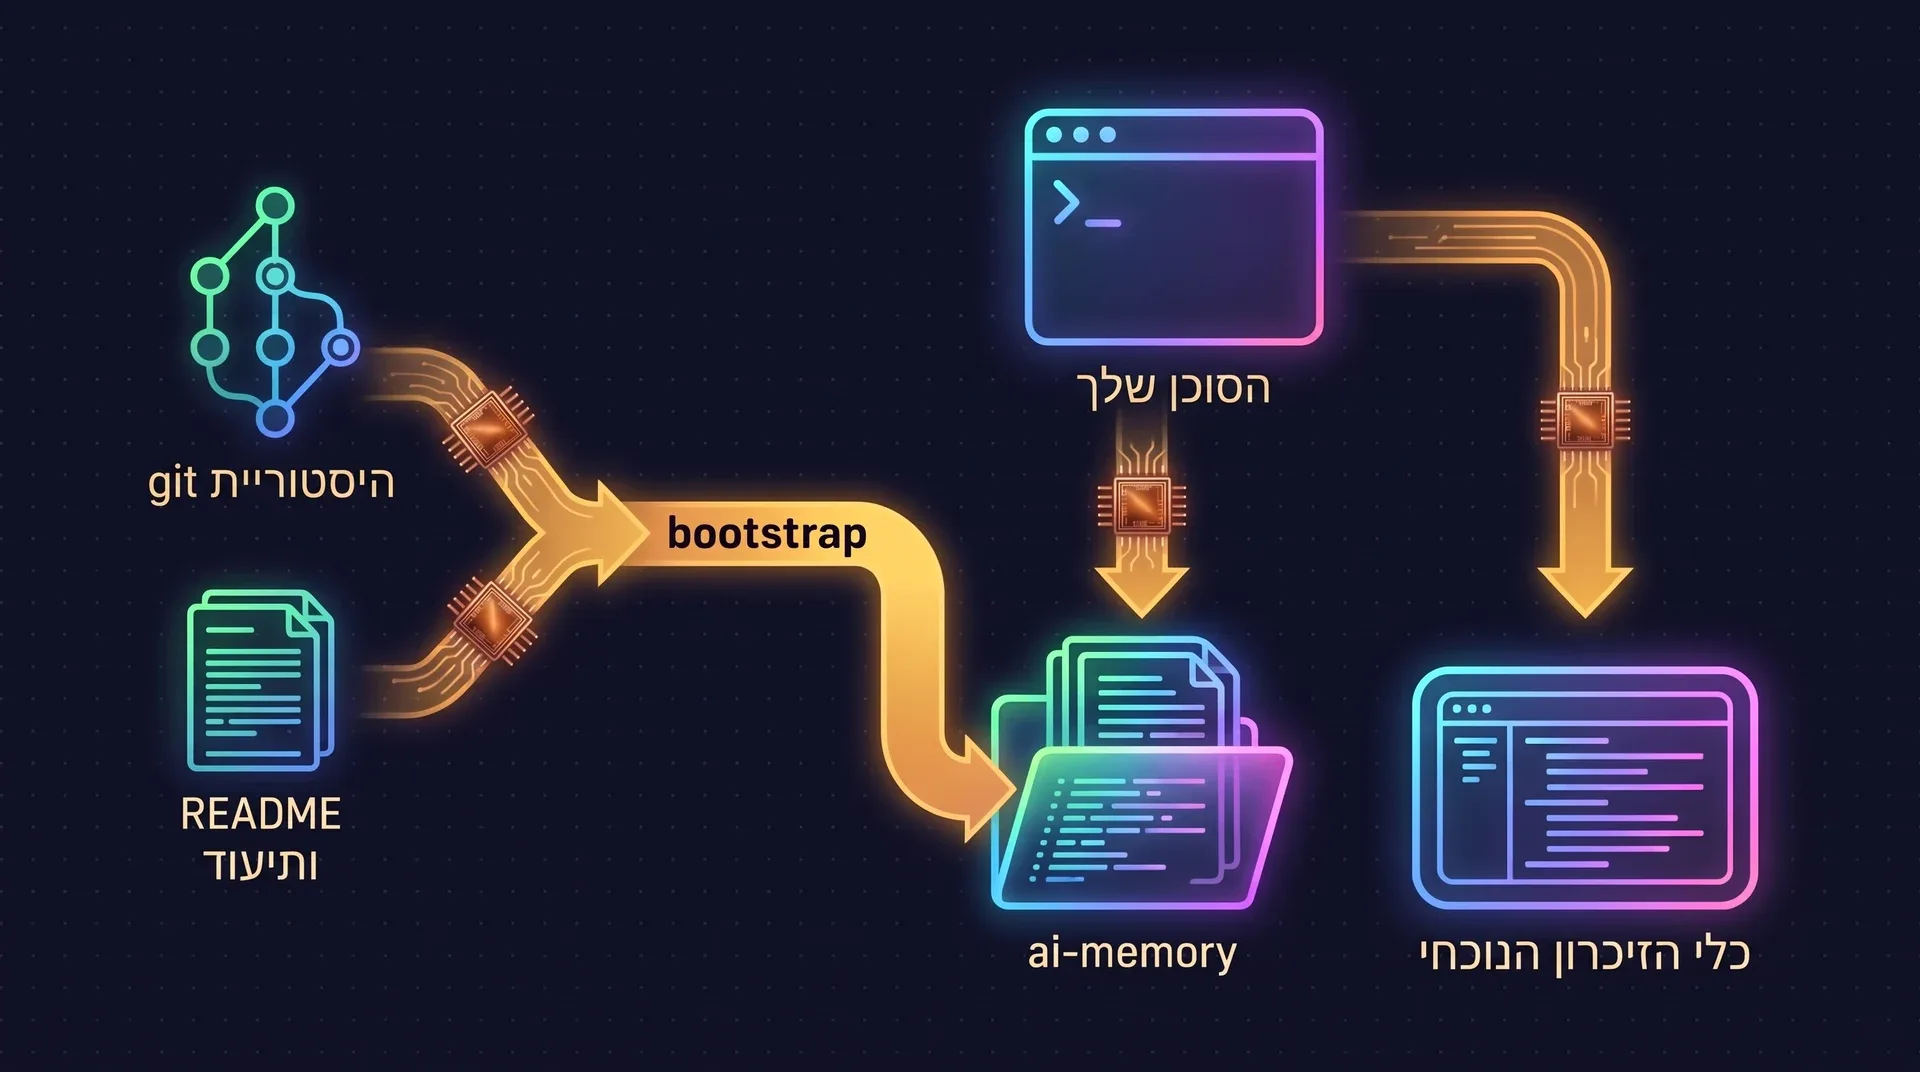
מתקינים אותו לצד מה שכבר יש
ai-memory מוסיף רשומת MCP משלו ו-hooks משלו, ומשאיר במקום את הרשומות של כלים אחרים. הפקודות נמצאות בהתקנה המהירה.
זורעים את הוויקי מתוך הפרויקט עצמו
ai-memory bootstrapקורא את היסטוריית ה-git, את ה-README, אתdocs/ואת קובצי הכללים של הסוכנים, ואז כותב דפי התחלה. הוא צריך ספק LLM. קודם מריצים הרצת ניסיון (dry run) כדי לראות מה יישלח. כדאי לעבור על מה שנכתב: LLM יכול לכתוב פרטים סבירים שהם שגויים, והוויקי נמצא ב-git אז אפשר לעשות revert.פרויקט קיים cd /path/to/project ai-memory bootstrap --dry-run ai-memory bootstrapמביאים הערות ושיחות ישנות, אם ה-importer קורא אותן
ה-importer העצמאי שתחת
companions/ai-memory-importerקורא היום שני דברים: תיקיות ויקי של markdown מ-oh-my-claudecode (OMC), ושיחות במעטפת JSON גנרית קטנה. אין לו מתאם ל-Mem0, ל-Zep או ל-cognee, אז ייצוא מהם צריך קודם המרה למעטפת הזאת. ברירת המחדל שלו היא הרצת ניסיון, והוא אף פעם לא מוחק.הרצת ניסיון, מתוך checkout של ה-repo cargo run --manifest-path companions/ai-memory-importer/Cargo.toml -- \ omc-wiki --dir /path/to/omc/wiki --workspace default --project my-projectמריצים את שניהם תקופה, ואז מחליטים
משאירים את הכלי הישן מחובר בזמן ההשוואה. שואלים את שניהם את אותן שאלות על הפרויקט. מסירים את זה שהפסקתם לפנות אליו.
הפורמטים וכללי הבטיחות של ה-importer מופיעים במדריך ה-companion crates. דרכים אחרות להכניס מסמכים מופיעות בcookbook.
שאלות ששואלים לפני שעוברים
צריך מפתח API של LLM?
לא. לכידה, חיפוש והעברות עובדים בלי מפתח ובלי LLM. הוספת ספק מדליקה איחוד מבוסס LLM, bootstrap, lint עשיר יותר, auto-improve ו-reranking אופציונלי. גם התחברות דרך מנוי, כמו Codex או GitHub Copilot, עובדת כספק.
יש גרסה מתארחת?
לא. ai-memory הוא שרת יחיד שמריצים בעצמכם על מחשב נייד, על מכונת homelab או על מחשב ב-LAN. אין מסלול SaaS ואין קונסולת enterprise.
אפשר לייבא את הנתונים שלי מ-Mem0, מ-Zep או מ-cognee?
לא ישירות. ה-importer הנלווה קורא ויקי markdown של oh-my-claudecode ופורמט JSON גנרי של שיחות. מתאמים למוצרים ספציפיים נמצאים מחוץ ל-repository. עבור בסיס קוד קיים, ai-memory bootstrap זורע את הוויקי מהיסטוריית ה-git ומהתיעוד.
אפשר להריץ את ai-memory לצד כלי הזיכרון הנוכחי שלי?
כן. הוא מותקן כרשומת שרת MCP משלו ועם hooks של מחזור החיים משלו, ולא נוגע בקונפיגורציה של כלים אחרים. אפשר להשוות את שניהם על אותו פרויקט לפני שמסירים אחד מהם.
איך ציון האחזור שלו בהשוואה לאחרים?
ב-LongMemEval-S הוא מקבל 0.815 ב-hit@5 עם ה-embeddings המקומיים של ברירת המחדל, ו-0.666 עם טקסט מלא בלבד. המספר הזה מודד אחזור ולא אומר דבר על דיוק התשובות. מערכות שעושות rerank מקבלות ציון גבוה יותר: agentmemory מדווח על 0.952 ו-mcp-memory-service מדווח על 0.860 ברמת סשן.
הוא מסנכרן זיכרון בין מחשבים?
הוא משתמש בשרת אחד שכל המחשבים שלכם מגיעים אליו דרך הרשת. אין רפליקציה אוטומטית בין שרתים.
נסו אותו לצד הכלי שכבר יש לכם.
הוא מותקן לצד הסביבה הנוכחית שלכם, בלי חשבון ובלי מפתח API.