
Soluções
Migrando de outra ferramenta de memória
Toda ferramenta de memória é construída em torno de uma aposta. Esta página diz para que serve cada uma, o que muda se você migrar e onde o ai-memory é a escolha mais fraca.
Cada ferramenta otimiza uma coisa
O ai-memory otimiza uma wiki de páginas markdown versionada em git, com um índice de busca derivado, e por padrão faz zero chamadas a LLM. As outras fizeram apostas diferentes, para públicos diferentes.
Extratores de fatos
Mem0 e LangMem pedem a um LLM para extrair fatos atômicos de cada turno, para personalizar um app para os usuários finais dele.
Grafos temporais
Zep, Graphiti e cognee modelam o conhecimento como um grafo ao longo do tempo. Atendem consultas de grafo e rodam em cima de um banco de grafos.
Sistemas operacionais de memória
Letta e MemGPT deixam o agente editar a própria memória em camadas. Servem para quem adota o runtime de agentes deles.
APIs hospedadas
Supermemory e as nuvens gerenciadas guardam sua memória atrás de uma conta, em troca de conectores e zero operação.
O que nenhuma outra ferramenta tem por completo
O projeto auditou os concorrentes contra o próprio código. A maioria tem um ou dois destes seis itens, e nenhum tem os seis.
Zero chamadas a LLM por padrão
Captura, busca e handoffs funcionam sem chave de API.
Os arquivos são a fonte da verdade
Uma pasta de markdown versionada em git. O banco de dados é um índice que dá para reconstruir.
Um binário autocontido
Roda sem banco de grafos, sem runtime Python e sem processo sidecar.
Todos os agentes, automaticamente
Hooks de ciclo de vida para mais de 20 agentes de código.
Handoffs tipados, assumidos uma vez só
Um protocolo: cada handoff tem tipo e dono, e só uma sessão consegue assumi-lo.
Times sem plano pago
Contas, atribuição e log de auditoria já vêm inclusos.
O que você precisa rodar
O jeito mais rápido de comparar ferramentas de memória é contar quantos serviços cada uma precisa antes de lembrar de qualquer coisa.
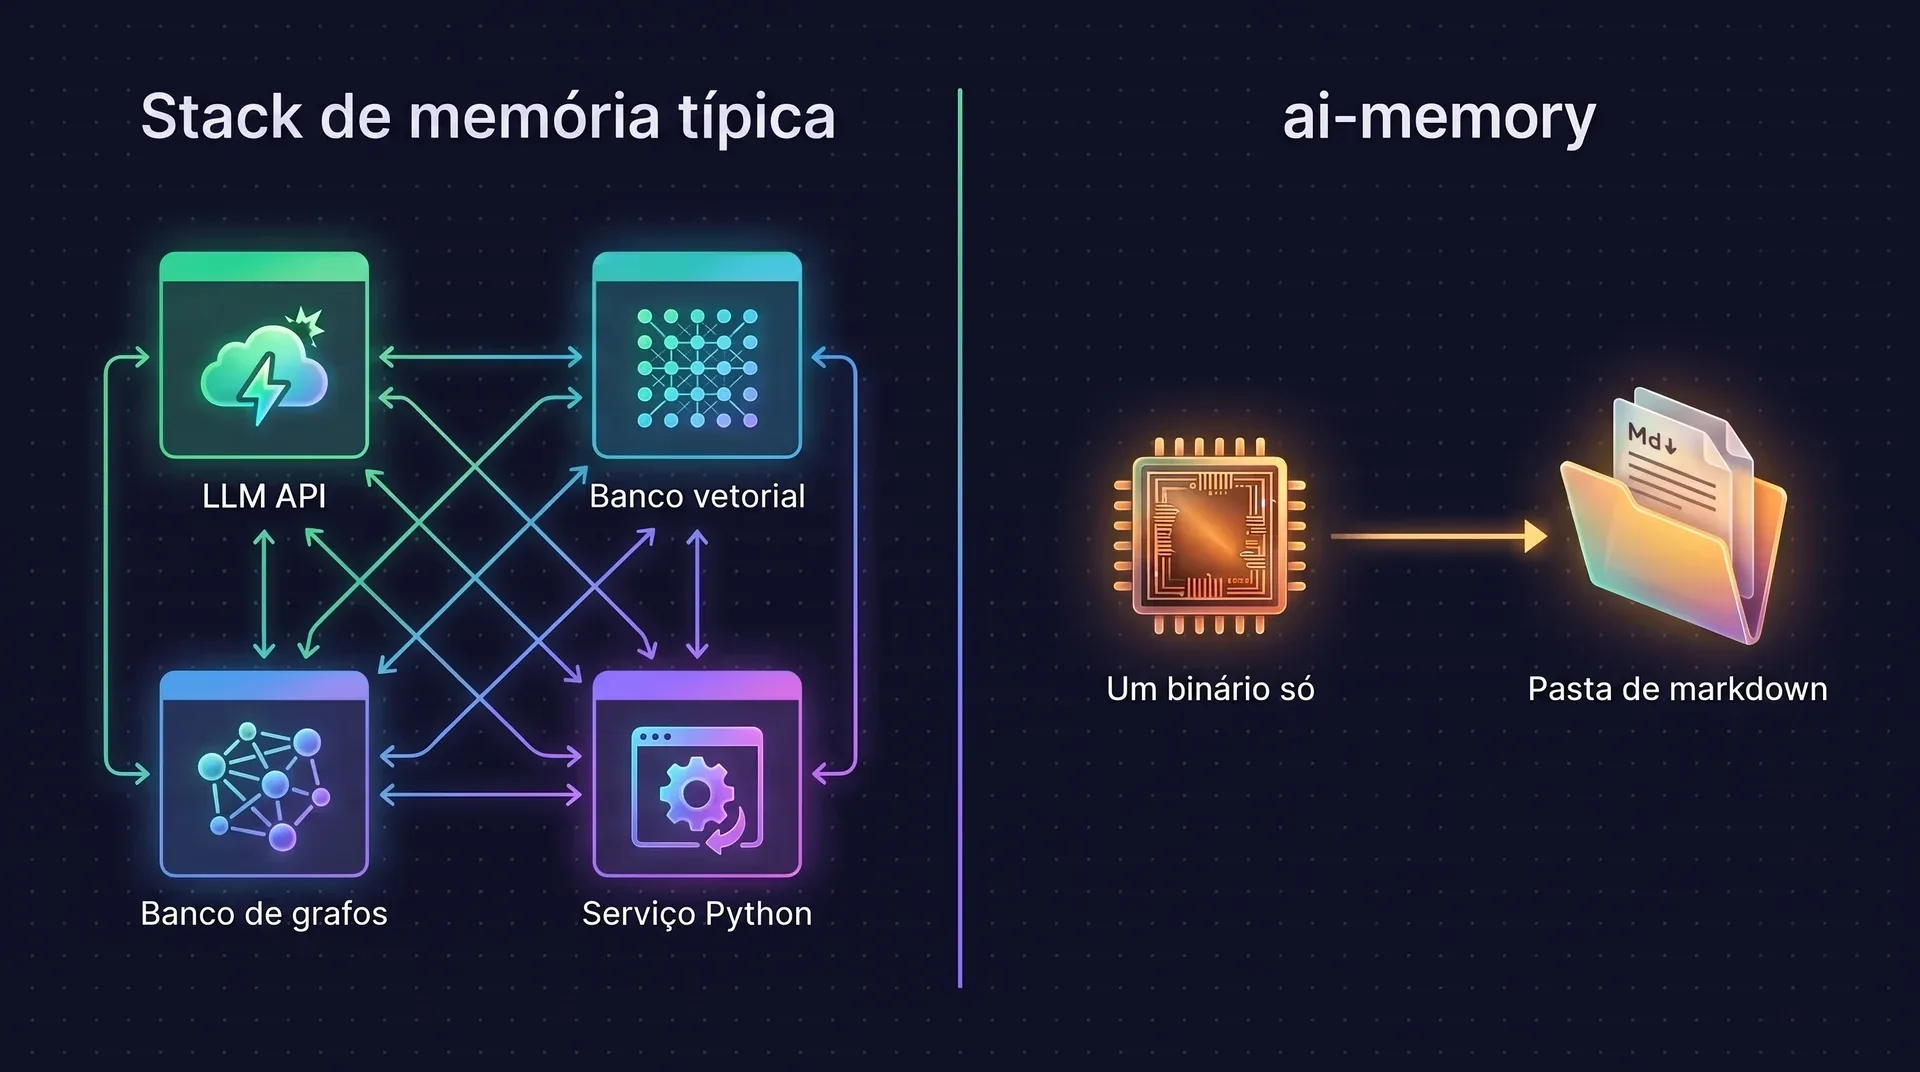
| Ferramenta | Um LLM | Um serviço vetorial ou de embeddings | Um banco de grafos | Outro runtime ou banco de dados | Uma conta em nuvem | O que ela exige |
|---|---|---|---|---|---|---|
| ai-memory | Opcional | Não precisa | Não precisa | Não precisa | Não precisa | Um binário só e uma pasta de markdown |
| Memória nativa do Claude Code | Não precisa | Não precisa | Não precisa | Não precisa | Não precisa | Claude Code · Uma máquina só |
| Mem0 e LangMem | Precisa | Precisa | Não precisa | Não precisa | Não precisa | Um LLM a cada turno · Um banco vetorial |
| Zep e Graphiti | Precisa | Não precisa | Precisa | Não precisa | Não precisa | Neo4j, FalkorDB ou Neptune · Um LLM |
| cognee | Precisa | Precisa | Precisa | Precisa | Não precisa | Três bancos em sincronia · Uma chamada de LLM por chunk · Python |
| OpenViking e Hindsight | Precisa | Precisa | Não precisa | Precisa | Não precisa | Um LLM ou VLM · Embeddings · Postgres ou um serviço hospedado |
| basic-memory | Não precisa | Não precisa | Não precisa | Não precisa | Não precisa | Você, escrevendo notas na mão |
| mcp-memory-service | Não precisa | Não precisa | Não precisa | Não precisa | Não precisa | Basicamente Claude Code |
| agentmemory | Não precisa | Não precisa | Não precisa | Precisa | Não precisa | Um sidecar em Node · Mais de 50 ferramentas MCP |
| Letta e MemGPT | Não precisa | Não precisa | Não precisa | Precisa | Não precisa | Adotar o runtime de agentes deles |
| Supermemory | Não precisa | Não precisa | Não precisa | Não precisa | Precisa | Uma conta na nuvem · Gasto com API |
| Honcho | Precisa | Não precisa | Não precisa | Precisa | Não precisa | Um LLM · Postgres, Redis e um worker |
- Precisa
- Opcional
- O ai-memory não precisa
- Não precisa
Três linhas não têm marcação. A memória do Claude Code é nativa, e basic-memory e mcp-memory-service também são leves de rodar. As diferenças entre eles estão na próxima seção.
Ferramenta por ferramenta
Abra a que você usa. Cada bloco diz o que continua igual, o que você ganha e onde aquela ferramenta vence.
Memória nativa do Claude CodeUm MEMORY.md por laptop
O que continua igual
A conveniência de “lembrar do meu projeto”, em markdown.
O que você ganha
- A mesma memória no Codex, Cursor, Gemini CLI e mais 20
- Sincronizada entre as suas máquinas
- Compartilhada com o seu time
- Busca de verdade, e captura do que as ferramentas realmente fizeram
Onde ela vence
Zero configuração. Já vem ligada e não tem servidor para rodar. Para um desenvolvedor em uma máquina que só usa Claude Code, pode ser tudo de que você precisa.
Veredito Migre quando entrar um segundo agente, uma segunda máquina ou uma segunda pessoa.
Mem0 e LangMemExtratores de fatos
O que continua igual
Captura automática, sem o ritual de “lembre disso”.
O que você ganha
- Páginas legíveis que você abre e edita, no lugar de linhas de fatos opacas
- Busca que funde full-text, entidades, links e vetores
- Nenhum gasto com API para capturar ou buscar
Onde ela vence
Um ecossistema grande de SDKs e uma nuvem gerenciada feita para personalizar apps para usuários finais.
Veredito Outro público. O Mem0 lembra dos usuários do seu app. O ai-memory lembra do seu repositório.
Zep e GraphitiGrafo de conhecimento temporal
O que continua igual
Fatos são substituídos, nunca apagados. Dá para perguntar o que era verdade em um ponto no tempo.
O que você ganha
- Consultas point-in-time e links tipados em um binário só com SQLite
- Nenhum banco de grafos para manter
- Nativo para agentes de código, com hooks para mais de 20 deles
Onde ela vence
Modelagem bitemporal de verdade, consultas de grafo em Cypher e tipos de entidade customizados. O ai-memory registra só o tempo de ingestão, por decisão de projeto.
Veredito Migre se você roda self-hosted para programar. Fique se precisa de consultas de grafo enterprise.
cogneePipeline de grafo, vetores e relacional
O que continua igual
Proveniência, ranking ponderado por feedback e um plugin para Claude Code.
O que você ganha
- Um lugar só para fazer backup: uma pasta de markdown
- Nenhuma conta de LLM na ingestão
- Um binário único que roda numa máquina de homelab
Onde ela vence
Amplitude: mais de 14 modos de busca, grounding em ontologias e ingestão de PDFs, CSVs e páginas web.
Veredito Migre se você quer memória para sessões de código. Fique se você ingere documentos.
OpenViking e HindsightMemória em documentos vivos, LLM obrigatório
O que continua igual
Memória compilada em páginas vivas por um loop de consolidação em background. O ai-memory tem uma passada de sonho opt-in e uma pontuação de confiança por página.
O que você ganha
- Captura, busca e handoffs com zero chamadas a LLM
- Arquivos que são seus, licença MIT, sem o peso de AGPL ou SaaS
- Compartilhamento com o time por projeto, no lugar de isolamento rígido por bank
Onde ela vence
Acurácia reportada mais alta com um LLM no loop: o Hindsight reporta 91,4% no LongMemEval, o OpenViking reporta grande economia de tokens. Os dois números são dos próprios fornecedores. No Hindsight, a força da crença mexe no ranking por padrão. No ai-memory, fica desligada até uma avaliação dar respaldo.
Veredito Migre para uso self-hosted, offline ou em time. Fique se você precisa da acurácia deles e aceita a exigência de LLM.
basic-memoryBase de conhecimento em markdown via MCP
O que continua igual
Markdown em disco é a fonte da verdade, com um índice derivado.
O que você ganha
- Captura automática pelos hooks de ciclo de vida
- Versões antigas saem da busca, e páginas de sessão frias são descartadas ou compactadas
- Handoffs entre agentes e compartilhamento multiusuário
Onde ela vence
Um reranker cross-encoder local, edição colaborativa em tempo real e um app mobile hospedado.
Veredito Migre pela continuidade de código entre vários agentes. Fique por uma base de conhecimento pessoal no estilo Obsidian.
mcp-memory-serviceO parente mais próximo
O que continua igual
SQLite, embeddings locais, captura por hooks, links tipados e números honestos. O envelhecimento da memória também bate: decaimento por camada, compactação, dedup por cluster e avisos de contradição.
O que você ganha
- Páginas que você consegue ler, no lugar de linhas de fatos
- Envelhecimento desligado por padrão, e toda reescrita pode ser restaurada
- Handoffs entre agentes que só uma sessão assume, e mensagens entre projetos
Onde ela vence
O envelhecimento dele roda sozinho, sem configurar nada. Ele também tem replicação multi-backend e um visualizador de grafo, e a nota dele por sessão, 0,860, fica acima da do ai-memory, que é cerca de 0,82.
Veredito Migre se você gostou da captura por hooks e quer isso em todos os agentes.
agentmemoryO ancestral deste projeto
O que continua igual
Quase todos os conceitos: camadas, substituição, decaimento, ranking fundido, hooks e compressão que não precisa de LLM.
O que você ganha
- Um binário autocontido, sem sidecar
- Índices SQL de verdade, gravados em uma transação só
- Arquivos como fonte da verdade, paridade no Windows, autenticação mais completa
Onde ela vence
Cerca de 13 pontos de recuperação bruta: ele reporta 0,952 no LongMemEval-S contra cerca de 0,82, porque faz rerank. Também tem sync peer-to-peer.
Veredito Migre pela operação mais simples e para ser dono dos seus dados.
Letta e MemGPTSistema operacional de memória
O que continua igual
Camadas de memória e consolidação fora do hot path.
O que você ganha
- Memória que fica embaixo do agente que você já usa
- Nenhum runtime para adotar, nenhum token gasto com autoedição
Onde ela vence
Um framework de agentes completo com ambiente de desenvolvimento, e boa coerência em horizontes longos.
Veredito Fique se você constrói em cima do Letta. Migre se só quer que seu agente de código lembre das coisas.
SupermemoryAPI de memória hospedada
O que continua igual
Um segundo cérebro com ingestão automática e substituição. A passada de “dreaming” dele é uma das fontes da passada de sonho do ai-memory.
O que você ganha
- Markdown versionado em git que é seu
- Funciona offline
- Focado no seu repositório, enquanto o Supermemory é um cofre genérico
Onde ela vence
Conectores gerenciados para Drive, Gmail, Notion e S3, ingestão multimodal e perfis de usuário.
Veredito Outro público.
HonchoModelagem de usuário para agentes
O que continua igual
Respostas com citações no memory_query, níveis de raciocínio e uma passada de sonho que roda quando você está ocioso e trata primeiro o material mais inédito.
O que você ganha
- As mesmas conveniências, sem exigir LLM para captura ou busca
- Um binário e uma pasta no lugar de três serviços
- Memória no escopo de um repositório, compartilhada com o time
Onde ela vence
Um motor de raciocínio que modela o que cada pessoa sabe e acredita. Reporta 90,4% no LongMemEval-S ao lembrar fatos sobre um usuário, um número do próprio fornecedor em outra tarefa.
Veredito Outro problema: o Honcho lembra do usuário, e o ai-memory lembra do projeto.
As linhas de “onde ela vence” vêm da auditoria do próprio projeto. Leia a comparação completa e a auditoria autocrítica de paridade no GitHub.
O benchmark, com as ressalvas
O ai-memory publica um número, medido no LongMemEval-S com um harness que vem no repositório. Sistemas que fazem reranking pontuam mais.
- ai-memory antes da 2.0Só full-text0,617
- ai-memory, só full-textFiltro de stopwords adicionado0,666
- ai-memory padrãoEmbeddings locais, sem chave de API0,815
- mcp-memory-serviceReportado pelo fornecedor, por sessão0,860
- agentmemoryReportado pelo fornecedor, com reranking0,952
- O hit@5 pergunta se uma sessão que contém a evidência está entre os cinco primeiros resultados. Ele mede recuperação. Não diz nada sobre a acurácia das respostas.
- 470 das 500 perguntas são pontuadas. As 30 perguntas de abstenção ficam de fora. A execução é de 21 de setembro de 2026. Uma segunda execução no mesmo commit marcou 0,821, então leia a nota padrão como cerca de 0,82.
- 0,815 usa o modelo de embeddings in-process padrão, sem chave de API e sem LLM. 0,666 é só full-text, entidades e links.
- Não existe nenhuma execução lado a lado contra qualquer concorrente. Números de acurácia, como os 91,4% do Hindsight, são outra métrica e não se comparam com hit@5.
- Os trechos armazenados são limitados a 2 KB por privacidade, então uma evidência no fundo de um turno longo não é encontrada. O benchmark mede o sistema como ele é distribuído.
- O LongMemEval é histórico de assistente de chat. Um benchmark de sessões de código está planejado e ainda não existe.
Reproduza a partir de um checkout. As notas do benchmark têm o hash do dataset e os resultados por fatia.
# o servidor em teste
cargo build --release -p ai-memory-cli
# a execução completa; --fetch baixa o dataset e confere o hash
cargo run --release -p ai-memory-eval -- retrieval --fetch
# um smoke test de dez perguntas
cargo run -p ai-memory-eval -- retrieval --sample 10
Onde o ai-memory está atrás
Esta lista vem da auditoria do próprio repositório. Se um destes itens é o que você precisa, fique onde está.
Sem reranker local
As pontuações de recuperação ficam abaixo das dos sistemas que fazem reranking. O único reranker é um LLM, e ele vem desligado por padrão. As respostas com citações também precisam de um LLM, e a acurácia delas não foi avaliada.
Tipos de link não mexem no ranking
Dá para ir de uma página às páginas relacionadas a ela. Na busca, o tipo do link continua só explicando um resultado e não tem peso nenhum.
O envelhecimento não tem comprovação
A pontuação de confiança, a compactação, o dedup e a passada de sonho vêm desligados por padrão. Nenhuma avaliação de recuperação foi rodada sobre eles, então o projeto afirma o mecanismo e nenhum ganho medido.
Uma linha do tempo só
A busca point-in-time usa o momento em que o fato foi registrado. O Zep modela tanto quando algo aconteceu quanto quando foi aprendido.
Só texto de sessões de código
Não ingere PDFs, CSVs nem imagens, não tem modelo de visão e não é um banco de grafos que você consulta com Cypher.
Um servidor, sem versão hospedada
Várias máquinas acessam um servidor que você mesmo roda. Não há replicação automática, nem SaaS, nem console enterprise.
Mais setup do que a memória nativa
A memória do próprio Claude Code já vem ligada. O ai-memory pede que um desenvolvedor solo suba um servidor primeiro.
Como migrar
Você não precisa trocar tudo de uma vez. As duas ferramentas podem rodar no mesmo projeto enquanto você compara.
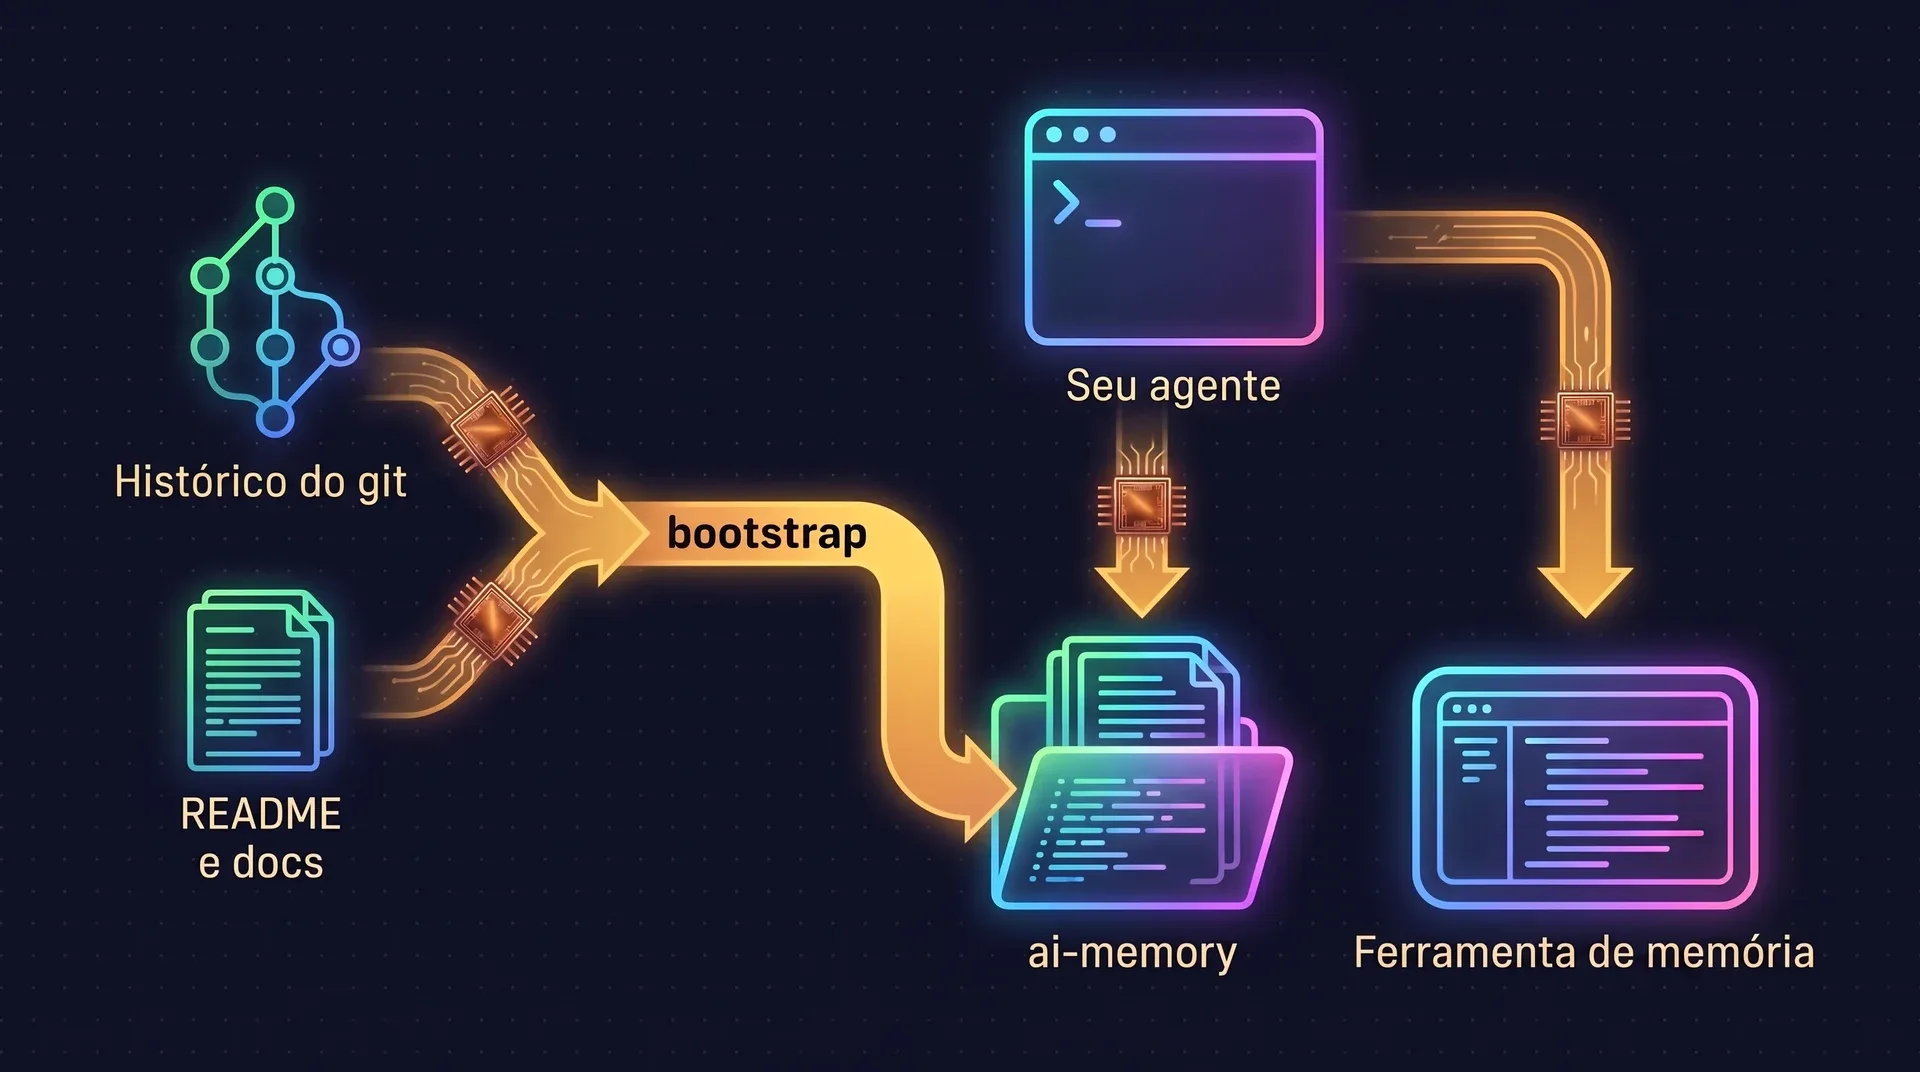
Instale ao lado do que você já tem
O ai-memory adiciona sua própria entrada MCP e seus próprios hooks, e deixa as entradas das outras ferramentas no lugar. A instalação rápida traz os comandos.
Popule a wiki a partir do próprio projeto
ai-memory bootstraplê seu histórico do git, o README,docs/e os arquivos de regras dos agentes, e então escreve as páginas iniciais. Precisa de um provedor de LLM. Rode o dry run antes para ver o que seria enviado. Revise o que chegar: um LLM pode escrever detalhes plausíveis que estão errados, e a wiki está em git, então dá para reverter.projeto existente cd /path/to/project ai-memory bootstrap --dry-run ai-memory bootstrapTraga anotações e conversas antigas, se o importador souber ler
O importador standalone em
companions/ai-memory-importerlê duas coisas hoje: pastas de wiki markdown do oh-my-claudecode (OMC) e conversas em um envelope JSON genérico e pequeno. Ele não tem adaptador para Mem0, Zep nem cognee, então os exports dessas ferramentas precisam ser convertidos para o envelope antes. Por padrão ele roda em dry run e nunca apaga nada.dry run, a partir de um checkout do repositório cargo run --manifest-path companions/ai-memory-importer/Cargo.toml -- \ omc-wiki --dir /path/to/omc/wiki --workspace default --project my-projectRode as duas por um tempo e depois decida
Mantenha a ferramenta antiga conectada enquanto compara. Faça às duas as mesmas perguntas sobre o seu projeto. Remova a que você parou de usar.
Os formatos e as regras de segurança do importador estão no guia dos crates companion. Outras formas de trazer documentos estão no cookbook.
Perguntas que aparecem antes de migrar
Preciso de uma chave de API de LLM?
Não. Captura, busca e handoffs funcionam sem chave e sem LLM. Adicionar um provedor liga a consolidação com LLM, o bootstrap, um linting mais rico, o auto-improve e o reranking opcional. Logins de assinatura, como Codex ou GitHub Copilot, também funcionam como provedores.
Existe uma versão hospedada?
Não. O ai-memory é um único servidor que você roda em um laptop, em uma máquina do homelab ou em um host da LAN. Não há plano SaaS nem console enterprise.
Consigo importar meus dados do Mem0, Zep ou cognee?
Direto, não. O importador companion lê wikis markdown do oh-my-claudecode e um formato JSON genérico de conversas. Adaptadores para produtos específicos ficam fora do repositório. Para uma base de código existente, o ai-memory bootstrap popula a wiki a partir do histórico do git e da documentação.
Posso rodar o ai-memory ao lado da minha ferramenta de memória atual?
Sim. Ele se instala como sua própria entrada de servidor MCP e seus próprios hooks de ciclo de vida, e não mexe na configuração das outras ferramentas. Dá para comparar as duas no mesmo projeto antes de remover qualquer uma.
Como fica a pontuação de recuperação dele na comparação?
No LongMemEval-S ele marca 0,815 de hit@5 com os embeddings locais padrão e 0,666 só com full-text. Esse número mede recuperação e não diz nada sobre a acurácia das respostas. Sistemas que fazem reranking pontuam mais: o agentmemory reporta 0,952 e o mcp-memory-service reporta 0,860 por sessão.
Ele sincroniza a memória entre máquinas?
Ele usa um servidor que todas as suas máquinas acessam pela rede. Não há replicação automática entre servidores.
Experimente ao lado da ferramenta que você já usa.
Ele se instala ao lado do seu setup atual e não precisa de conta nem de chave de API.