
Soluciones
Migrar desde otra herramienta de memoria
Cada herramienta de memoria se construye sobre una apuesta. Esta página dice para qué sirve cada una, qué cambia si te mudas y dónde ai-memory es la opción más floja.
Cada herramienta optimiza una cosa
ai-memory optimiza una wiki de páginas markdown respaldada por git, con un índice de búsqueda derivado, y por defecto no hace ninguna llamada a un LLM. Las demás hicieron otras apuestas, para otro tipo de cliente.
Extractores de hechos
Mem0 y LangMem le piden a un LLM que saque hechos atómicos de cada turno, para personalizar una app para sus usuarios finales.
Grafos temporales
Zep, Graphiti y cognee modelan el conocimiento como un grafo a lo largo del tiempo. Sirven consultas de grafos y corren sobre una base de datos de grafos.
Sistemas operativos de memoria
Letta y MemGPT dejan que el agente edite su propia memoria por niveles. Encajan con quien adopta su runtime de agentes.
APIs alojadas
Supermemory y las nubes gestionadas guardan tu memoria detrás de una cuenta, a cambio de conectores y cero operaciones.
Lo que ninguna otra herramienta reúne
El proyecto auditó a sus competidores contra su propio código. La mayoría tiene una o dos de estas seis, y ninguna tiene las seis.
Cero llamadas a un LLM por defecto
La captura, la búsqueda y los traspasos funcionan sin clave de API.
Los archivos son la fuente de verdad
Una carpeta de markdown respaldada por git. La base de datos es un índice que se puede reconstruir.
Un solo binario autocontenido
Corre sin base de datos de grafos, sin runtime de Python y sin proceso sidecar.
Todos los agentes, automáticamente
Hooks de ciclo de vida para más de 20 agentes de programación.
Traspasos tipados que se reclaman una vez
Un protocolo: cada traspaso tiene un tipo y un dueño, y solo una sesión puede reclamarlo.
Equipos sin plan de pago
Las cuentas, la atribución y un registro de auditoría vienen incluidos.
Lo que tienes que ejecutar
La forma más rápida de comparar herramientas de memoria es contar los servicios que necesita cada una antes de recordar nada.
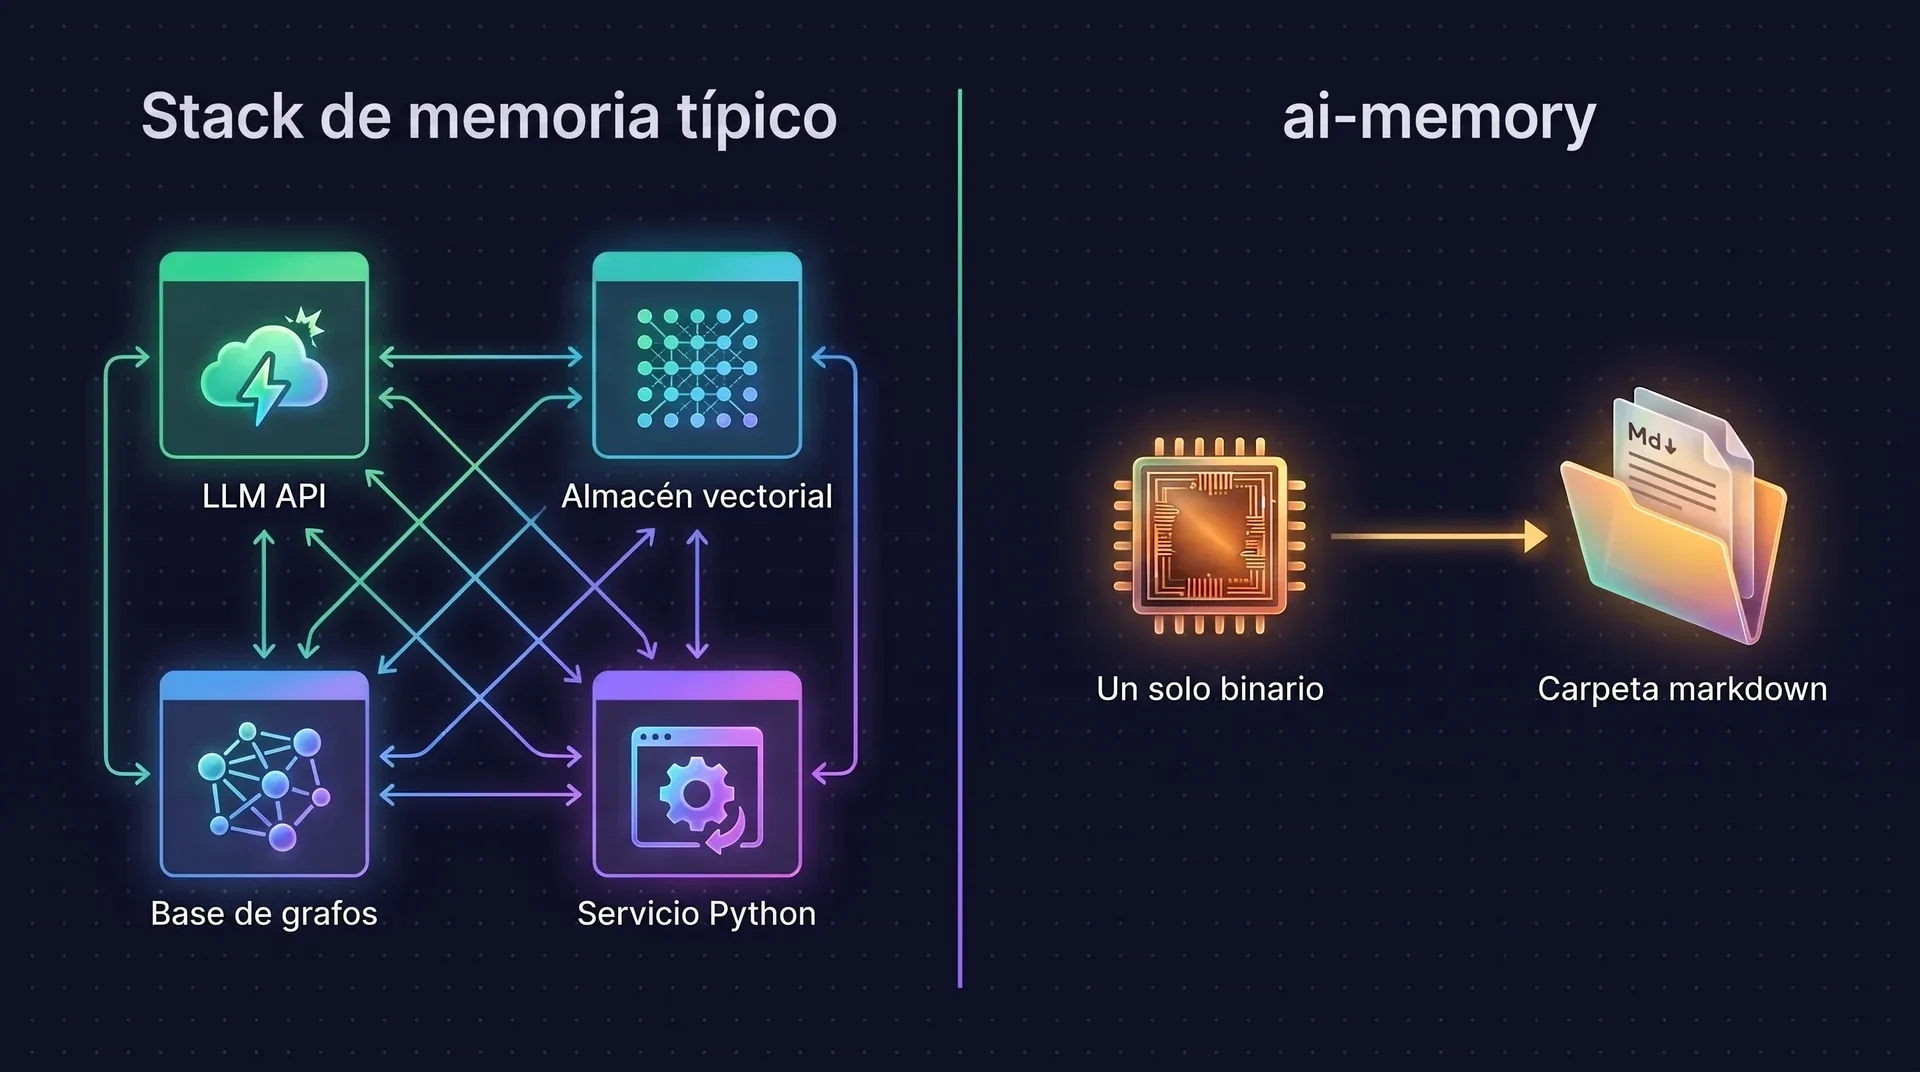
| Herramienta | Un LLM | Un servicio vectorial o de embeddings | Una base de datos de grafos | Otro runtime u otra base de datos | Una cuenta en la nube | Qué necesita |
|---|---|---|---|---|---|---|
| ai-memory | Opcional | No hace falta | No hace falta | No hace falta | No hace falta | Un solo binario y una carpeta de markdown |
| Memoria integrada de Claude Code | No hace falta | No hace falta | No hace falta | No hace falta | No hace falta | Claude Code · Una sola máquina |
| Mem0 y LangMem | Lo necesita | Lo necesita | No hace falta | No hace falta | No hace falta | Un LLM en cada turno · Un almacén vectorial |
| Zep y Graphiti | Lo necesita | No hace falta | Lo necesita | No hace falta | No hace falta | Neo4j, FalkorDB o Neptune · Un LLM |
| cognee | Lo necesita | Lo necesita | Lo necesita | Lo necesita | No hace falta | Tres almacenes sincronizados · Una llamada a un LLM por fragmento · Python |
| OpenViking y Hindsight | Lo necesita | Lo necesita | No hace falta | Lo necesita | No hace falta | Un LLM o VLM · Embeddings · Postgres o un servicio alojado |
| basic-memory | No hace falta | No hace falta | No hace falta | No hace falta | No hace falta | Tú, escribiendo notas a mano |
| mcp-memory-service | No hace falta | No hace falta | No hace falta | No hace falta | No hace falta | Sobre todo Claude Code |
| agentmemory | No hace falta | No hace falta | No hace falta | Lo necesita | No hace falta | Un sidecar en Node · Más de 50 herramientas MCP |
| Letta y MemGPT | No hace falta | No hace falta | No hace falta | Lo necesita | No hace falta | Adoptar su runtime de agentes |
| Supermemory | No hace falta | No hace falta | No hace falta | No hace falta | Lo necesita | Una cuenta en la nube · Gasto de API |
| Honcho | Lo necesita | No hace falta | No hace falta | Lo necesita | No hace falta | Un LLM · Postgres, Redis y un worker |
- Lo necesita
- Opcional
- ai-memory no lo necesita
- No hace falta
Tres filas no tienen marcas. La memoria de Claude Code viene integrada, y basic-memory y mcp-memory-service también son ligeras de ejecutar. Sus diferencias están en la sección siguiente.
Herramienta por herramienta
Abre la que usas. Cada bloque dice qué se mantiene, qué ganas y dónde gana esa herramienta.
Memoria integrada de Claude CodeUn MEMORY.md por portátil
Qué se mantiene
La comodidad de "recuerda mi proyecto", en markdown.
Qué ganas
- La misma memoria en Codex, Cursor, Gemini CLI y 20 más
- Sincronizada entre tus máquinas
- Compartida con tu equipo
- Búsqueda de verdad, y captura de lo que las herramientas hicieron realmente
Dónde gana
Cero instalación. Ya viene activada y no hay servidor que mantener. Para un desarrollador en una sola máquina que solo usa Claude Code, puede ser todo lo que necesitas.
Veredicto Cámbiate cuando sumes un segundo agente, una segunda máquina o una segunda persona.
Mem0 y LangMemExtractores de hechos
Qué se mantiene
Captura automática, sin la ceremonia de “recuerda esto”.
Qué ganas
- Páginas legibles que puedes abrir y editar, en lugar de filas de hechos opacas
- Búsqueda que fusiona texto completo, entidades, enlaces y vectores
- Ningún gasto de API para capturar o buscar
Dónde gana
Un gran ecosistema de SDK y una nube gestionada, pensada para personalizar apps para usuarios finales.
Veredicto Otro tipo de cliente. Mem0 recuerda a los usuarios de tu app. ai-memory recuerda tu repositorio.
Zep y GraphitiGrafo de conocimiento temporal
Qué se mantiene
Los hechos se reemplazan, nunca se borran. Puedes preguntar qué era cierto en un momento dado.
Qué ganas
- Consultas a un punto en el tiempo y enlaces tipados en un solo binario con SQLite
- Ninguna base de datos de grafos que mantener
- Nativo para agentes de programación, con hooks para más de 20
Dónde gana
Modelado bitemporal real, consultas de grafos con Cypher y tipos de entidad personalizados. ai-memory solo registra el momento de ingesta, por diseño.
Veredicto Cámbiate si lo alojas tú mismo para programar. Quédate si necesitas consultas de grafos de nivel empresarial.
cogneePipeline de grafo, vectores y relacional
Qué se mantiene
Procedencia, ranking ponderado por feedback y un plugin para Claude Code.
Qué ganas
- Un solo almacén que respaldar: una carpeta de markdown
- Ninguna factura de LLM por la ingesta
- Un solo binario que corre en un equipo de homelab
Dónde gana
Amplitud: más de 14 modos de recuperación, anclaje en ontologías e ingesta de PDF, CSV y páginas web.
Veredicto Cámbiate si quieres memoria para sesiones de programación. Quédate si ingieres documentos.
OpenViking y HindsightMemoria de documentos vivos, LLM obligatorio
Qué se mantiene
Memoria compilada en páginas vivas por un bucle de consolidación en segundo plano. ai-memory tiene una pasada de sueño opt-in y una puntuación de confianza por página.
Qué ganas
- Captura, búsqueda y traspasos sin ninguna llamada a un LLM
- Archivos que son tuyos, con licencia MIT, sin el peso de la AGPL ni de un SaaS
- Compartir por proyecto en equipo, en lugar de un aislamiento estricto por banco
Dónde gana
Mayor precisión reportada con un LLM en el circuito: Hindsight reporta 91,4% en LongMemEval y OpenViking reporta grandes ahorros de tokens. Ambas son cifras del proveedor. En Hindsight, la fuerza de las creencias mueve el ranking por defecto. En ai-memory viene desactivada hasta que una evaluación la respalde.
Veredicto Cámbiate para uso autoalojado (self-hosted), sin conexión o en equipo. Quédate si necesitas su precisión y aceptas que el LLM sea obligatorio.
basic-memoryBase de conocimiento en markdown sobre MCP
Qué se mantiene
El markdown en disco es la fuente de verdad, con un índice derivado.
Qué ganas
- Captura automática desde los hooks de ciclo de vida
- Las versiones viejas salen de la búsqueda, y las páginas de sesión frías caducan o se compactan
- Traspasos entre agentes y uso compartido entre varios usuarios
Dónde gana
Un reranker cross-encoder local, edición colaborativa en tiempo real y una app móvil alojada.
Veredicto Cámbiate si buscas continuidad al programar con varios agentes. Quédate si quieres una base de conocimiento personal al estilo de Obsidian.
mcp-memory-serviceEl pariente más cercano
Qué se mantiene
SQLite, embeddings locales, captura por hooks, enlaces tipados y cifras honestas. El envejecimiento de la memoria también coincide: decaimiento por nivel, compactación, dedup por clusters y avisos de contradicción.
Qué ganas
- Páginas que puedes leer, en lugar de filas de hechos
- Un envejecimiento desactivado por defecto, y toda reescritura se puede restaurar
- Traspasos entre agentes que se reclaman una sola vez, y mensajería entre proyectos
Dónde gana
Su envejecimiento funciona solo, sin configurar nada. También tiene replicación multibackend y un visualizador de grafos, y su puntuación de 0,860 a nivel de sesión supera la de ai-memory, que es de aproximadamente 0,82.
Veredicto Cámbiate si te gustó la captura por hooks y la quieres en todos los agentes.
agentmemoryEl antecesor de este proyecto
Qué se mantiene
Casi todos los conceptos: niveles, reemplazo, decaimiento, ranking fusionado, hooks y una compresión que no necesita LLM.
Qué ganas
- Un binario autocontenido, sin sidecar
- Índices SQL reales, confirmados en una sola transacción
- Archivos como fuente de verdad, paridad en Windows y autenticación más completa
Dónde gana
Unos 13 puntos de recuperación bruta: reporta 0,952 en LongMemEval-S frente a aproximadamente 0,82, porque hace rerank. También tiene sincronización peer-to-peer.
Veredicto Cámbiate por la operabilidad y por ser dueño de tus datos.
Letta y MemGPTSistema operativo de memoria
Qué se mantiene
Niveles de memoria y consolidación fuera de la ruta crítica.
Qué ganas
- Memoria que va debajo del agente que ya usas
- Ningún runtime que adoptar, ningún token gastado en autoedición
Dónde gana
Un framework de agentes completo con su entorno de desarrollo, y buena coherencia en tareas de largo horizonte.
Veredicto Quédate si construyes sobre Letta. Cámbiate si solo quieres que tu agente de programación recuerde.
SupermemoryAPI de memoria alojada
Qué se mantiene
Un segundo cerebro con ingesta automática y reemplazo. Su pasada de “dreaming” es una de las fuentes de la de ai-memory.
Qué ganas
- Markdown versionado en git que es tuyo
- Funciona sin conexión
- Acotado a tu repositorio, mientras que Supermemory es un almacén de uso general
Dónde gana
Conectores gestionados para Drive, Gmail, Notion y S3, ingesta multimodal y perfiles de usuario.
Veredicto Otro tipo de cliente.
HonchoModelado de usuarios para agentes
Qué se mantiene
Respuestas con citas desde memory_query, niveles de razonamiento y una pasada de sueño que se ejecuta cuando estás inactivo y procesa primero el material más novedoso.
Qué ganas
- Esas comodidades sin exigir un LLM para capturar ni para buscar
- Un solo binario y una carpeta en lugar de tres servicios
- Memoria acotada a un repositorio y compartida con un equipo
Dónde gana
Un motor de razonamiento que modela lo que cada persona sabe y cree. Reporta 90,4% en LongMemEval-S recordando hechos sobre un usuario, una cifra del proveedor en una tarea distinta.
Veredicto Un problema distinto: Honcho recuerda al usuario, y ai-memory recuerda el proyecto.
Las líneas de “dónde gana” salen de la auditoría del propio proyecto. Lee la comparación completa y la auditoría de paridad autocrítica en GitHub.
El benchmark, con sus salvedades
ai-memory publica una sola cifra, medida en LongMemEval-S con un harness que viene en el repositorio. Los sistemas que hacen rerank puntúan más alto.
- ai-memory antes de 2.0Solo texto completo0,617
- ai-memory, solo texto completoCon filtrado de stopwords0,666
- ai-memory por defectoEmbeddings locales, sin clave de API0,815
- mcp-memory-serviceCifra del proveedor, a nivel de sesión0,860
- agentmemoryCifra del proveedor, con rerank0,952
- hit@5 pregunta si una sesión que contiene la evidencia está entre los cinco primeros resultados. Mide la recuperación. No dice nada sobre la precisión de las respuestas.
- Se puntúan 470 de las 500 preguntas. Las 30 preguntas de abstención quedan excluidas. La ejecución es del 21 de septiembre de 2026. Una segunda ejecución sobre el mismo commit obtuvo 0,821, así que conviene leer la puntuación por defecto como aproximadamente 0,82.
- 0,815 usa el modelo de embeddings por defecto, dentro del proceso, sin clave de API y sin LLM. 0,666 es solo texto completo, entidades y enlaces.
- No existe ninguna ejecución cara a cara contra ningún competidor. Las cifras de precisión, como el 91,4% de Hindsight, son otra métrica y no se comparan con hit@5.
- Los extractos guardados se limitan a 2 KB por privacidad, así que la evidencia que está muy adentro de un turno largo no se puede encontrar. El benchmark mide el sistema tal como se distribuye.
- LongMemEval es historial de asistentes de chat. Hay planeado un benchmark de sesiones de programación, y todavía no existe.
Reprodúcelo desde un checkout. Las notas del benchmark tienen el hash del dataset y los resultados por segmento.
# el servidor bajo prueba
cargo build --release -p ai-memory-cli
# la ejecución completa; --fetch descarga el dataset y verifica su hash
cargo run --release -p ai-memory-eval -- retrieval --fetch
# un smoke test de diez preguntas
cargo run -p ai-memory-eval -- retrieval --sample 10
Dónde ai-memory va por detrás
Esta lista sale de la auditoría del propio repositorio. Si lo que necesitas es alguna de estas cosas, quédate donde estás.
Sin reranker local
Las puntuaciones de recuperación quedan por debajo de los sistemas que hacen rerank. El único reranker es un LLM, y viene desactivado por defecto. Las respuestas con citas también necesitan un LLM, y su precisión no se ha evaluado.
Los tipos de enlace no mueven el ranking
Puedes ir de una página a sus páginas relacionadas. En la búsqueda, el tipo de enlace sigue sirviendo solo para explicar un resultado y no tiene ningún peso.
El envejecimiento está sin demostrar
La puntuación de confianza, la compactación, el dedup y la pasada de sueño vienen desactivados por defecto. No se ha hecho ninguna evaluación de recuperación sobre ellos, así que el proyecto afirma el mecanismo y ninguna mejora medida.
Una sola línea de tiempo
La búsqueda a un punto en el tiempo usa el momento en que se registró un hecho. Zep modela tanto cuándo pasó algo como cuándo se supo.
Solo texto de sesiones de programación
No ingiere PDF, CSV ni imágenes, no tiene modelo de visión y no es una base de datos de grafos que puedas consultar con Cypher.
Un servidor, sin plan alojado
Muchas máquinas llegan a un servidor que ejecutas tú. No hay replicación automática, ni SaaS, ni consola empresarial.
Más instalación que la memoria integrada
La memoria propia de Claude Code ya viene activada. ai-memory le pide a quien trabaja solo que primero arranque un servidor.
Cómo mudarte
No tienes que cambiar de golpe. Las dos herramientas pueden correr en el mismo proyecto mientras las comparas.
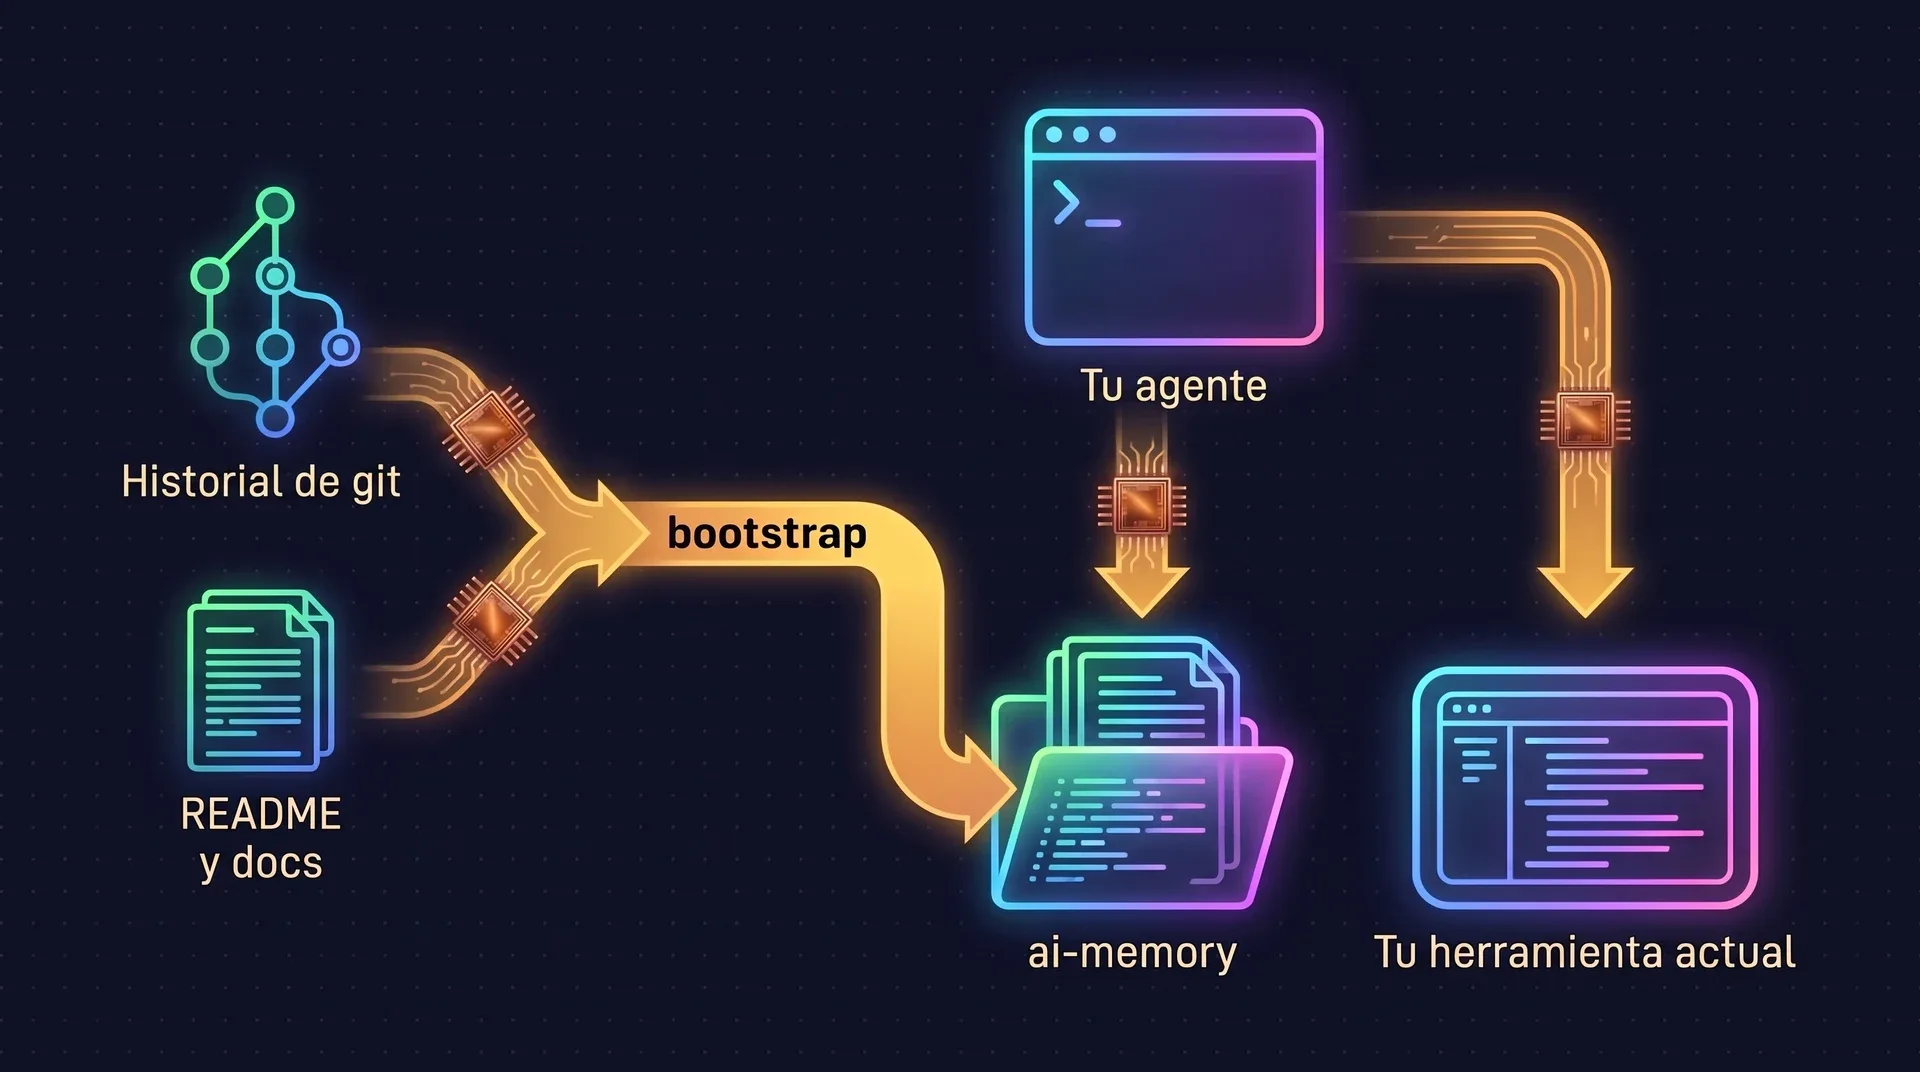
Instálalo junto a lo que ya tienes
ai-memory añade su propia entrada MCP y sus propios hooks, y deja en su sitio las entradas de otras herramientas. La instalación rápida tiene los comandos.
Siembra la wiki desde el propio proyecto
ai-memory bootstraplee tu historial de git, el README,docs/y los archivos de reglas de tus agentes, y luego escribe páginas semilla. Necesita un proveedor de LLM. Ejecuta antes la simulación (dry run) para ver qué se enviaría. Revisa lo que llega: un LLM puede escribir detalles verosímiles que están mal, y la wiki está en git, así que puedes revertir.proyecto existente cd /path/to/project ai-memory bootstrap --dry-run ai-memory bootstrapTrae notas y conversaciones viejas, si el importador las lee
El importador independiente que está en
companions/ai-memory-importerlee dos cosas hoy: carpetas de wiki markdown de oh-my-claudecode (OMC) y conversaciones en un envoltorio JSON genérico y pequeño. No tiene adaptador para Mem0, Zep ni cognee, así que sus exportaciones hay que convertirlas antes a ese envoltorio. Por defecto hace una simulación y nunca borra nada.simulación, desde un checkout del repositorio cargo run --manifest-path companions/ai-memory-importer/Cargo.toml -- \ omc-wiki --dir /path/to/omc/wiki --workspace default --project my-projectUsa las dos un tiempo y luego decide
Deja conectada la herramienta vieja mientras comparas. Hazles a las dos las mismas preguntas sobre tu proyecto. Quita la que hayas dejado de usar.
Los formatos y las reglas de seguridad del importador están en la guía de los crates complementarios. Otras formas de traer documentos están en el cookbook.
Preguntas que la gente hace antes de cambiarse
¿Necesito una clave de API de un LLM?
No. La captura, la búsqueda y los traspasos funcionan sin clave y sin LLM. Añadir un proveedor activa la consolidación con LLM, bootstrap, un linting más rico, auto-improve y el rerank opcional. Los inicios de sesión por suscripción, como Codex o GitHub Copilot, también sirven como proveedores.
¿Hay una versión alojada?
No. ai-memory es un único servidor que ejecutas tú en un portátil, en un equipo del homelab o en un host de la LAN. No hay plan SaaS ni consola empresarial.
¿Puedo importar mis datos de Mem0, Zep o cognee?
Directamente, no. El importador complementario lee wikis markdown de oh-my-claudecode y un formato JSON genérico de conversaciones. Los adaptadores para productos concretos viven fuera del repositorio. Para un código que ya existe, ai-memory bootstrap siembra la wiki a partir del historial de git y la documentación.
¿Puedo ejecutar ai-memory junto a mi herramienta de memoria actual?
Sí. Se instala como su propia entrada de servidor MCP y sus propios hooks de ciclo de vida, y no toca la configuración de otras herramientas. Puedes comparar las dos en el mismo proyecto antes de quitar ninguna.
¿Cómo queda su puntuación de recuperación frente a las demás?
En LongMemEval-S obtiene 0,815 de hit@5 con los embeddings locales por defecto y 0,666 solo con texto completo. Esa cifra mide la recuperación y no dice nada sobre la precisión de las respuestas. Los sistemas que hacen rerank puntúan más alto: agentmemory reporta 0,952 y mcp-memory-service reporta 0,860 a nivel de sesión.
¿Sincroniza la memoria entre máquinas?
Usa un solo servidor al que todas tus máquinas llegan por la red. No hay replicación automática entre servidores.
Pruébalo junto a la herramienta que ya tienes.
Se instala al lado de tu configuración actual y no necesita cuenta ni clave de API.