
המוצר
קובץ בינארי אחד, קובצי markdown, אינדקס נגזר
ה-hooks לוכדים את מה שהסוכן עושה. ה-markdown ב-git מחזיק את מה שנלמד. SQLite הוא אינדקס חיפוש שאפשר לזרוק ולבנות מחדש. הדף הזה עובר על הדרך מ-hook ועד התדריך של הסשן הבא, ואומר איפה התכנון עדיין דק.
קובץ בינארי אחד, תיקיית נתונים אחת.
SQLite מגיע בפנים, libgit2 הוא vendored וה-embedder כתוב ב-Rust טהור. אין sidecar, אין שרת מסד נתונים ואין תור שצריך להריץ. כל מה שהוא יודע נמצא בתיקייה אחת.
<data_dir>/
wiki/דפי markdown עם YAML frontmatter, ב-repository של git. מקור האמת.db/memory.sqliteהאינדקס הנגזר: טקסט מלא, ישויות, קישורים, embeddings, סשנים, ביקורת. מצב WAL.raw/מקטעי JSONL שעברו ניקוי ואינם משתנים, מסשנים מנוהלים של ai-memory run.models/מודל ה-embeddings המקומי, all-MiniLM-L6-v2, בערך 87 MB ומקובע ב-SHA-256.logs/פלט לוג יומי מתגלגל.config.tomlנקרא פעם אחת בעלייה. לכל ערך יש override מסוג AI_MEMORY_*.השרת מאזין כברירת מחדל על 127.0.0.1:49374. גיבוי הוא ai-memory backup, או git push של הוויקי יחד עם rsync של התיקייה.
מ-hook ועד התדריך הבא.
שבעה משמונת הצעדים האלה רצים בלי מודל ובלי מפתח API. צעד ה-LLM כבוי עד שמגדירים ספק.
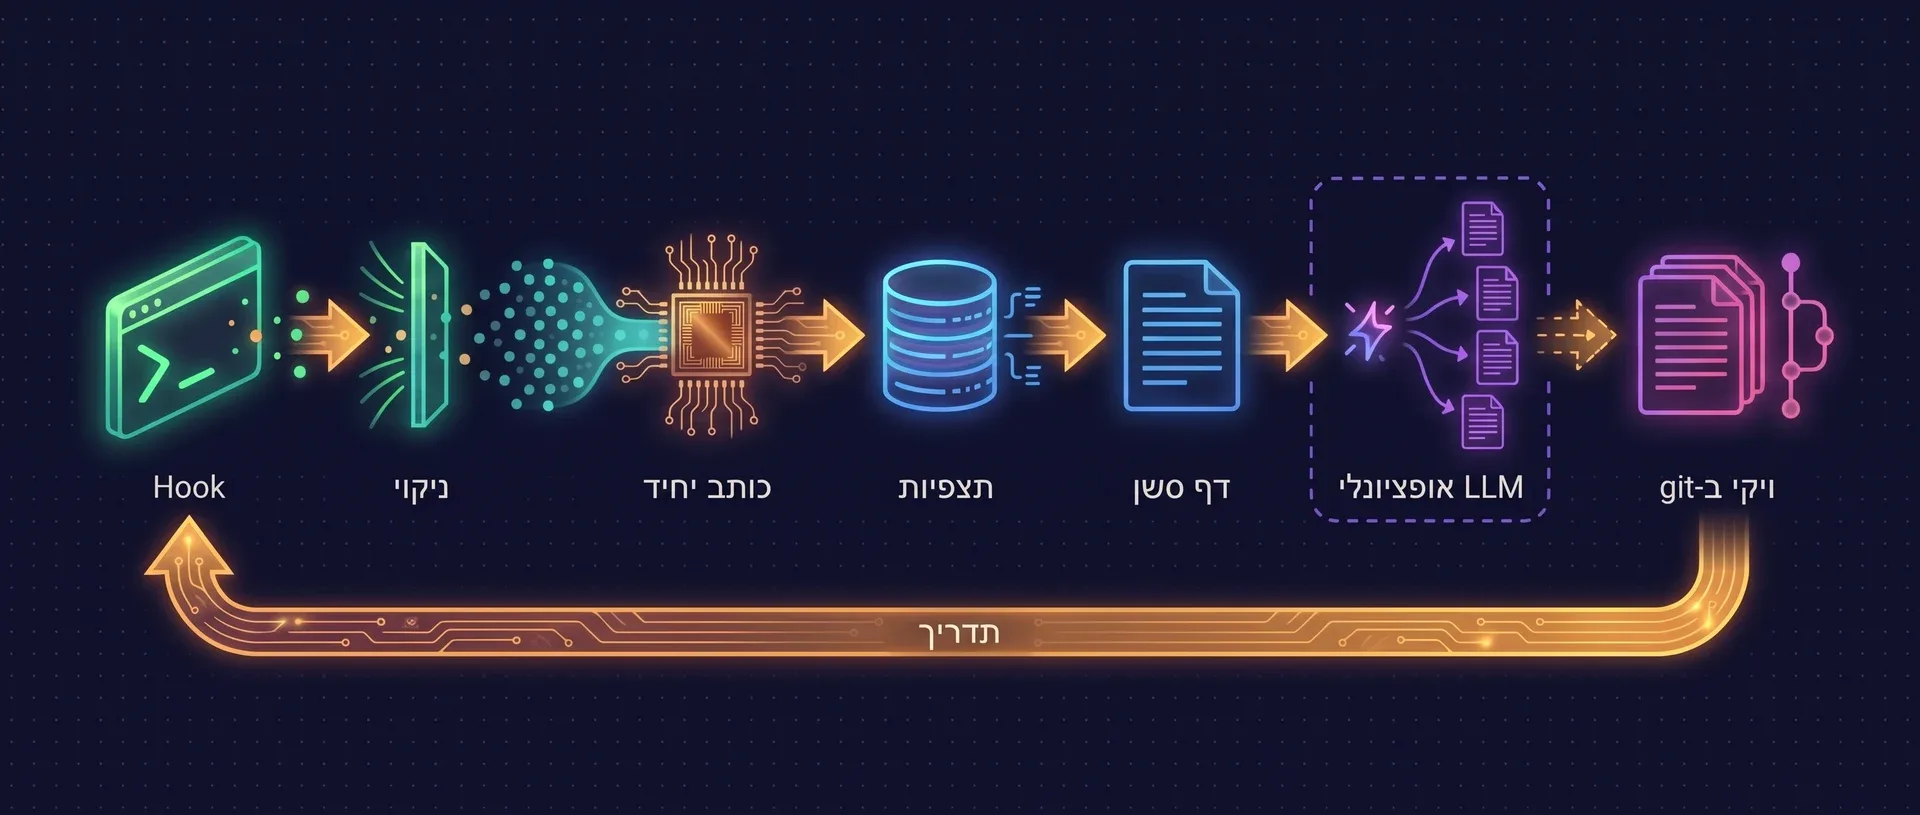
Hookאפס LLM
ה-CLI של הסוכן מפעיל hook של מחזור החיים. זה fire and forget עם תקציב של 200 ms: hooks נייטיב שומרים את האירוע ב-spool מקומי, ותהליך עזר מנותק מעביר אותו הלאה. השרת עונה 202, או 429 כשהוא רווי.
ניקויאפס LLM
ה-router של /hook מסיר סודות ומגביל גדלים. זה הנתיב היחיד מטקסט לא מהימן אל ה-store.
כותב יחידאפס LLM
האירוע הנקי נכנס לתור אחד, ש-thread אחד מרוקן. אותו thread מחזיק בחיבור הכתיבה היחיד.
תצפיותאפס LLM
האירועים נשמרים ב-SQLite בתור audit trail תפעולי. זו השלכה מוגבלת של הסשן, ואף פעם לא תמלול מלא.
סוף הסשןאפס LLM
כללים, בלי מודל, הופכים את התצפיות ל-sessions/<id>.md ופותחים שורת Handoff לסוכן הבא, בטרנזקציה אחת.
איחודLLM אופציונלי
כשמוגדר ספק, LLM כותב מחדש את הסיכום או מפצל אותו ל-concepts/, decisions/, gotchas/ ו-procedures/. זה רץ מתוך תור עם ניסיונות חוזרים, מחוץ להשהיה של ה-hook.
Commit ואינדוקסאפס LLM
כל כתיבת דף היא אטומית (tmp, rename, fsync), נכנסת ב-commit ל-git, ומאונדקסת באותה טרנזקציית SQLite שבה נכתבת השורה שלה.
שאילתה ותדריךאפס LLM
memory_query מחפש באינדקס. ב-SessionStart הבא ה-hook מביא את ההעברה הפתוחה ותדריך מובנה לאותה תיקייה.
שתי שכבות, מקור אמת אחד.
אם הקבצים והאינדקס לא מסכימים, הקבצים מנצחים.
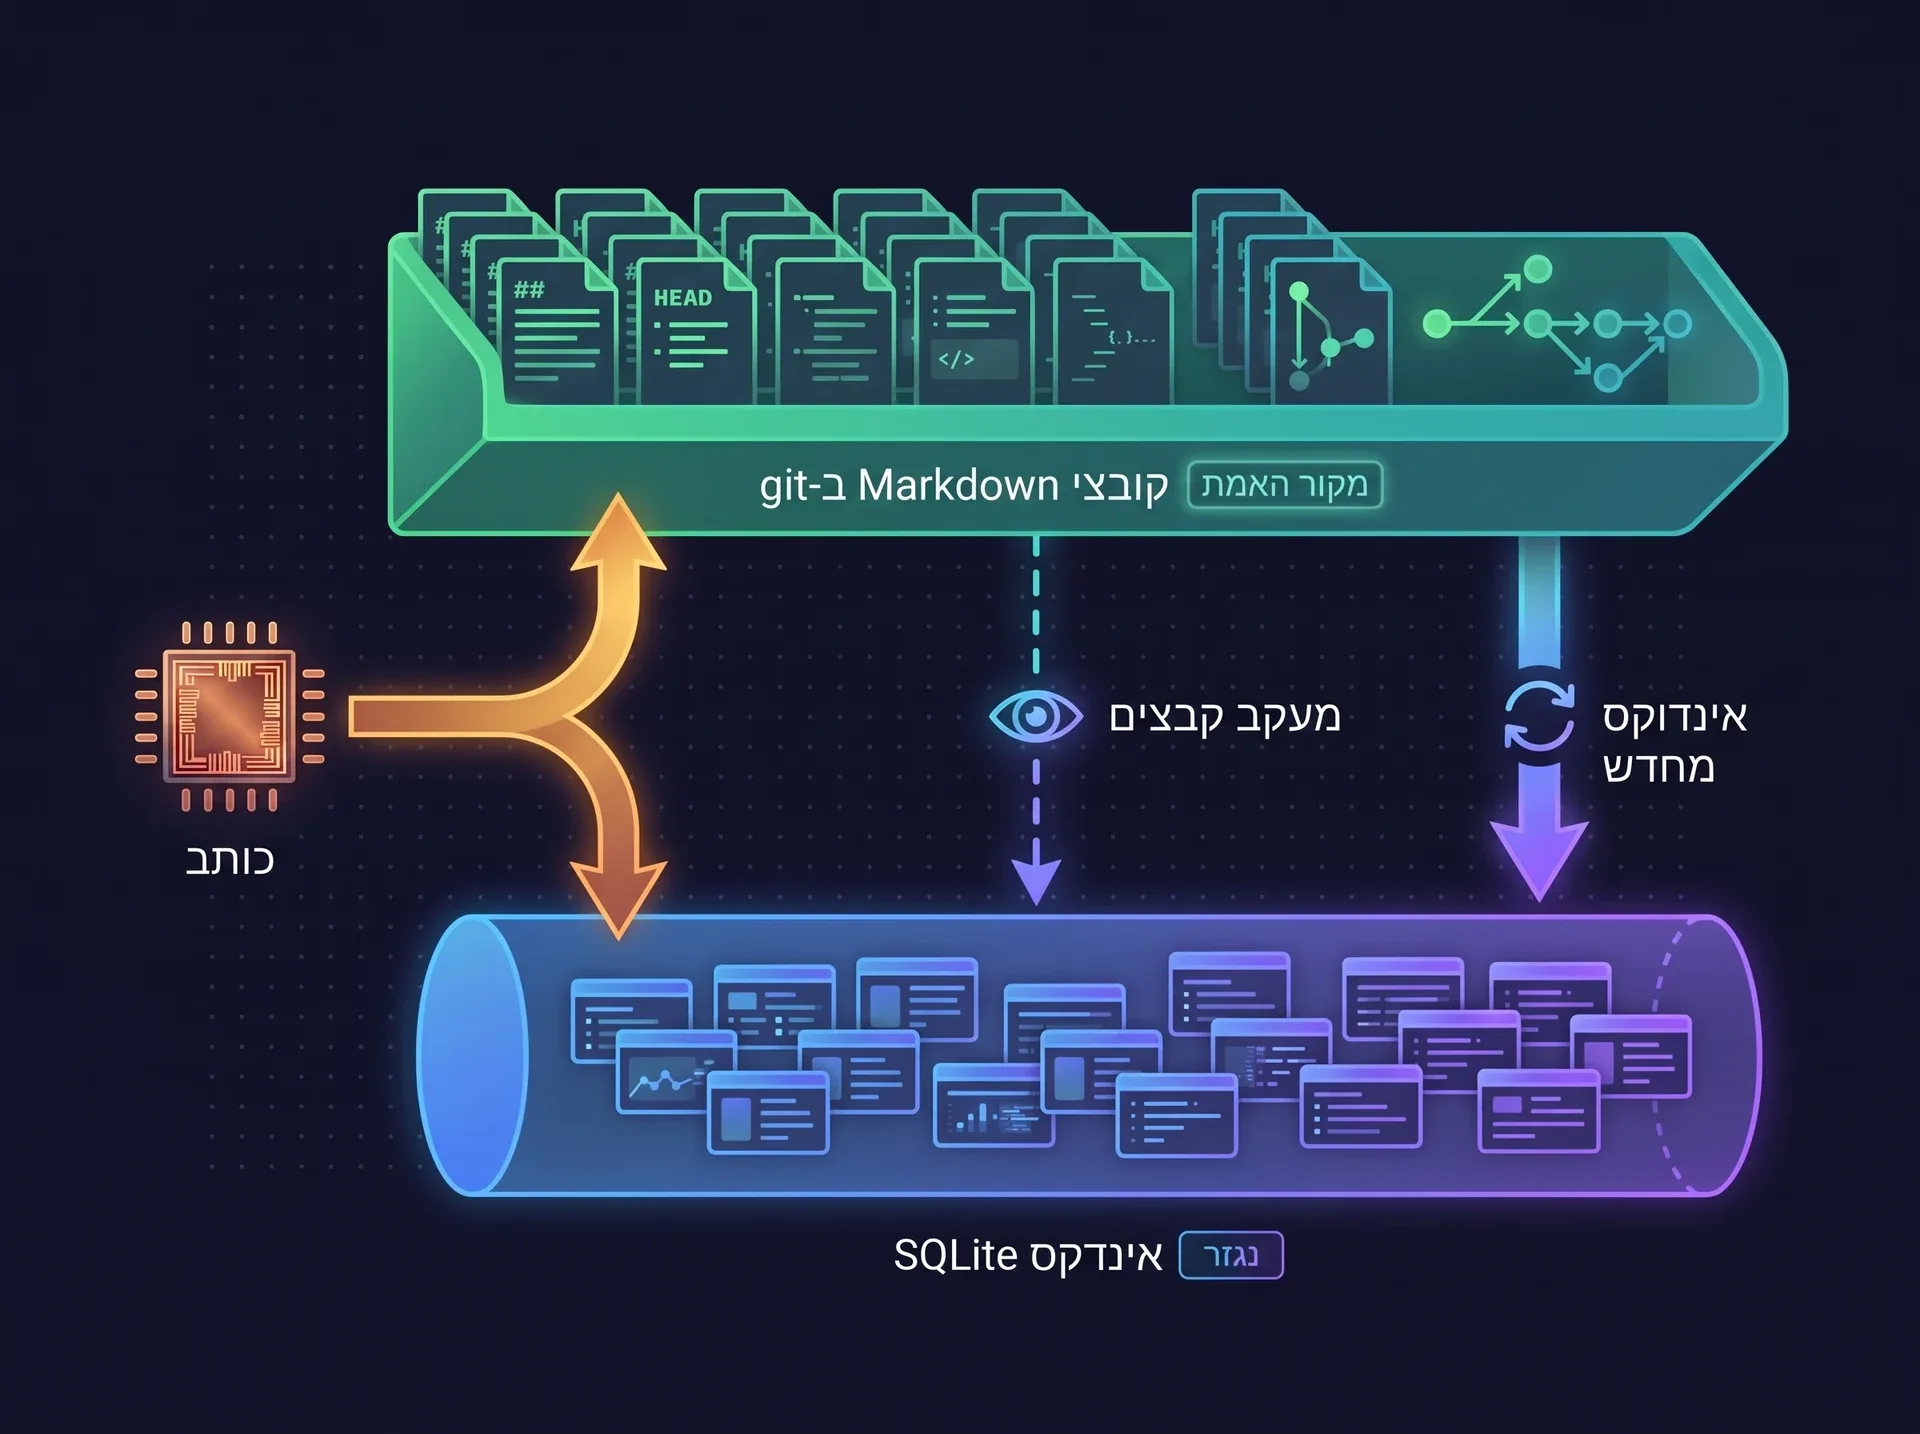
הקבצים הם האמת
הדפים הם markdown עם YAML frontmatter תחת wiki/
/ /. אפשר לפתוח אותם ב-Obsidian, להריץ עליהם grep ולדחוף אותם ל-remote. SQLite הוא נגזר
כל מה שמתאר דף בתוך memory.sqlite אפשר לבנות מחדש מהקבצים עם ai-memory reindex. אינדקס פגום ניתן לשחזור.
הכתיבות שייכות לשרת
כתיבות רגילות עוברות דרך שכבת הוויקי, שמעדכנת יחד את הקובץ, את היסטוריית ה-git ואת האינדקס.
watcher תופס את השאר
עריכות מ-vim או מ-Obsidian נקלטות על ידי file watcher. diff מלא כל 30 שניות תופס אירועים שהוא פספס.
אחזור: ארבעה ערוצים, דירוג אחד.
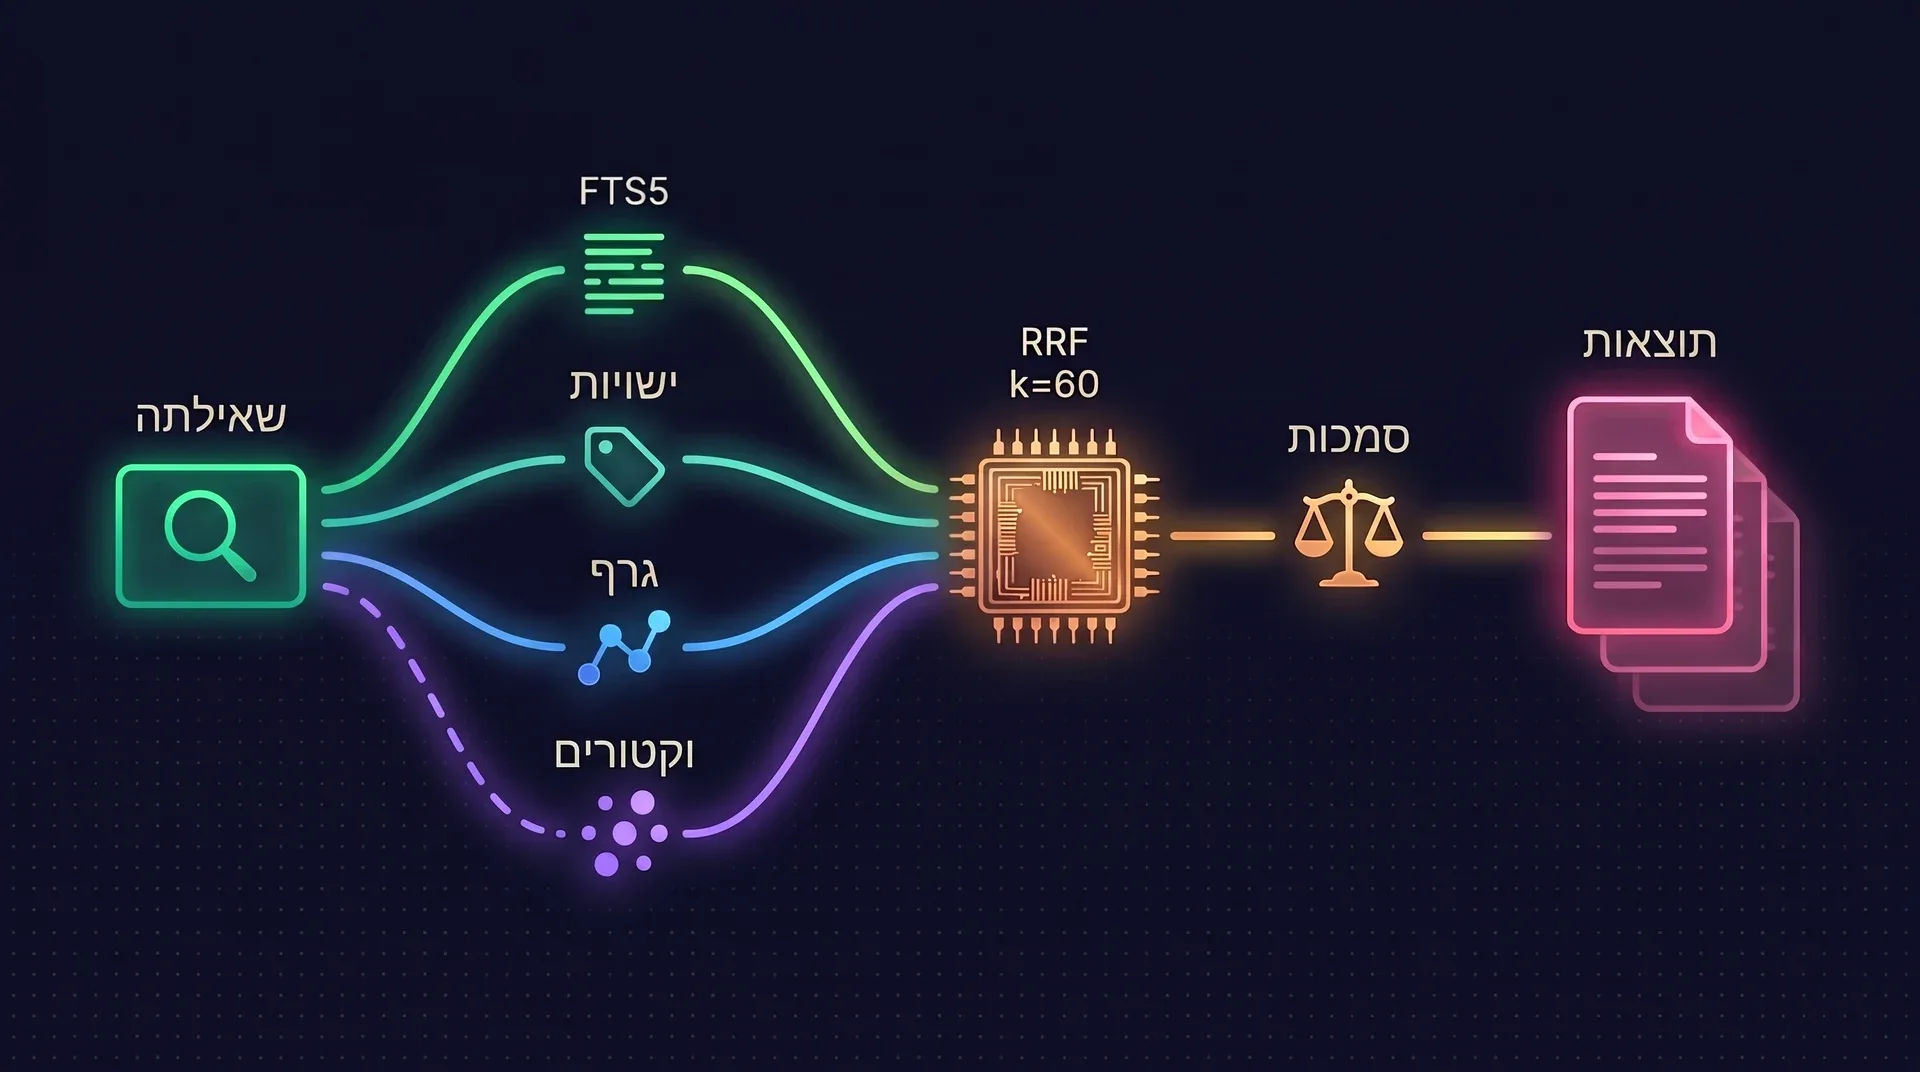
טקסט מלא
SQLite FTS5 על כותרות הדפים והגוף שלהם, עם סינון stopwords משאילתות חשופות.
התאמת ישויות
אינדקס לקסיקלי של שמות מתוך entities ו-tags ב-frontmatter, משוקלל לפי שכיחות דפים הפוכה.
שכנים בגרף
קפיצה אחת על טבלת הקישורים: wikilinks, קישורי markdown, קשתות מטופסות וקישורים בין פרויקטים. SQL רגיל, בלי מסד נתונים גרפי.
וקטורים, אופציונלי
דמיון קוסינוס על embeddings מהמודל המקומי שרץ בתוך התהליך. מופעל כברירת מחדל מאז 2.0, אף פעם לא חובה, ו-brute force בכוונה.
אחרי המיזוג
- Reciprocal Rank Fusion עם k=60 ממזג את הערוצים לפי דירוג, כך שאף ערוץ לא צריך כיול של ציונים.
- אחר כך מכפיל סמכות מוגבל מטה תחרויות צמודות לטובת כללים, החלטות, נהלים ומלכודות מתוחזקים. דפים אפיזודיים והיסטוריים נשארים בחיפוש, ושום דבר לא מוצא החוצה לגמרי.
- LLM rerank אופציונלי: קריאה אחת לכל שאילתה, על עד 30 כותרות וקטעים. בכל כשל נשמר הסדר המקומי. עדיין אין reranker מקומי, וזה הפער של הפרויקט שמזכירים הכי הרבה.
- אם הדפים המקומפלים לא מחזירים כלום, חיפוש מוגבל בתצפיות הגולמיות מחזיר raw_hits.
- מעבירים explain=true כדי לראות לכל תוצאה את הדירוג בכל ערוץ, את תרומות ה-RRF ואת המכפיל.
זמן: as_of
- מעבירים תאריך ISO כדי לשאול מה הוויקי אמר על משהו באותו זמן.
- הוא רושם רק את זמן ההזנה: מתי ai-memory למד עובדה ומתי החליף אותה, ואף פעם לא מתי היא הייתה נכונה בעולם.
- הוא לא משחזר את הדירוג שחיפוש היה מחזיר באותו תאריך.
קשתות מטופסות (typed edges)
- השדה
relations:ב-frontmatter מקבל קבוצה סגורה:causes,fixes,contradicts. שגיאת הקלדה לא יכולה לייצר סוג חדש. contradictsמזין את lint בלי LLM, ומדווח עד שמישהו מיישב את הסתירה.- בחיפוש הן מופיעות ב-explain בלבד: הן מצטרפות לגרף כקישורים רגילים ולא משפיעות על הדירוג, כי הבנצ'מרק לא נתן בסיס למשקל.
memory_read_pageיכול לעבור עליהן כדי להציג דפים קשורים.
תופס אחד, כותב אחד.
שני כללים נושאים את רוב הנכונות: העברה אפשר לתפוס פעם אחת, ורק thread אחד כותב ל-SQLite.
העברות הן פרוטוקול
- העברה היא רשומה מטופסת: סוכן מקור וסוכן יעד, פרויקט, cwd, סיכום, שאלות פתוחות, קבצים שנגעו בהם, צעדים הבאים.
- הקבלה היא compare and set אטומי. סוכן שני שמבקש לא מקבל כלום.
- ה-cwd מותאם לפי גבולות נתיב:
/repoמכסה את/repo/apiואף פעם לא את/repo-other. - העברה ידנית גוברת על האוטומטית. הקבלה מפקיעה מועמדות אוטומטיות ישנות יותר באותה טרנזקציה.
- בשרת משותף העברה שייכת לבעלים שלה, אלא אם היא נשלחה עם
shared=true.
כלל הכותב היחיד, במדידה
כל הכתיבות עוברות דרך תור אחד, מוגבל ל-1024, אל thread אחד של מערכת ההפעלה. קריאות משתמשות ב-pool נפרד לקריאה בלבד. פרץ כתיבות מאט את היצרנים שלו, ואף כתיבה לא נזרקת.
- כותב 142 לשנייה23.9 ms
- 8 כותבים295 לשנייה3.4 ms
- 32 כותבים698 לשנייה1.43 ms
- 128 כותבים700 לשנייה1.43 ms
- התקרה היא בערך 700 כתיבות בשנייה, והיא שטוחה מ-32 כותבים ומעלה. כותב אחד מוגבל על ידי fsync ולא על ידי ה-CPU.
- נמדד על דיסק מקומי מהיר. volume ברשת או volume איטי יתנו מספרים נמוכים משמעותית.
- הבדיקה מפעילה את ה-store ישירות ומדלגת על שכבת ה-HTTP שבחזית.
- אפשר לשחזר עם
cargo test -p ai-memory-store --test writer_throughput -- --ignored --nocapture.
דפי סשן ישנים מקבלים ציון, והקרים שבהם מפונים, מצומצמים או ממוזגים. איך זיכרון מתיישן.
הקוד, לפי crate.
תשעה crates, לכל אחד תפקיד אחד ו-API מטופס, בלי תלויות מעגליות.
| Crate | אחריות |
|---|---|
ai-memory-core | טיפוסי דומיין, שגיאות, מזהים. בלי IO. |
ai-memory-store | SQLite, ה-actor של הכותב, pool הקוראים, חישובי הדעיכה. |
ai-memory-wiki | כתיבות markdown אטומיות, ה-file watcher, git. |
ai-memory-mcp | ה-transport של MCP ו-router הכלים. |
ai-memory-hooks | סכמות ה-payload, ה-sanitizer, הכניסה של /hook. |
ai-memory-llm | גבול האימות מול ספקים, ה-traits של LLM ושל embedder. |
ai-memory-consolidate | ingest, lint, sweep וצינור השיפור האוטומטי. |
ai-memory-workstream | מתאמים לקריאה בלבד לתמלולים נייטיב ולהרצות. |
ai-memory-cli | הקובץ הבינארי ai-memory ותתי-פקודות ה-HTTP הדקות שלו. |
23 כלי MCP, מצומצמים בכוונה
ה-hooks עושים את הלכידה השגרתית, כך שסוכנים כמעט לא צריכים לקרוא לכלים האלה ידנית.
שליפה (7)
memory_querymemory_recentmemory_read_pagememory_read_session_observationsmemory_briefingmemory_explorememory_status
העברות (4)
memory_handoff_beginmemory_handoff_listmemory_handoff_acceptmemory_handoff_cancel
הודעות בין פרויקטים (4)
memory_message_sendmemory_message_listmemory_message_popmemory_message_cancel
כתיבה ותחזוקה (8)
memory_write_pagememory_delete_pagememory_consolidatememory_auto_improvememory_feedbackmemory_lintmemory_forget_sweepmemory_install_self_routing
ARCHITECTURE.md, עם כל 15 האינווריאנטיםהחלטות תכנון ואפשרויות שנדחו
שאלות ותשובות
איפה ai-memory שומר את הנתונים שלו?
בתיקיית נתונים אחת: repository git של דפי markdown תחת wiki/, אינדקס SQLite נגזר תחת db/, מקטעי רצף עבודה שעברו ניקוי תחת raw/, מודל ה-embeddings המקומי תחת models/, ולוגים.
האם ai-memory צריך LLM?
לא. לכידה, סיכומי סשנים, העברות, אינדוקס, חיפוש והתדריך רצים בלי שום ספק מוגדר. איחוד עם LLM, שיפור אוטומטי ו-rerank הם opt-in.
מה קורה אם אינדקס ה-SQLite אבד או נפגם?
קובצי ה-markdown הם מקור האמת. ai-memory reindex בונה מהם מחדש את אינדקס הדפים. אין טרנזקציה משותפת למערכת הקבצים ול-SQLite, ו-reindex הוא גם הדרך לסגור חלונות של קריסה.
איך האחזור מדרג תוצאות?
ארבעה ערוצי מועמדים (טקסט מלא ב-FTS5, התאמת ישויות, שכנים בגרף ווקטורים אופציונליים) מתמזגים עם Reciprocal Rank Fusion ב-k=60, ואז מותאמים עם מכפיל מוגבל של סמכות המקור. LLM rerank הוא אופציונלי, ותצפיות גולמיות הן fallback.
בכמה כתיבות בשנייה הוא עומד?
ב-store נמדדו 42 כתיבות בשנייה עם כותב אחד, 295 עם 8, ותקרה של קרוב ל-700 מ-32 כותבים ומעלה. המספרים נמדדו על דיסק מקומי מהיר, והבדיקה מפעילה את ה-store ישירות בלי שכבת ה-HTTP שבחזית.
לקרוא את הקבצים שהוא כותב.
מתקינים, מריצים סשן אחד, ואז פותחים את תיקיית הוויקי בעורך.