
제품
단일 바이너리, markdown 파일, 파생 인덱스
훅은 에이전트가 하는 일을 캡처합니다. git 속 markdown은 배운 것을 담습니다. SQLite는 버리고 다시 만들 수 있는 검색 인덱스입니다. 이 페이지는 훅에서 다음 세션의 브리핑까지 이어지는 경로를 따라가고, 설계가 아직 얕은 부분도 밝힙니다.
바이너리 하나, 데이터 디렉터리 하나.
SQLite는 번들되어 있고, libgit2는 vendoring되어 있으며, 임베더는 순수 Rust입니다. 따로 돌려야 할 사이드카도, 데이터베이스 서버도, 큐도 없습니다. 아는 것은 전부 폴더 하나에 있습니다.
<data_dir>/
wiki/YAML 프런트매터가 붙은 markdown 페이지, git 저장소 안에 있습니다. 단일 진실 공급원입니다.db/memory.sqlite파생 인덱스: 전문 검색, 엔티티, 링크, 임베딩, 세션, 감사. WAL 모드.raw/관리형 ai-memory run 세션에서 나온, 변경 불가능하고 정제된 JSONL 세그먼트.models/로컬 임베딩 모델 all-MiniLM-L6-v2. 약 87 MB이고 SHA-256이 고정되어 있습니다.logs/일 단위로 롤링되는 로그 출력.config.toml시작할 때 한 번 읽습니다. 모든 값은 AI_MEMORY_*로 덮어쓸 수 있습니다.서버는 기본적으로 127.0.0.1:49374에 바인드합니다. 백업은 ai-memory backup을 실행하거나, 위키를 git push하고 폴더를 rsync하면 됩니다.
훅에서 다음 브리핑까지.
여덟 단계 중 일곱 단계는 모델도 API 키도 없이 실행됩니다. LLM 단계는 제공자를 설정하기 전까지 꺼져 있습니다.
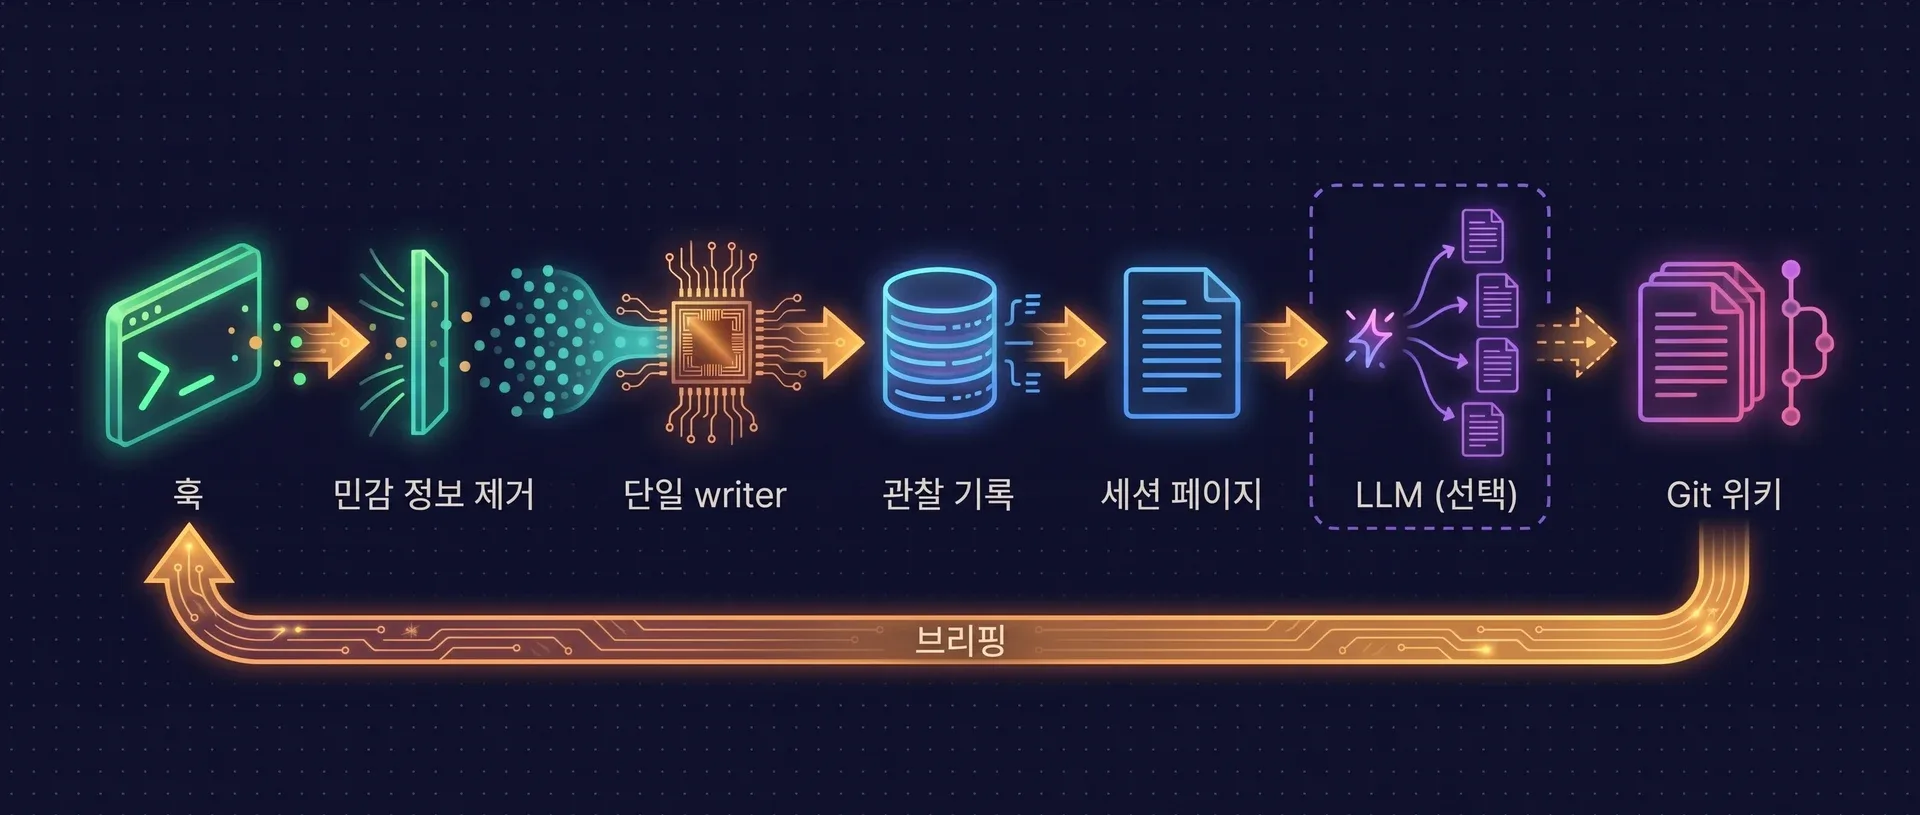
훅LLM 불필요
에이전트 CLI가 라이프사이클 훅을 실행합니다. 200 ms 예산 안에서 fire and forget으로 동작합니다. 네이티브 훅은 이벤트를 로컬에 스풀하고, 분리된 헬퍼가 이를 전달합니다. 서버는 202로 응답하고, 포화 상태에서는 429를 돌려줍니다.
민감 정보 제거LLM 불필요
/hook 라우터가 시크릿을 제거하고 크기를 제한합니다. 신뢰할 수 없는 텍스트가 스토어로 들어가는 경로는 여기뿐입니다.
단일 라이터LLM 불필요
정제된 이벤트는 큐 하나에 들어가고, 유일한 쓰기 커넥션을 가진 스레드 하나가 큐를 비웁니다.
관찰 기록LLM 불필요
이벤트는 운영용 감사 추적으로 SQLite에 쌓입니다. 세션을 제한된 범위로 투영한 것이며 전체 트랜스크립트가 되는 일은 없습니다.
세션 종료LLM 불필요
모델 없이 규칙만으로 관찰 기록을 sessions/<id>.md로 만들고, 다음 에이전트를 위한 Handoff 행을 엽니다. 모두 트랜잭션 하나에서 처리됩니다.
통합LLM 선택
제공자를 설정하면 LLM이 요약을 다시 쓰거나 concepts/, decisions/, gotchas/, procedures/로 펼칩니다. 재시도 가능한 큐에서 실행되므로 훅 지연 시간에 영향을 주지 않습니다.
커밋과 인덱싱LLM 불필요
페이지 쓰기는 매번 원자적(tmp, rename, fsync)이고, git에 커밋되며, 해당 행과 같은 SQLite 트랜잭션 안에서 인덱싱됩니다.
쿼리와 브리핑LLM 불필요
memory_query가 인덱스를 검색합니다. 다음 SessionStart에서 훅이 그 디렉터리에 열려 있는 인수인계와 구조화된 브리핑을 가져옵니다.
두 개의 계층, 하나의 원본.
파일과 인덱스가 서로 다르면 파일이 이깁니다.
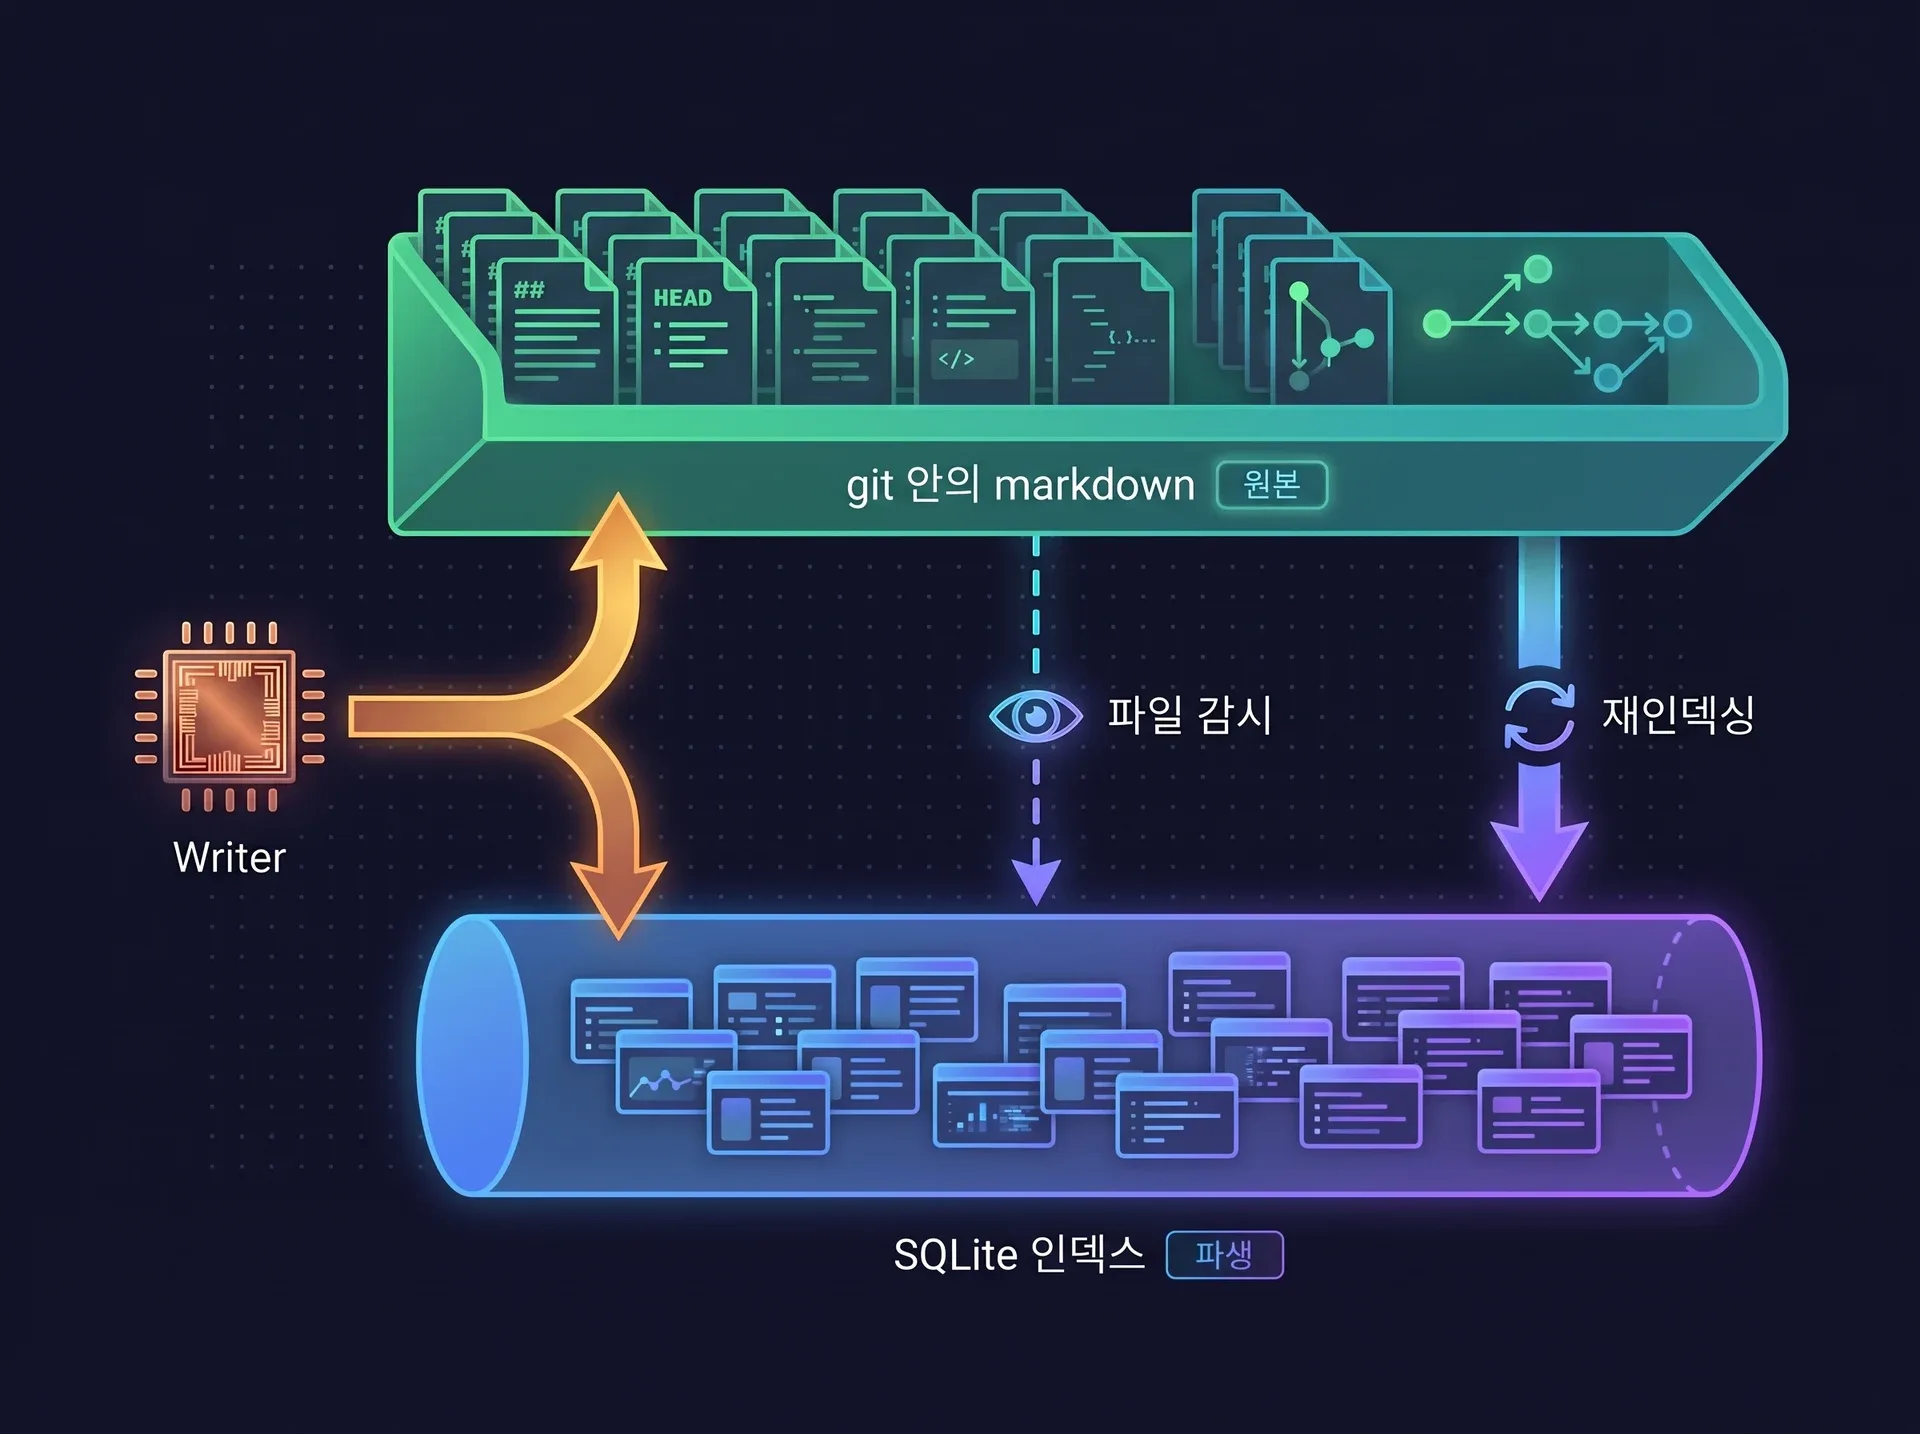
파일이 원본입니다
페이지는 wiki/
/ / 아래에 있는, YAML 프런트매터가 붙은 markdown입니다. Obsidian으로 열고, grep하고, 리모트로 push하세요. SQLite는 파생입니다
memory.sqlite에서 페이지를 설명하는 모든 것은 ai-memory reindex로 파일에서 다시 만들 수 있습니다. 인덱스가 깨져도 복구할 수 있습니다.
쓰기는 서버가 관리합니다
일반적인 쓰기는 위키 계층을 거치며, 이 계층이 파일, git 히스토리, 인덱스를 함께 갱신합니다.
나머지는 감시기가 잡습니다
vim이나 Obsidian에서 한 편집은 파일 감시기가 감지합니다. 놓친 이벤트는 30초마다 도는 전체 diff가 잡아냅니다.
검색: 네 개의 스트림, 하나의 순위.
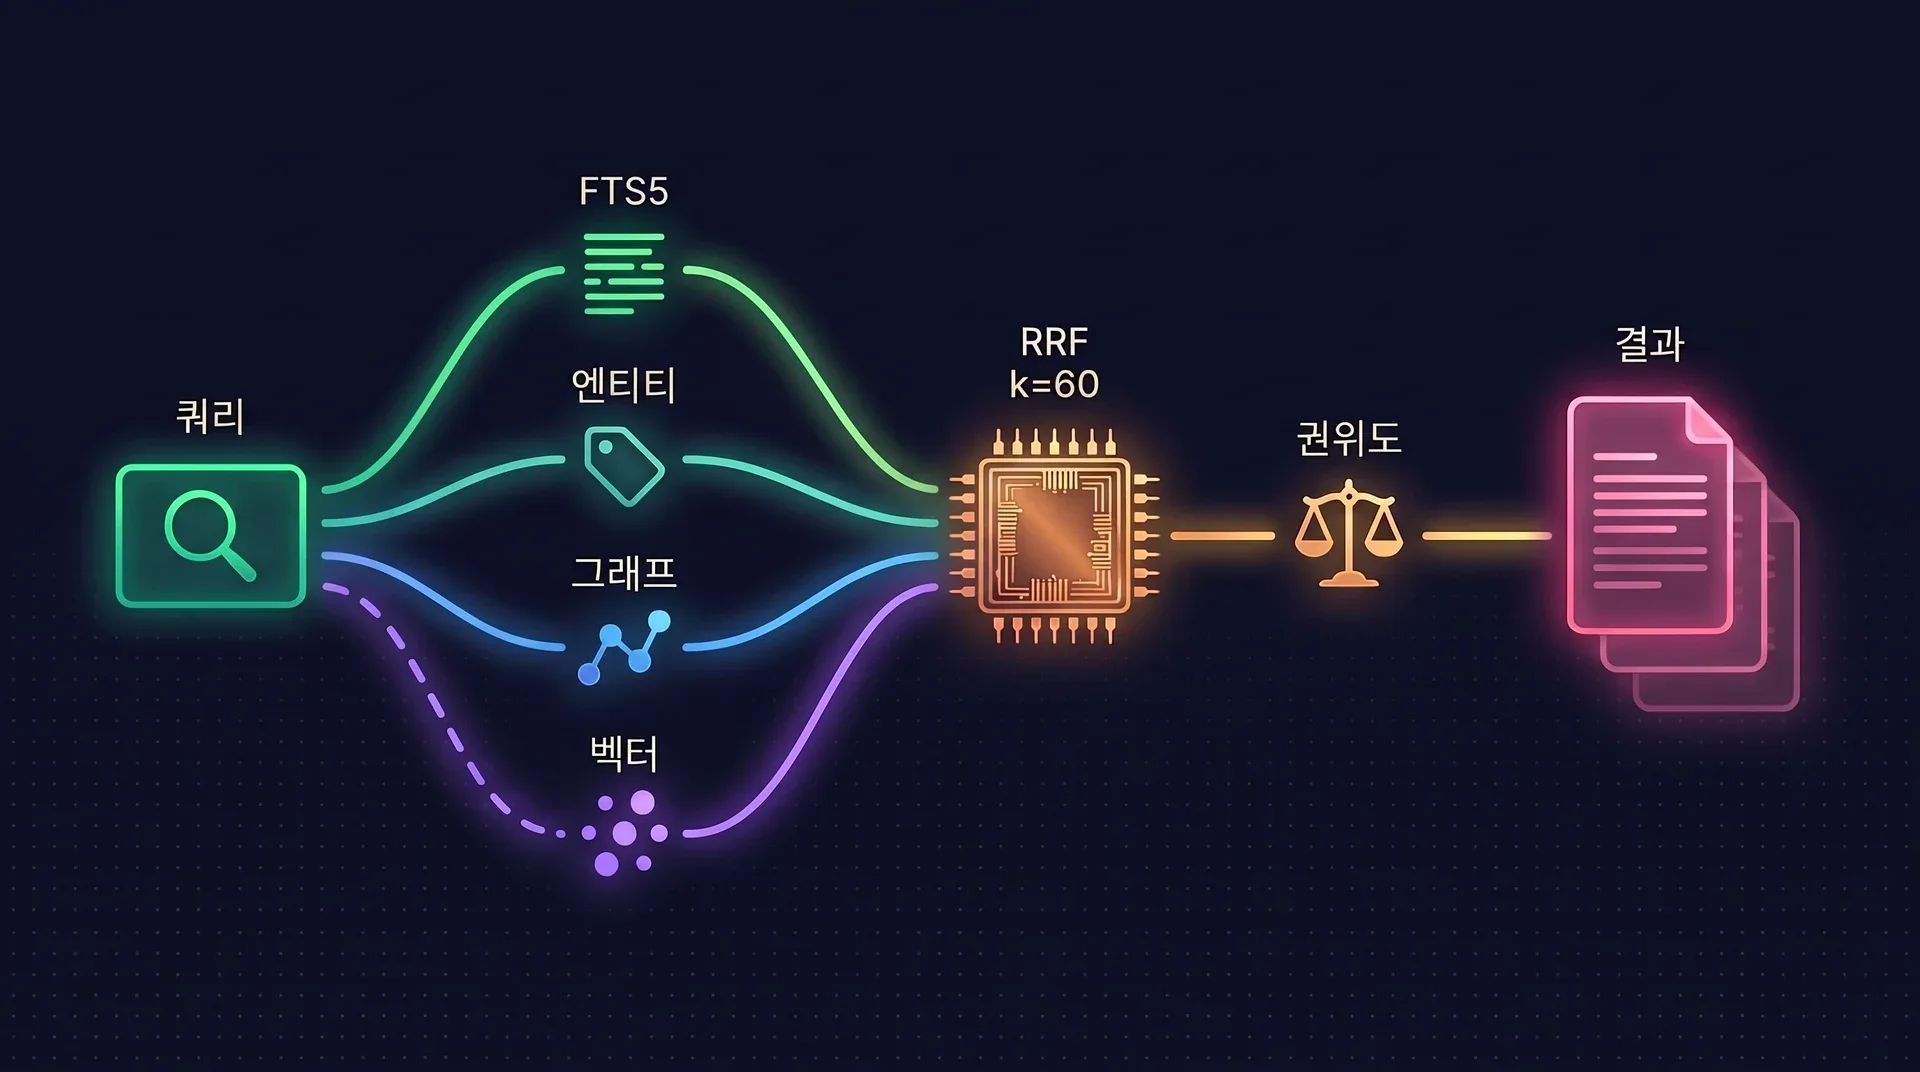
전문 검색
페이지 제목과 본문에 대한 SQLite FTS5. 단순 쿼리에서는 불용어를 걸러 냅니다.
엔티티 매칭
프런트매터의 entities와 tags에서 뽑은 이름의 어휘 인덱스. 역페이지 빈도로 가중치를 줍니다.
그래프 이웃
링크 테이블에서 한 홉: 위키링크, markdown 링크, 타입 엣지, 프로젝트 간 링크. 그래프 데이터베이스 없이 일반 SQL입니다.
벡터, 선택 사항
프로세스 내 로컬 모델이 만든 임베딩에 대한 코사인 유사도. 2.0부터 기본으로 켜져 있지만 필수는 아니며, 의도적으로 브루트 포스입니다.
융합 이후
- k=60의 Reciprocal Rank Fusion이 스트림을 순위 기준으로 합치므로, 어떤 스트림도 점수 보정이 필요 없습니다.
- 그다음 상한이 있는 권위도 배수가 근소한 경합을 관리되는 규칙, 결정, 절차, 주의점 쪽으로 살짝 기울입니다. 에피소드성 페이지와 과거 기록 페이지도 계속 검색되며, 아예 제외되는 것은 없습니다.
- 선택적 LLM 리랭크: 쿼리당 호출 한 번, 제목과 스니펫 최대 30개가 대상입니다. 실패하면 로컬 순서를 그대로 씁니다. 로컬 리랭커는 아직 없으며, 이 프로젝트에서 가장 자주 지적되는 공백입니다.
- 컴파일된 페이지에서 아무것도 찾지 못하면 원본 관찰 기록에 대한 제한된 검색이 raw_hits를 돌려줍니다.
- explain=true를 넘기면 결과마다 스트림별 순위, RRF 기여도, 배수를 볼 수 있습니다.
시간: as_of
- ISO 날짜를 넘기면 그 시점에 위키가 무엇이라고 했는지 물을 수 있습니다.
- 기록하는 것은 수집 시점뿐입니다. ai-memory가 사실을 알게 된 때와 그것을 대체한 때를 기록하며, 현실에서 그 사실이 참이었던 때는 기록하지 않습니다.
- 그 날짜에 검색했다면 나왔을 순위를 재현하지는 않습니다.
타입 엣지
- 프런트매터의
relations:는 닫힌 집합만 받습니다:causes,fixes,contradicts. 오타로 새 종류가 생길 수 없습니다. contradicts는 LLM 없이 린트에 반영되고, 누군가 정리할 때까지 계속 보고됩니다.- 검색에서는 explain 전용입니다. 일반 링크로 그래프에 들어갈 뿐 순위를 움직이지 않습니다. 벤치마크에서 가중치를 줄 근거가 나오지 않았기 때문입니다.
memory_read_page는 이 엣지를 따라가 관련 페이지를 나열할 수 있습니다.
수령도 한 번, 라이터도 하나.
정확성의 대부분은 두 가지 규칙이 떠받칩니다. 인수인계는 한 번만 수령할 수 있고, SQLite에는 스레드 하나만 씁니다.
인수인계는 프로토콜입니다
- 인수인계는 타입이 있는 레코드입니다: 보내는 에이전트와 받는 에이전트, 프로젝트, cwd, 요약, 미해결 질문, 수정한 파일, 다음 단계.
- 수락은 원자적 compare and set입니다. 두 번째로 요청한 에이전트는 아무것도 받지 못합니다.
- cwd는 경로 경계를 기준으로 일치를 봅니다.
/repo는/repo/api를 포함하지만/repo-other는 절대 포함하지 않습니다. - 수동 인수인계가 자동 인수인계보다 우선합니다. 수락하면 같은 트랜잭션 안에서 더 오래된 자동 후보가 만료됩니다.
- 공유 서버에서 인수인계는
shared=true로 보내지 않는 한 소유자의 것입니다.
단일 라이터 규칙, 측정 결과
모든 쓰기는 크기 1024의 제한된 큐 하나를 거쳐 OS 스레드 하나로 갑니다. 읽기는 별도의 읽기 전용 풀을 씁니다. 부하가 몰리면 생산자가 느려질 뿐 쓰기는 하나도 버려지지 않습니다.
- 라이터 1개42/s23.9 ms
- 라이터 8개295/s3.4 ms
- 라이터 32개698/s1.43 ms
- 라이터 128개700/s1.43 ms
- 상한은 초당 약 700건이며 라이터 32개부터는 늘지 않습니다. 라이터가 하나일 때 병목은 fsync이고 CPU는 여유가 있습니다.
- 빠른 로컬 디스크에서 측정했습니다. 네트워크 볼륨이나 느린 볼륨에서는 눈에 띄게 낮아집니다.
- 테스트는 스토어를 직접 구동하며 HTTP 진입점은 거치지 않습니다.
cargo test -p ai-memory-store --test writer_throughput -- --ignored --nocapture로 재현할 수 있습니다.
오래된 세션 페이지에는 점수가 매겨지고, 콜드 페이지는 퇴출, 압축 또는 병합됩니다. 기억이 나이 드는 방식.
crate별로 본 코드.
crate는 아홉 개입니다. 각자 한 가지 일과 타입이 있는 API를 맡고, 순환 의존성은 없습니다.
| Crate | 역할 |
|---|---|
ai-memory-core | 도메인 타입, 에러, id. IO 없음. |
ai-memory-store | SQLite, 라이터 액터, 리더 풀, 감쇠 계산. |
ai-memory-wiki | 원자적 markdown 쓰기, 파일 감시기, git. |
ai-memory-mcp | MCP 전송과 도구 라우터. |
ai-memory-hooks | 페이로드 스키마, 새니타이저, /hook 수신부. |
ai-memory-llm | 제공자 인증 경계, LLM과 임베더 trait. |
ai-memory-consolidate | 수집, 린트, sweep, auto-improve 파이프라인. |
ai-memory-workstream | 읽기 전용 네이티브 트랜스크립트와 실행 어댑터. |
ai-memory-cli | ai-memory 바이너리와 얇은 HTTP 서브커맨드. |
MCP 도구 23개, 의도적으로 좁게
일상적인 캡처는 훅이 하므로, 에이전트가 이 도구들을 직접 호출할 일은 드뭅니다.
회상 (7)
memory_querymemory_recentmemory_read_pagememory_read_session_observationsmemory_briefingmemory_explorememory_status
인수인계 (4)
memory_handoff_beginmemory_handoff_listmemory_handoff_acceptmemory_handoff_cancel
프로젝트 간 메시지 (4)
memory_message_sendmemory_message_listmemory_message_popmemory_message_cancel
쓰기와 유지 관리 (8)
memory_write_pagememory_delete_pagememory_consolidatememory_auto_improvememory_feedbackmemory_lintmemory_forget_sweepmemory_install_self_routing
자주 묻는 질문
ai-memory는 데이터를 어디에 보관하나요?
데이터 디렉터리 하나에 보관합니다. wiki/ 아래에 markdown 페이지의 git 저장소, db/ 아래에 파생 SQLite 인덱스, raw/ 아래에 정제된 워크스트림 세그먼트, models/ 아래에 로컬 임베딩 모델, 그리고 로그가 있습니다.
ai-memory에 LLM이 필요한가요?
아니요. 캡처, 세션 요약, 인수인계, 인덱싱, 검색, 브리핑은 제공자를 설정하지 않아도 동작합니다. LLM 통합, 자동 개선, 리랭크는 옵트인입니다.
SQLite 인덱스가 사라지거나 깨지면 어떻게 되나요?
markdown 파일이 단일 진실 공급원입니다. ai-memory reindex가 파일에서 페이지 인덱스를 다시 만듭니다. 파일 시스템과 SQLite를 아우르는 트랜잭션은 없으며, 크래시로 생긴 불일치 구간도 reindex로 바로잡습니다.
검색 결과의 순위는 어떻게 매기나요?
네 개의 후보 스트림(FTS5 전문 검색, 엔티티 매칭, 그래프 이웃, 선택적 벡터)을 k=60의 Reciprocal Rank Fusion으로 융합한 뒤, 상한이 있는 출처 권위도 배수로 조정합니다. LLM 리랭크는 선택 사항이고, 원본 관찰 기록은 폴백입니다.
초당 쓰기를 몇 건까지 처리하나요?
스토어 측정값은 라이터 하나일 때 초당 42건, 8개일 때 295건이고, 32개부터는 700건 부근이 상한입니다. 빠른 로컬 디스크에서 나온 수치이며, 테스트는 HTTP 진입점 없이 스토어를 직접 구동합니다.