
Produto
Um binário só, arquivos markdown, um índice derivado
Os hooks capturam o que o seu agente faz. O markdown em git guarda o que foi aprendido. O SQLite é um índice de busca que você pode jogar fora e reconstruir. Esta página percorre o caminho de um hook até o briefing da próxima sessão e mostra onde o design ainda é raso.
Um binário só, um diretório de dados.
O SQLite vai embutido, o libgit2 vai vendorizado e o embedder é Rust puro. Não tem sidecar, servidor de banco nem fila para manter rodando. Tudo o que ele sabe está numa pasta só.
<data_dir>/
wiki/Páginas markdown com frontmatter YAML, num repositório git. A fonte da verdade.db/memory.sqliteO índice derivado: full-text, entidades, links, embeddings, sessões, auditoria. Modo WAL.raw/Segmentos JSONL imutáveis e sanitizados das sessões gerenciadas de ai-memory run.models/O modelo local de embeddings, all-MiniLM-L6-v2, cerca de 87 MB e com SHA-256 fixado.logs/Saída de log com rotação diária.config.tomlLido uma vez na inicialização. Todo valor tem um override AI_MEMORY_*.Por padrão o servidor faz bind em 127.0.0.1:49374. Fazer backup é rodar ai-memory backup, ou um git push da wiki mais um rsync da pasta.
De um hook até o próximo briefing.
Sete destes oito passos rodam sem modelo e sem chave de API. O passo com LLM fica desligado até você configurar um provedor.
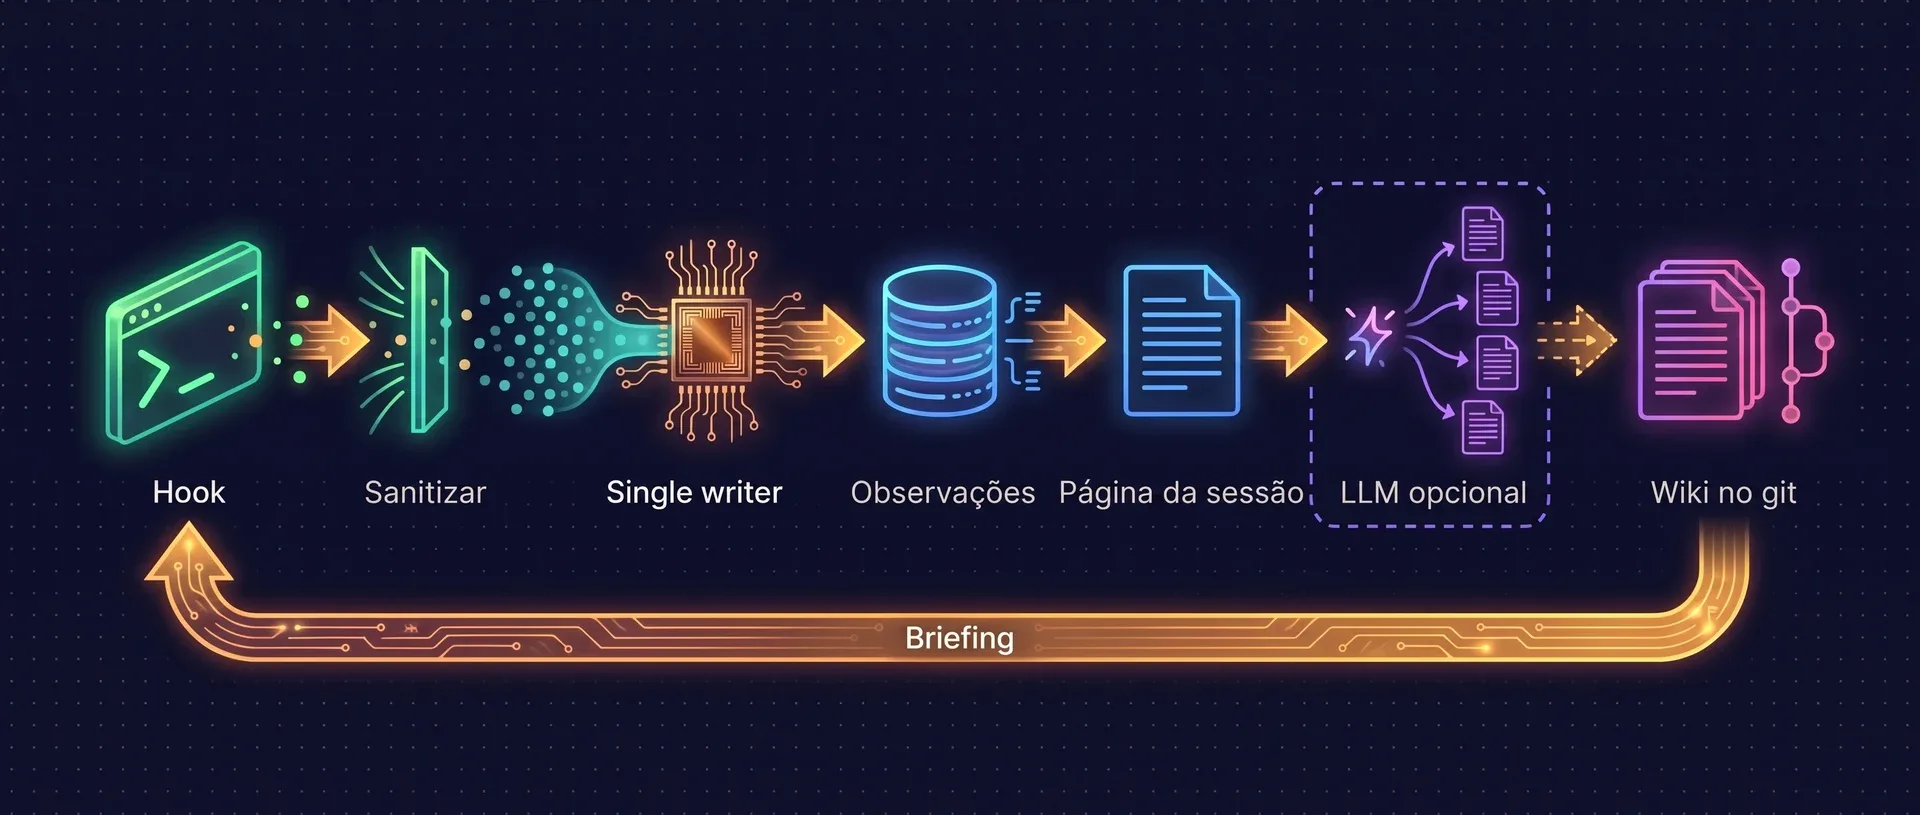
HookZero LLM
A CLI do agente dispara um hook de ciclo de vida. É fire and forget com um orçamento de 200 ms: os hooks nativos guardam o evento num spool local e um helper destacado faz a entrega. O servidor responde 202, ou 429 quando está saturado.
SanitizaçãoZero LLM
O router de /hook remove segredos e limita tamanhos. Este é o único caminho de texto não confiável até o store.
Writer únicoZero LLM
O evento sanitizado entra numa fila só, drenada por uma thread só, que é dona da única conexão de escrita.
ObservaçõesZero LLM
Os eventos caem no SQLite como uma trilha de auditoria operacional. É uma projeção limitada da sessão, nunca uma transcrição completa.
Fim da sessãoZero LLM
Regras, sem modelo, transformam as observações em sessions/<id>.md e abrem uma linha de Handoff para o próximo agente, numa transação só.
ConsolidaçãoLLM opcional
Com um provedor configurado, um LLM reescreve o resumo ou o desdobra em concepts/, decisions/, gotchas/ e procedures/. Roda a partir de uma fila com retry, fora da latência dos hooks.
Commit e indexaçãoZero LLM
Cada escrita de página é atômica (tmp, rename, fsync), commitada no git e indexada na mesma transação SQLite que a linha dela.
Consulta e briefingZero LLM
memory_query busca no índice. No próximo SessionStart, o hook pega o handoff aberto e um briefing estruturado para aquele diretório.
Duas camadas, uma fonte da verdade.
Se os arquivos e o índice discordam, os arquivos vencem.
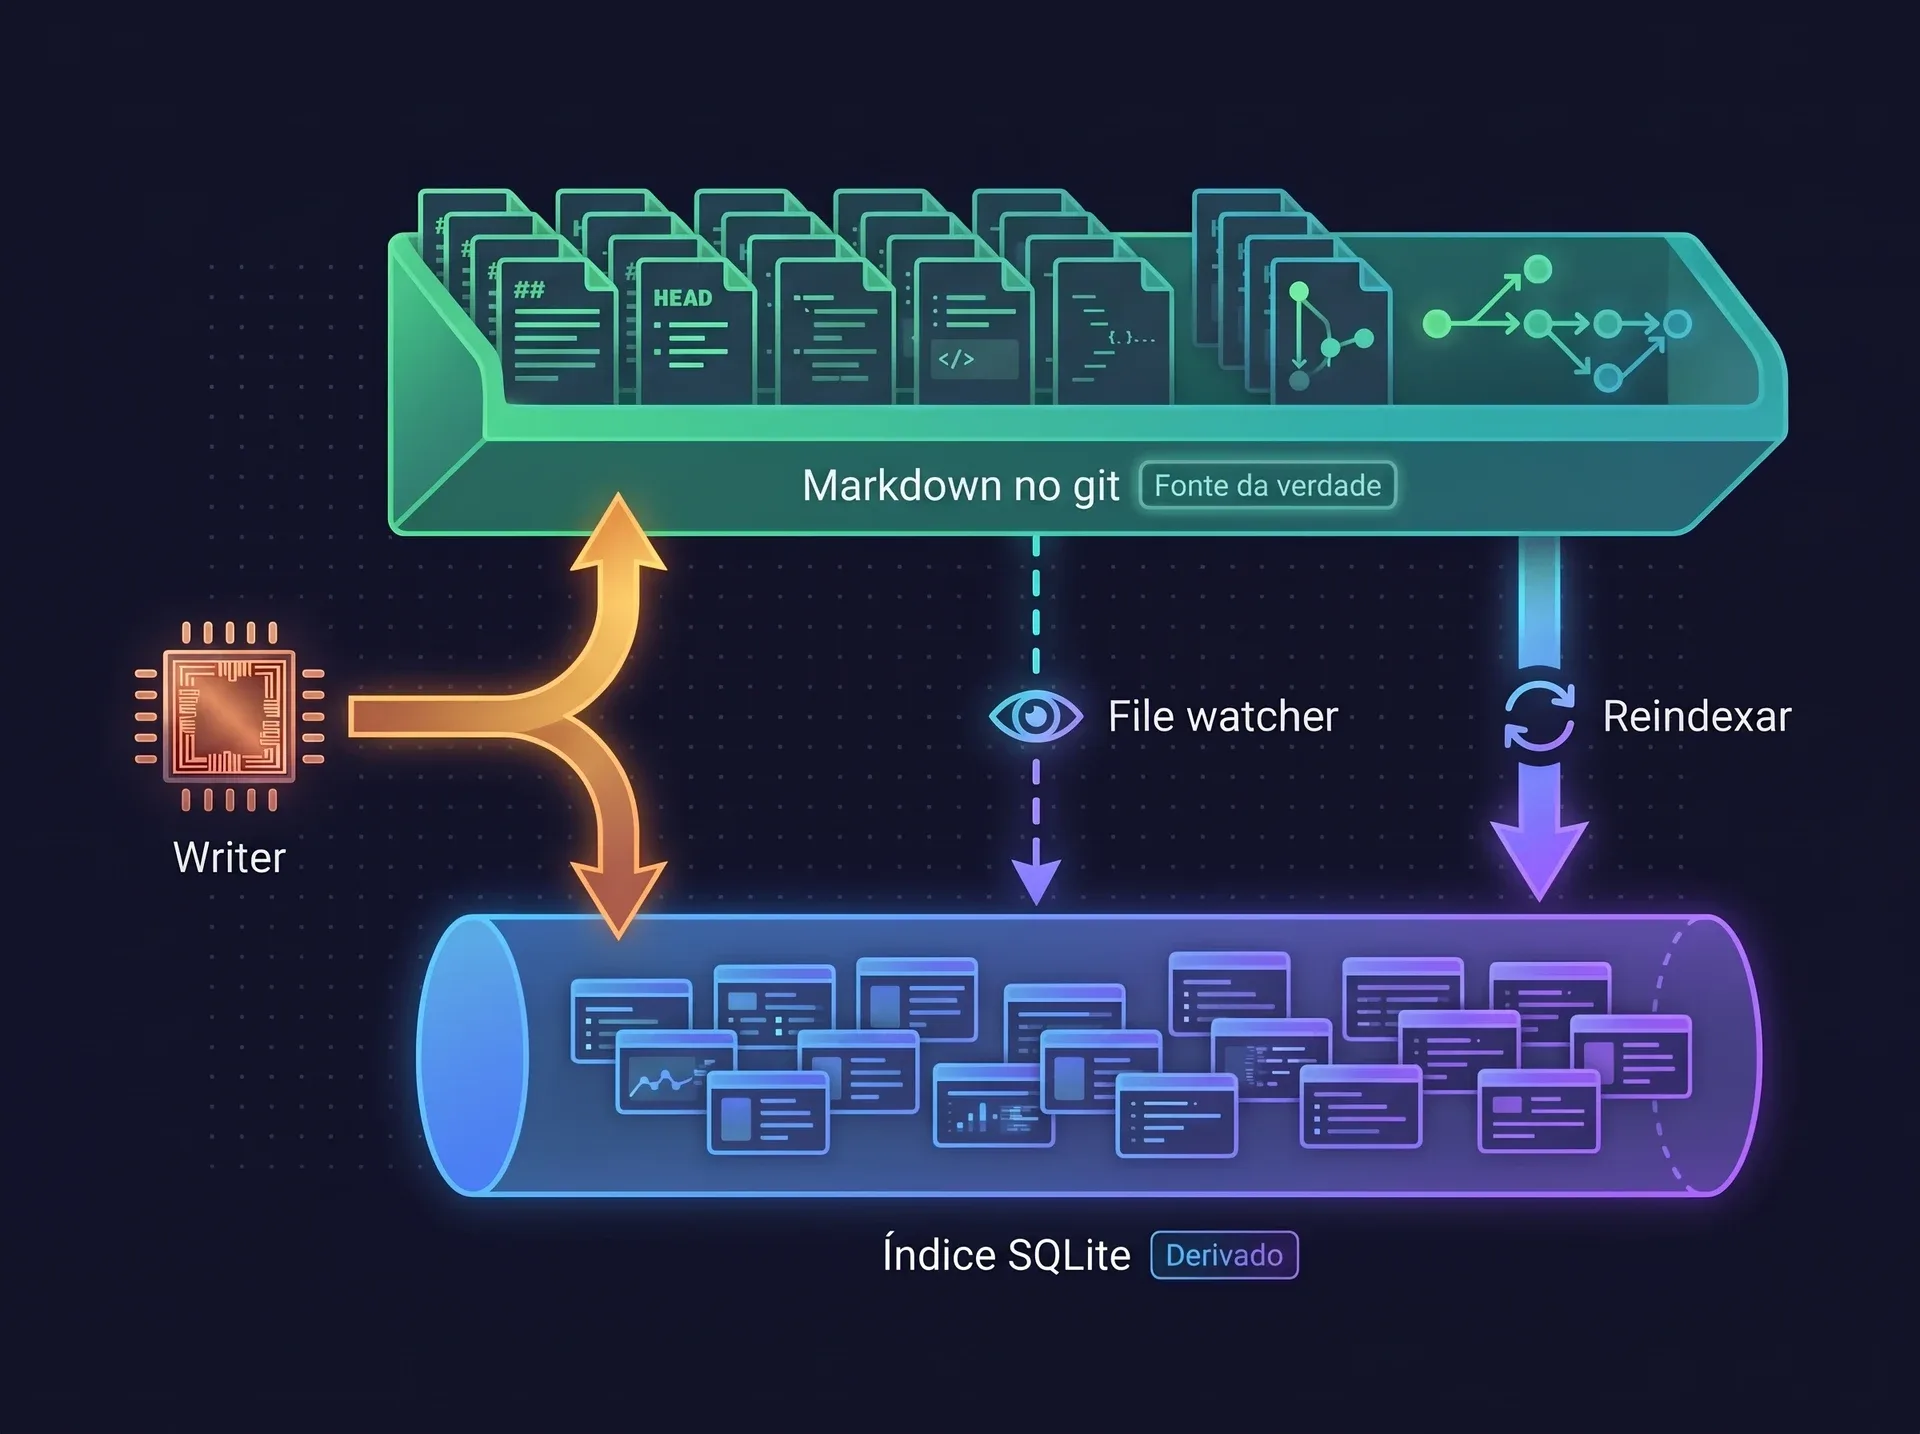
Os arquivos são a verdade
As páginas são markdown com frontmatter YAML em wiki/
/ /. Abra no Obsidian, passe um grep, faça push para um remote. O SQLite é derivado
Tudo no memory.sqlite que descreve uma página pode ser reconstruído a partir dos arquivos com ai-memory reindex. Um índice corrompido tem conserto.
As escritas são do servidor
As escritas normais passam pela camada da wiki, que atualiza junto o arquivo, o histórico git e o índice.
Um watcher pega o resto
Edições feitas no vim ou no Obsidian são detectadas por um file watcher. Um diff completo a cada 30 segundos pega os eventos que ele perdeu.
Recuperação: quatro fluxos, um ranking.
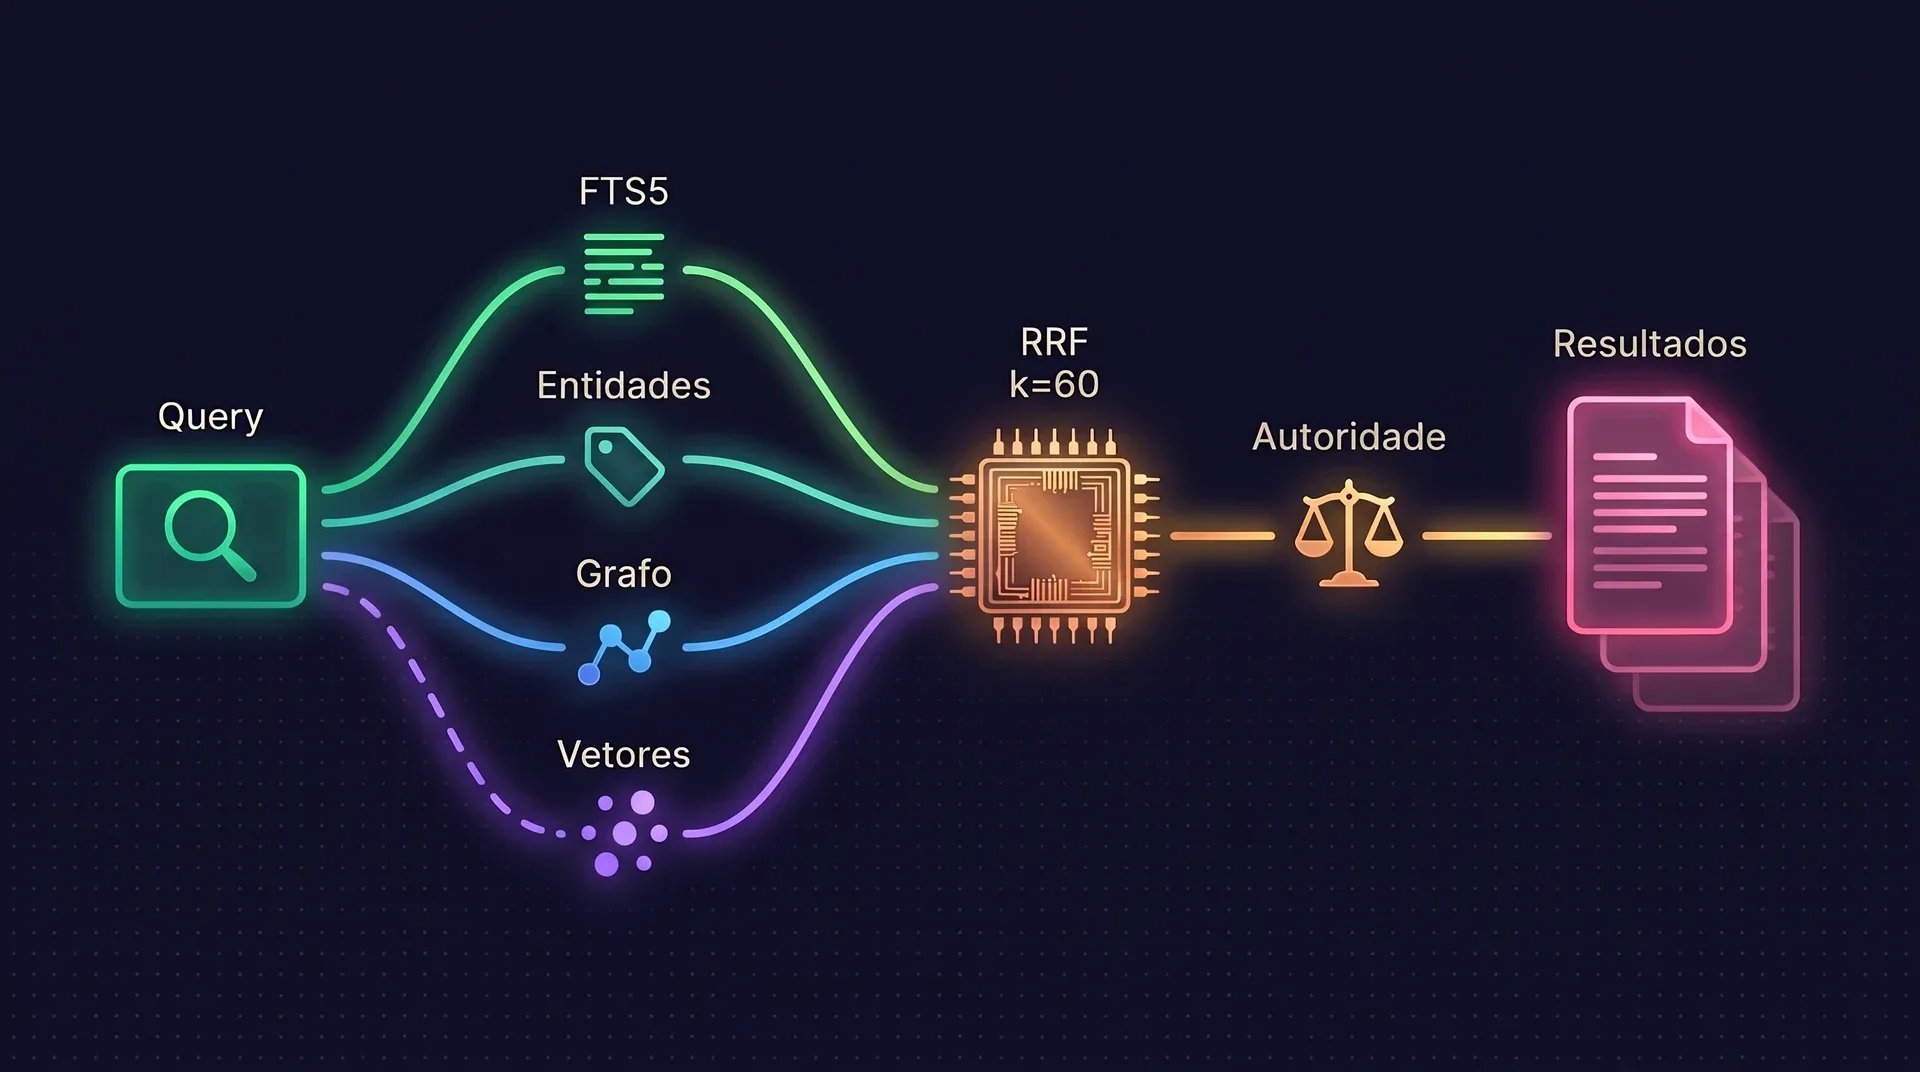
Full-text
SQLite FTS5 sobre títulos e corpos das páginas, com stopwords filtradas nas consultas simples.
Match de entidades
Um índice léxico de nomes vindos das entidades e tags do frontmatter, com peso pela frequência inversa de páginas.
Vizinhos no grafo
Um salto pela tabela de links: wikilinks, links markdown, arestas tipadas e links entre projetos. SQL puro, sem banco de grafos.
Vetores, opcionais
Similaridade de cosseno sobre embeddings do modelo local que roda dentro do processo. Ligado por padrão desde a 2.0, nunca obrigatório, e força bruta de propósito.
Depois da fusão
- Reciprocal Rank Fusion com k=60 junta os fluxos pela posição no ranking, então nenhum fluxo precisa de calibração de score.
- Um multiplicador de autoridade com limite empurra então as disputas apertadas para o lado de regras, decisões, procedimentos e gotchas mantidos. Páginas episódicas e históricas continuam aparecendo na busca, e nada é excluído de cara.
- Rerank opcional por LLM: uma chamada por consulta sobre até 30 títulos e trechos. Qualquer falha mantém a ordem local. Ainda não existe um reranker local, e essa é a lacuna mais citada do projeto.
- Se as páginas compiladas não trouxerem nada, uma busca limitada nas observações brutas devolve raw_hits.
- Passe explain=true para ver, em cada resultado, as posições por fluxo, as contribuições do RRF e o multiplicador.
Tempo: as_of
- Passe uma data ISO para perguntar o que a wiki dizia sobre um assunto naquela época.
- Ele registra só o tempo de ingestão: quando o ai-memory aprendeu um fato e quando o substituiu, nunca quando ele era verdade no mundo.
- Ele não reproduz o ranking que uma busca teria devolvido naquela data.
Arestas tipadas
- O
relations:do frontmatter aceita um conjunto fechado:causes,fixes,contradicts. Um erro de digitação não consegue criar um tipo novo. contradictsalimenta o lint sem LLM e continua sendo reportado até alguém resolver a contradição.- Na busca elas só aparecem no explain: entram no grafo como links comuns e não mexem no ranking, porque o benchmark não deu base para um peso. O
memory_read_pageconsegue percorrê-las para listar páginas relacionadas.
Um só assume, um só escreve.
Duas regras seguram a maior parte da corretude: um handoff só pode ser assumido uma vez, e só uma thread escreve no SQLite.
Handoff é um protocolo
- Um handoff é um registro tipado: agente de origem e de destino, projeto, cwd, resumo, perguntas em aberto, arquivos tocados, próximos passos.
- Aceitar é um compare and set atômico. Um segundo agente que pedir não recebe nada.
- O cwd casa por fronteira de caminho:
/repocobre/repo/apie nunca/repo-other. - Um handoff manual ganha do automático. Aceitar expira os candidatos automáticos mais antigos na mesma transação.
- Num servidor compartilhado, um handoff pertence ao dono dele, a menos que seja enviado com
shared=true.
A regra do writer único, medida
Todas as escritas passam por uma fila limitada a 1024 até uma única thread do sistema operacional. As leituras usam um pool separado, só de leitura. Um pico desacelera os produtores, e nenhuma escrita é descartada.
- 1 writer42/s23,9 ms
- 8 writers295/s3,4 ms
- 32 writers698/s1,43 ms
- 128 writers700/s1,43 ms
- O teto fica em torno de 700 escritas por segundo, estável de 32 writers para cima. Com um writer só, o gargalo é o fsync, não a CPU.
- Medido num disco local rápido. Um volume de rede ou lento vai dar bem menos.
- O teste exercita o store direto e pula a porta de entrada HTTP.
- Reproduza com
cargo test -p ai-memory-store --test writer_throughput -- --ignored --nocapture.
Páginas de sessão antigas recebem uma pontuação, e as frias são descartadas, compactadas ou mescladas. Como a memória envelhece.
O código, crate por crate.
Nove crates, cada um com uma função só e uma API tipada, sem dependências circulares.
| Crate | Responsabilidade |
|---|---|
ai-memory-core | Tipos de domínio, erros, ids. Sem IO. |
ai-memory-store | SQLite, o actor de escrita, o pool de leitura, a matemática do decaimento. |
ai-memory-wiki | Escritas atômicas de markdown, o file watcher, git. |
ai-memory-mcp | Transporte MCP e router de ferramentas. |
ai-memory-hooks | Schemas de payload, o sanitizador, a entrada por /hook. |
ai-memory-llm | Fronteira de autenticação dos provedores, traits de LLM e de embedder. |
ai-memory-consolidate | Ingestão, lint, sweep e o pipeline de auto-improve. |
ai-memory-workstream | Adapters somente leitura para transcrições nativas e execuções gerenciadas. |
ai-memory-cli | O binário ai-memory e seus subcomandos HTTP enxutos. |
23 ferramentas MCP, poucas de propósito
Os hooks fazem a captura de rotina, então os agentes raramente precisam chamar isso na mão.
Recuperação (7)
memory_querymemory_recentmemory_read_pagememory_read_session_observationsmemory_briefingmemory_explorememory_status
Handoffs (4)
memory_handoff_beginmemory_handoff_listmemory_handoff_acceptmemory_handoff_cancel
Mensagens entre projetos (4)
memory_message_sendmemory_message_listmemory_message_popmemory_message_cancel
Escrita e manutenção (8)
memory_write_pagememory_delete_pagememory_consolidatememory_auto_improvememory_feedbackmemory_lintmemory_forget_sweepmemory_install_self_routing
ARCHITECTURE.md, com todas as 15 invariantesDecisões de design e opções rejeitadas
Perguntas e respostas
Onde o ai-memory guarda os dados?
Num único diretório de dados: um repositório git de páginas markdown em wiki/, um índice SQLite derivado em db/, segmentos sanitizados de workstream em raw/, o modelo local de embeddings em models/ e os logs.
O ai-memory precisa de um LLM?
Não. Captura, resumos de sessão, handoffs, indexação, busca e o briefing rodam sem nenhum provedor configurado. Consolidação por LLM, auto-improve e rerank são opt-in.
O que acontece se o índice SQLite for perdido ou corrompido?
Os arquivos markdown são a fonte da verdade. O ai-memory reindex reconstrói o índice de páginas a partir deles. Não existe transação que cubra o filesystem e o SQLite ao mesmo tempo, e o reindex também é o jeito de resolver as janelas de crash.
Como a recuperação ranqueia os resultados?
Quatro fluxos de candidatos (full-text com FTS5, match de entidades, vizinhos no grafo e vetores opcionais) são fundidos com Reciprocal Rank Fusion em k=60 e depois ajustados por um multiplicador limitado de autoridade da fonte. O rerank por LLM é opcional, e as observações brutas servem de fallback.
Quantas escritas por segundo ele aguenta?
O store mede 42 escritas por segundo com um writer, 295 com 8 e um teto perto de 700 de 32 writers para cima. Os números vêm de um disco local rápido, e o teste exercita o store direto, sem a porta de entrada HTTP.
Leia os arquivos que ele escreve.
Instale, rode uma sessão e depois abra a pasta da wiki no seu editor.