
Producto
Un solo binario, archivos markdown y un índice derivado
Los hooks capturan lo que hace tu agente. El markdown en git guarda lo aprendido. SQLite es un índice de búsqueda que puedes tirar y reconstruir. Esta página recorre el camino desde un hook hasta el resumen de la siguiente sesión, y dice dónde el diseño todavía flojea.
Un solo binario, un directorio de datos.
SQLite va incluido, libgit2 va vendorizado y el embedder es Rust puro. No hay sidecar, ni servidor de base de datos, ni cola que mantener. Todo lo que sabe está en una carpeta.
<data_dir>/
wiki/Páginas markdown con frontmatter YAML, en un repositorio git. La fuente de verdad.db/memory.sqliteEl índice derivado: texto completo, entidades, enlaces, embeddings, sesiones, auditoría. Modo WAL.raw/Segmentos JSONL inmutables y saneados de las sesiones gestionadas con ai-memory run.models/El modelo local de embeddings, all-MiniLM-L6-v2, de unos 87 MB y con SHA-256 fijado.logs/Logs con rotación diaria.config.tomlSe lee una vez al arrancar. Cada valor se puede sobrescribir con una variable AI_MEMORY_*.El servidor escucha en 127.0.0.1:49374 por defecto. Hacer una copia de seguridad es ejecutar ai-memory backup, o un git push de la wiki más un rsync de la carpeta.
De un hook al siguiente resumen.
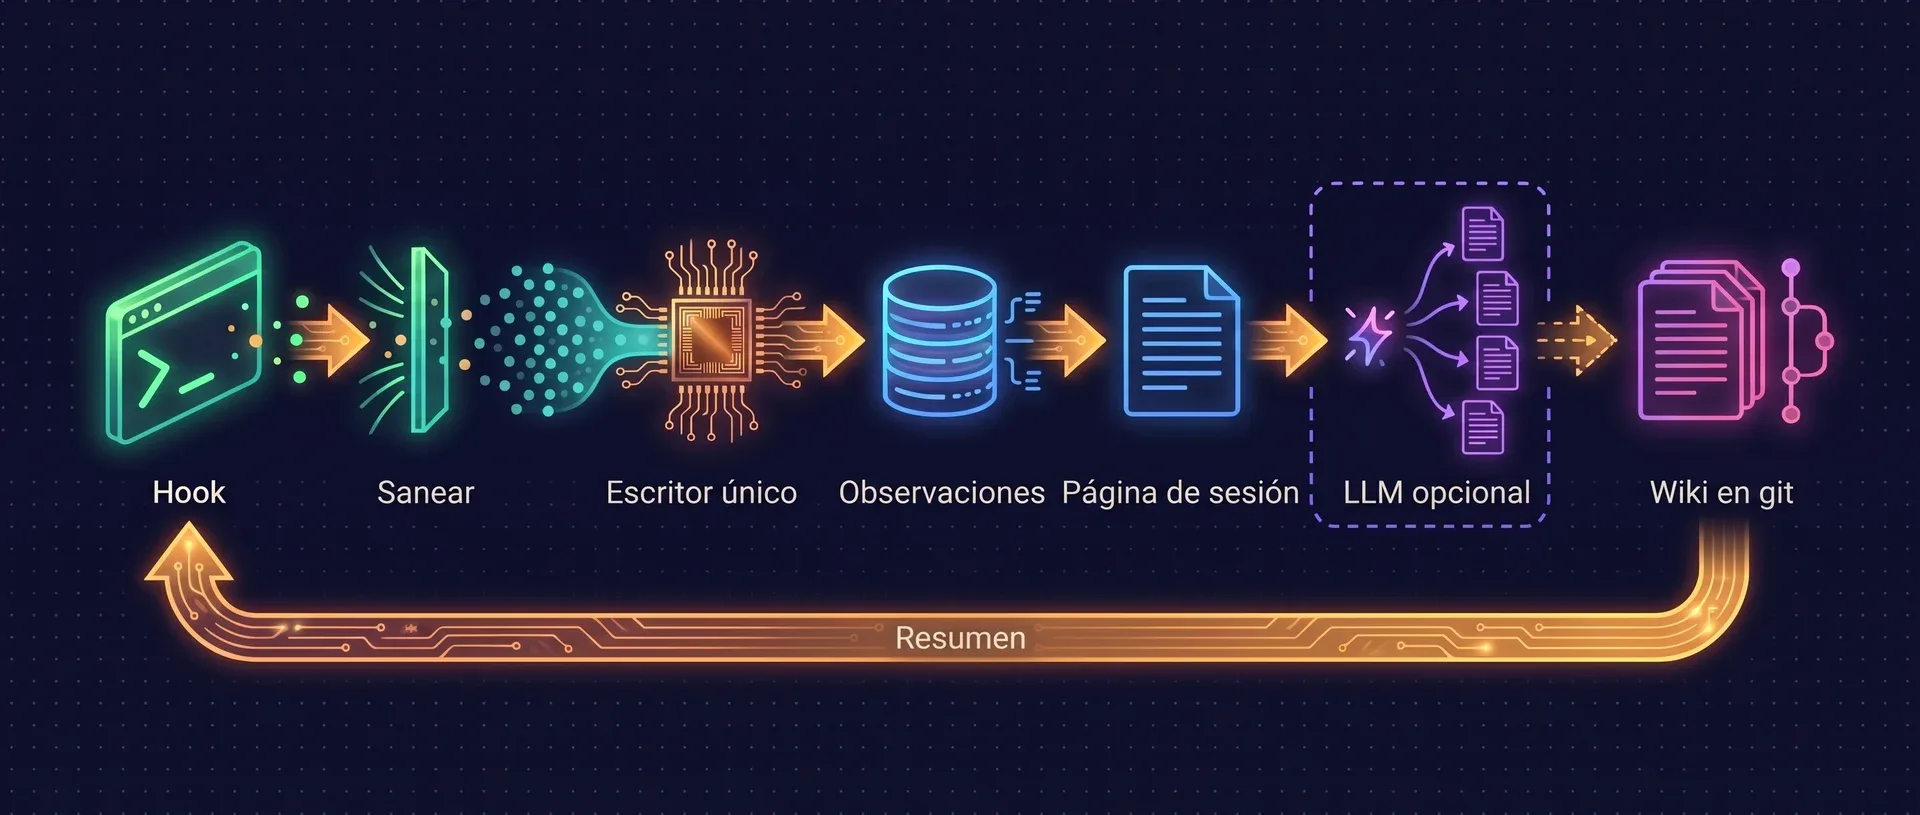
Siete de estos ocho pasos corren sin modelo y sin clave de API. El paso con LLM está apagado hasta que configuras un proveedor.
HookCero LLM
La CLI del agente dispara un hook de ciclo de vida. Es fire and forget con un presupuesto de 200 ms: los hooks nativos guardan el evento en una cola local y un helper independiente lo entrega. El servidor responde 202, o 429 si está saturado.
SaneadoCero LLM
El router de /hook elimina los secretos y limita los tamaños. Es el único camino del texto no confiable hacia el store.
Escritor únicoCero LLM
El evento saneado entra en una sola cola, que vacía un solo hilo, dueño de la única conexión de escritura.
ObservacionesCero LLM
Los eventos caen en SQLite como un rastro de auditoría operativo. Es una proyección acotada de la sesión, nunca una transcripción completa.
Fin de sesiónCero LLM
Unas reglas, sin modelo, convierten las observaciones en sessions/<id>.md y abren una fila Handoff para el siguiente agente, en una sola transacción.
ConsolidaciónLLM opcional
Con un proveedor configurado, un LLM reescribe el resumen o lo reparte en concepts/, decisions/, gotchas/ y procedures/. Corre desde una cola con reintentos, fuera de la latencia de los hooks.
Commit e índiceCero LLM
Cada escritura de página es atómica (tmp, rename, fsync), se commitea en git y se indexa en la misma transacción de SQLite que su fila.
Consulta y resumenCero LLM
memory_query busca en el índice. En el siguiente SessionStart, el hook trae el traspaso abierto y un resumen estructurado para ese directorio.
Dos capas, una fuente de verdad.
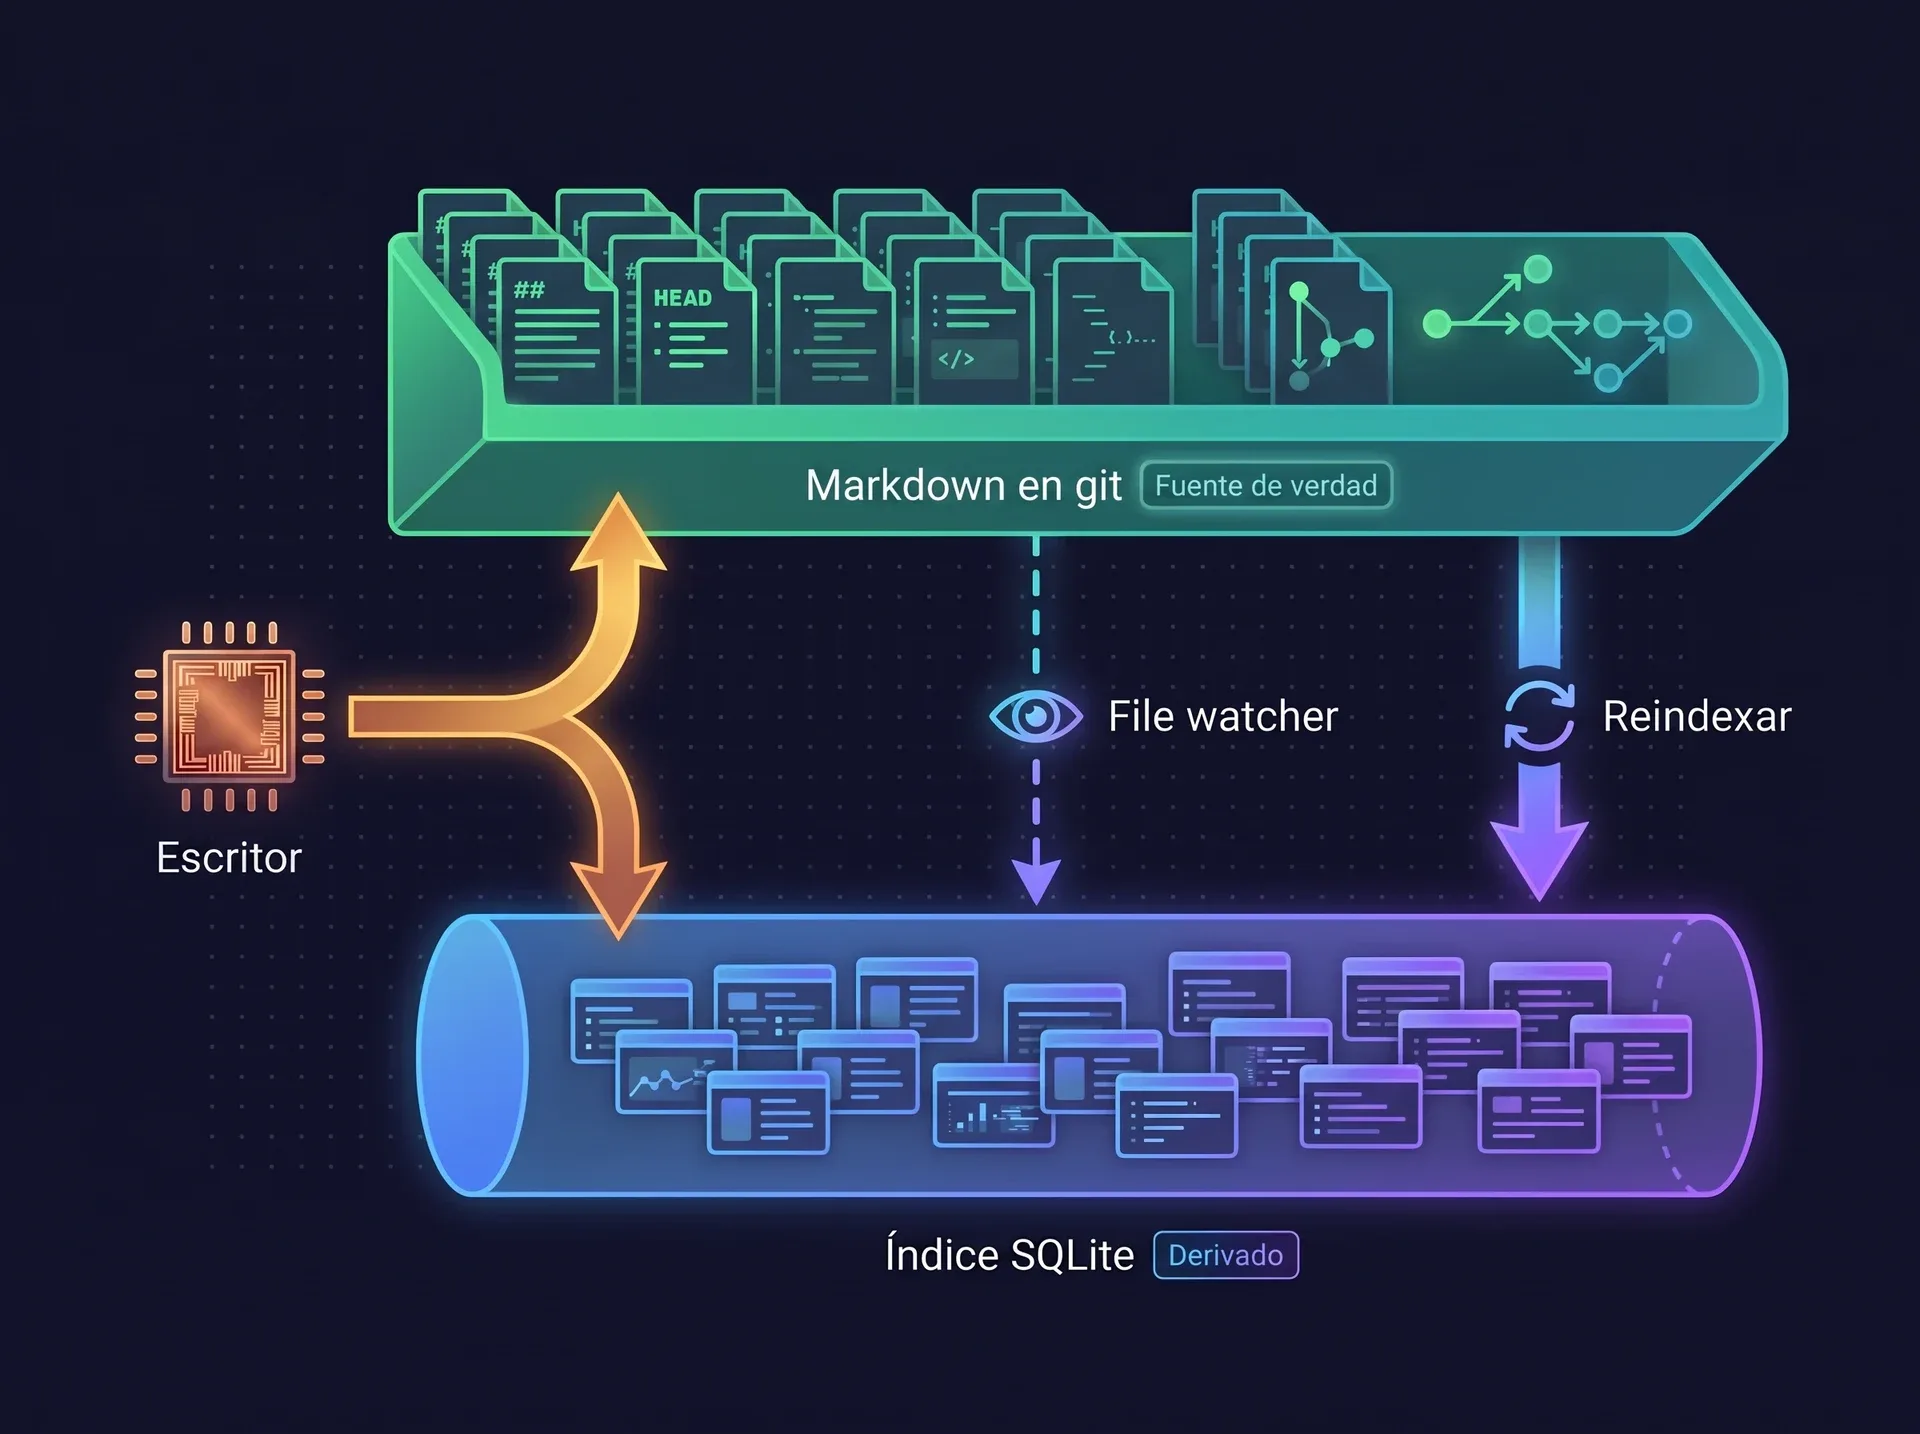
Si los archivos y el índice no coinciden, ganan los archivos.
Los archivos son la verdad
Las páginas son markdown con frontmatter YAML bajo wiki/
/ /. Ábrelas en Obsidian, pásales grep, súbelas a un remoto. SQLite es derivado
Todo lo que hay en memory.sqlite que describe una página se puede reconstruir desde los archivos con ai-memory reindex. Un índice corrupto se recupera.
Las escrituras son del servidor
Las escrituras normales pasan por la capa de la wiki, que actualiza juntos el archivo, el historial de git y el índice.
Un watcher recoge el resto
Un file watcher detecta las ediciones hechas desde vim u Obsidian. Un diff completo cada 30 segundos recoge los eventos que se le escaparon.
Recuperación: cuatro flujos, un ranking.
Texto completo
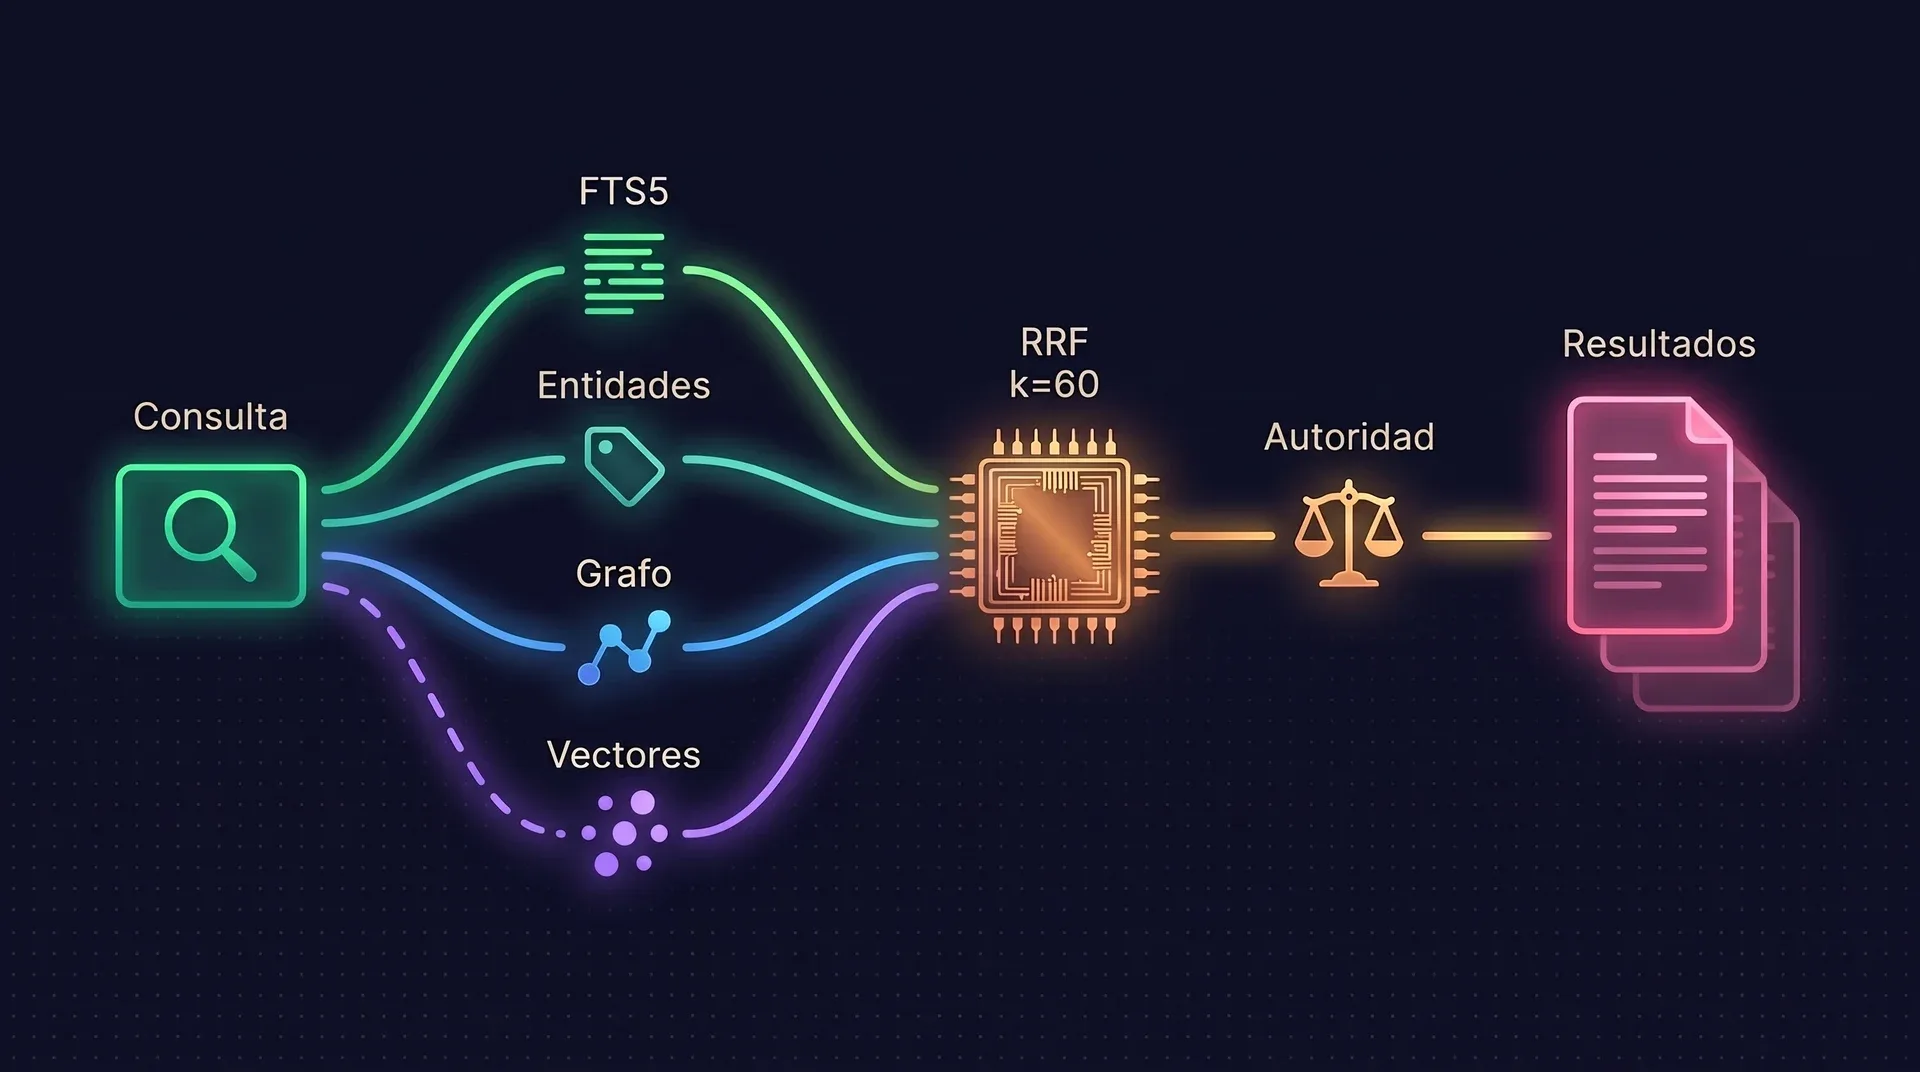
SQLite FTS5 sobre los títulos y los cuerpos de las páginas, con las stopwords filtradas en las consultas sin operadores.
Coincidencia de entidades
Un índice léxico de nombres sacados de las entidades y los tags del frontmatter, ponderado por frecuencia inversa de página.
Vecinos en el grafo
Un salto sobre la tabla de enlaces: wikilinks, enlaces markdown, aristas tipadas y enlaces entre proyectos. SQL plano, sin base de datos de grafos.
Vectores, opcionales
Similitud coseno sobre embeddings del modelo local que corre dentro del proceso. Activados por defecto desde la 2.0, nunca obligatorios, y por fuerza bruta a propósito.
Después de la fusión
- Reciprocal Rank Fusion con k=60 fusiona los flujos por posición, así que ningún flujo necesita calibrar sus puntuaciones.
- Después, un multiplicador de autoridad acotado inclina los empates ajustados hacia reglas, decisiones, procedimientos y gotchas que se mantienen al día. Las páginas episódicas e históricas siguen apareciendo en las búsquedas, y nada se excluye del todo.
- Rerank opcional con LLM: una llamada por consulta sobre hasta 30 títulos y fragmentos. Ante cualquier fallo se conserva el orden local. Todavía no hay un reranker local, y es la carencia más citada del proyecto.
- Si las páginas compiladas no dan ningún resultado, una búsqueda acotada sobre las observaciones en bruto devuelve raw_hits.
- Pasa explain=true para ver las posiciones por flujo, las contribuciones de RRF y el multiplicador de cada resultado.
Tiempo: as_of
- Pasa una fecha ISO para preguntar qué decía la wiki sobre algo en ese momento.
- Solo registra el tiempo de ingesta: cuándo ai-memory aprendió un dato y cuándo lo reemplazó, nunca cuándo fue cierto en el mundo.
- No reproduce el ranking que habría devuelto una búsqueda en esa fecha.
Aristas tipadas
- El campo
relations:del frontmatter acepta un conjunto cerrado:causes,fixes,contradicts. Una errata no puede crear un tipo nuevo. contradictsalimenta el lint sin LLM y se reporta hasta que alguien lo reconcilia.- En la búsqueda solo sirven para explain: entran en el grafo como enlaces normales y no mueven el ranking, porque el benchmark no dio base para asignarles un peso.
memory_read_pagepuede recorrerlas para listar páginas relacionadas.
Un solo receptor, un solo escritor.
Dos reglas sostienen casi toda la corrección: un traspaso se puede reclamar una sola vez, y solo un hilo escribe en SQLite.
Los traspasos son un protocolo
- Un traspaso es un registro tipado: agente de origen y de destino, proyecto, cwd, resumen, preguntas abiertas, archivos tocados, siguientes pasos.
- Aceptar es un compare and set atómico. Un segundo agente que pregunte no recibe nada.
- El cwd coincide por límites de ruta:
/repocubre/repo/apiy nunca/repo-other. - Un traspaso manual gana al automático. Aceptarlo expira los candidatos automáticos más antiguos en la misma transacción.
- En un servidor compartido, un traspaso pertenece a su dueño salvo que se envíe con
shared=true.
La regla del escritor único, medida
Todas las escrituras pasan por una cola acotada de 1024 hacia un solo hilo del sistema operativo. Las lecturas usan un pool aparte, de solo lectura. Una ráfaga frena a sus productores, y no se pierde ninguna escritura.
- 1 escritor42/s23,9 ms
- 8 escritores295/s3,4 ms
- 32 escritores698/s1,43 ms
- 128 escritores700/s1,43 ms
- El techo ronda las 700 escrituras por segundo, plano de 32 escritores en adelante. A un solo escritor lo limita fsync, no la CPU.
- Medido en un disco local rápido. Un volumen en red o lento dará cifras bastante más bajas.
- El test ataca el store directamente y se salta la entrada HTTP.
- Reprodúcelo con
cargo test -p ai-memory-store --test writer_throughput -- --ignored --nocapture.
Las páginas de sesión viejas se puntúan, y las frías se desalojan, se compactan o se fusionan. Cómo envejece la memoria.
El código, crate por crate.
Nueve crates, cada uno con una sola tarea y una API tipada, sin dependencias circulares.
| Crate | Responsabilidad |
|---|---|
ai-memory-core | Tipos de dominio, errores, ids. Sin IO. |
ai-memory-store | SQLite, el actor escritor, el pool de lectores, el cálculo del decaimiento. |
ai-memory-wiki | Escrituras atómicas de markdown, el file watcher, git. |
ai-memory-mcp | Transporte MCP y router de herramientas. |
ai-memory-hooks | Esquemas de payload, el sanitizer, la entrada de /hook. |
ai-memory-llm | Frontera de autenticación con proveedores, traits de LLM y de embedder. |
ai-memory-consolidate | Ingesta, lint, sweep y el pipeline de auto-improve. |
ai-memory-workstream | Adaptadores de solo lectura para transcripciones nativas y lanzamientos. |
ai-memory-cli | El binario ai-memory y sus subcomandos HTTP, que son finos. |
23 herramientas MCP, pocas a propósito
Los hooks hacen la captura rutinaria, así que los agentes rara vez tienen que llamarlas a mano.
Recuperación (7)
memory_querymemory_recentmemory_read_pagememory_read_session_observationsmemory_briefingmemory_explorememory_status
Traspasos (4)
memory_handoff_beginmemory_handoff_listmemory_handoff_acceptmemory_handoff_cancel
Mensajes entre proyectos (4)
memory_message_sendmemory_message_listmemory_message_popmemory_message_cancel
Escritura y mantenimiento (8)
memory_write_pagememory_delete_pagememory_consolidatememory_auto_improvememory_feedbackmemory_lintmemory_forget_sweepmemory_install_self_routing
ARCHITECTURE.md, con los 15 invariantesDecisiones de diseño y opciones descartadas
Preguntas y respuestas
¿Dónde guarda ai-memory sus datos?
En un solo directorio de datos: un repositorio git de páginas markdown en wiki/, un índice SQLite derivado en db/, segmentos saneados del workstream en raw/, el modelo local de embeddings en models/, y los logs.
¿ai-memory necesita un LLM?
No. La captura, los resúmenes de sesión, los traspasos, la indexación, la búsqueda y el resumen inicial funcionan sin ningún proveedor configurado. La consolidación con LLM, la mejora automática y el rerank son opt-in.
¿Qué pasa si el índice SQLite se pierde o se corrompe?
Los archivos markdown son la fuente de verdad. ai-memory reindex reconstruye el índice de páginas a partir de ellos. No hay una transacción que abarque el sistema de archivos y SQLite, y reindex también es la forma de resolver las ventanas que deja una caída.
¿Cómo ordena los resultados la recuperación?
Cuatro flujos de candidatos (texto completo con FTS5, coincidencia de entidades, vecinos en el grafo y vectores opcionales) se fusionan con Reciprocal Rank Fusion con k=60, y después se ajustan con un multiplicador acotado de autoridad de la fuente. El rerank con LLM es opcional, y las observaciones en bruto sirven de respaldo.
¿Cuántas escrituras por segundo aguanta?
El store mide 42 escrituras por segundo con un escritor, 295 con 8, y un techo cercano a 700 de 32 escritores en adelante. Las cifras salen de un disco local rápido, y el test ataca el store directamente, sin la entrada HTTP.
Sigue leyendo
Lee los archivos que escribe.
Instálalo, ejecuta una sesión y abre la carpeta de la wiki en tu editor.