
개발자
고급 설정과 인프라
서버가 노트북을 벗어날 때 필요한 내용입니다. 주제마다 다이어그램이나 표, 가장 짧은 올바른 설정, GitHub의 전체 문서 링크를 담았습니다.
실행할 수 있는 네 가지 위치
바이너리는 네 경우 모두 같습니다. 달라지는 것은 바인드 주소이고, 그에 따라 갖춰야 할 인증과 암호화 수준이 정해집니다.
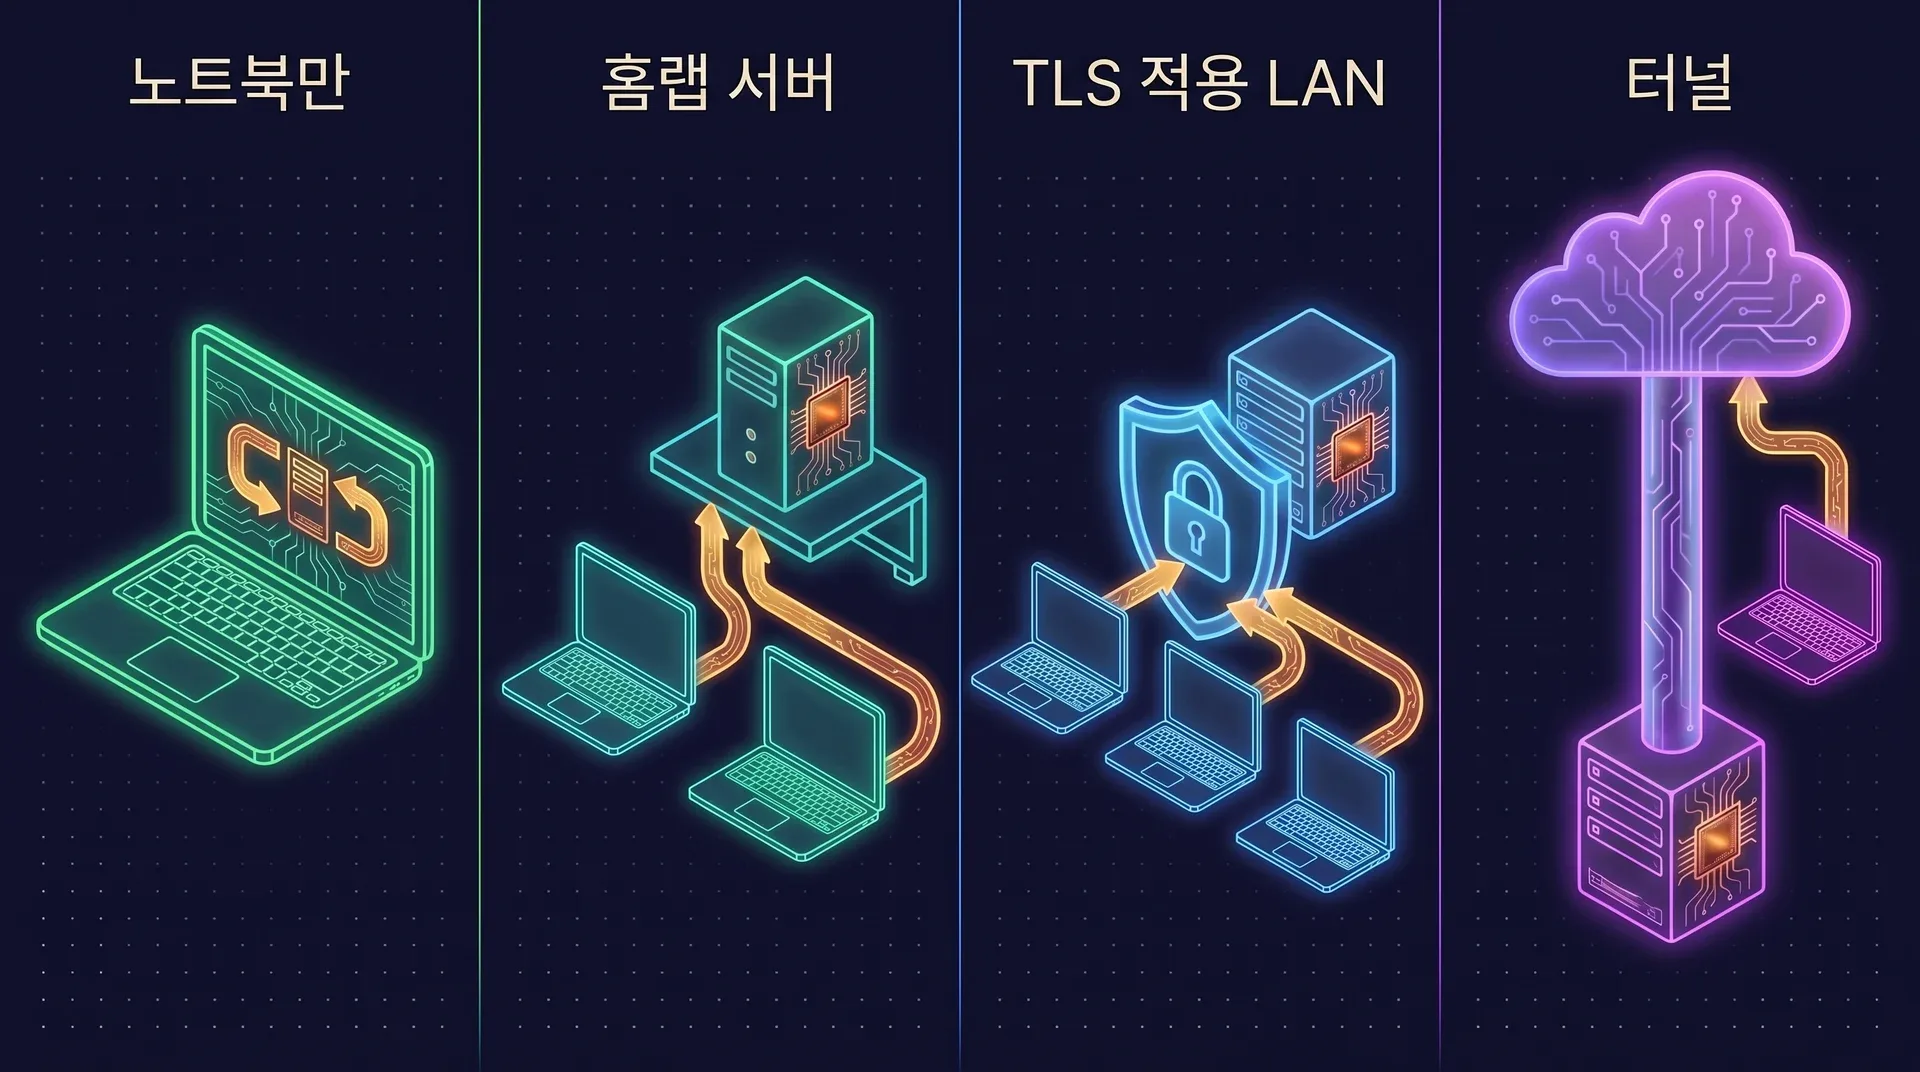
| 토폴로지 | 바인드 | 인증 | TLS | 실행 방식 |
|---|---|---|---|---|
| 노트북만 | 127.0.0.1:49374 | 필요 없음 | 아니요 | systemd 사용자 유닛, launchd 에이전트 또는 컨테이너 |
| 홈랩 서버 | 0.0.0.0:49374 | Bearer 토큰과 호스트 허용 목록, 둘 다 필수 | 권장 | healthcheck를 갖춘 Docker 또는 AUR 시스템 서비스 |
| TLS 적용 LAN | 프록시 뒤의 0.0.0.0:49374 | 루트 토큰, 그리고 사람마다 사용자 계정과 API 키 | 예. Caddy의 내부 CA는 도메인 없이도 동작합니다 | Caddy 사이드카를 둔 Docker Compose |
| 터널 | 호스트 포트 없음 | LAN 서버와 동일 | 예, Cloudflare 엣지에서 처리 | cloudflared 사이드카를 둔 Docker Compose |
노트북에서는 ai-memory serve --transport stdio로 HTTP를 아예 건너뛸 수 있습니다. 홈랩용으로는 저장소에 compose와 env 템플릿이 포함된 bin/deploy 스크립트가 있습니다. 홈랩 배포 안내서 따라 하기.
리버스 프록시를 통한 TLS
ai-memory는 의도적으로 TLS를 직접 종단하지 않습니다. Bearer 토큰은 요청을 인증할 뿐 암호화하지는 않습니다.
TLS를 생략해도 되는 경우
- 에이전트가 stdio로 통신할 때
- 서버가 루프백 전용이고 사용자가 한 명이며, 다른 컴퓨터에서
/web을 열지 않을 때 - 로컬 개발이거나 일회성 실험일 때
TLS가 필요한 경우
- 계정이 있을 때.
aim_키가 네트워크를 지나가기 때문입니다 - 서버를 루프백 밖으로 바인드했을 때
- 다른 컴퓨터에서
/web을 열 때 - LAN 밖에서 서버에 접근할 수 있을 때
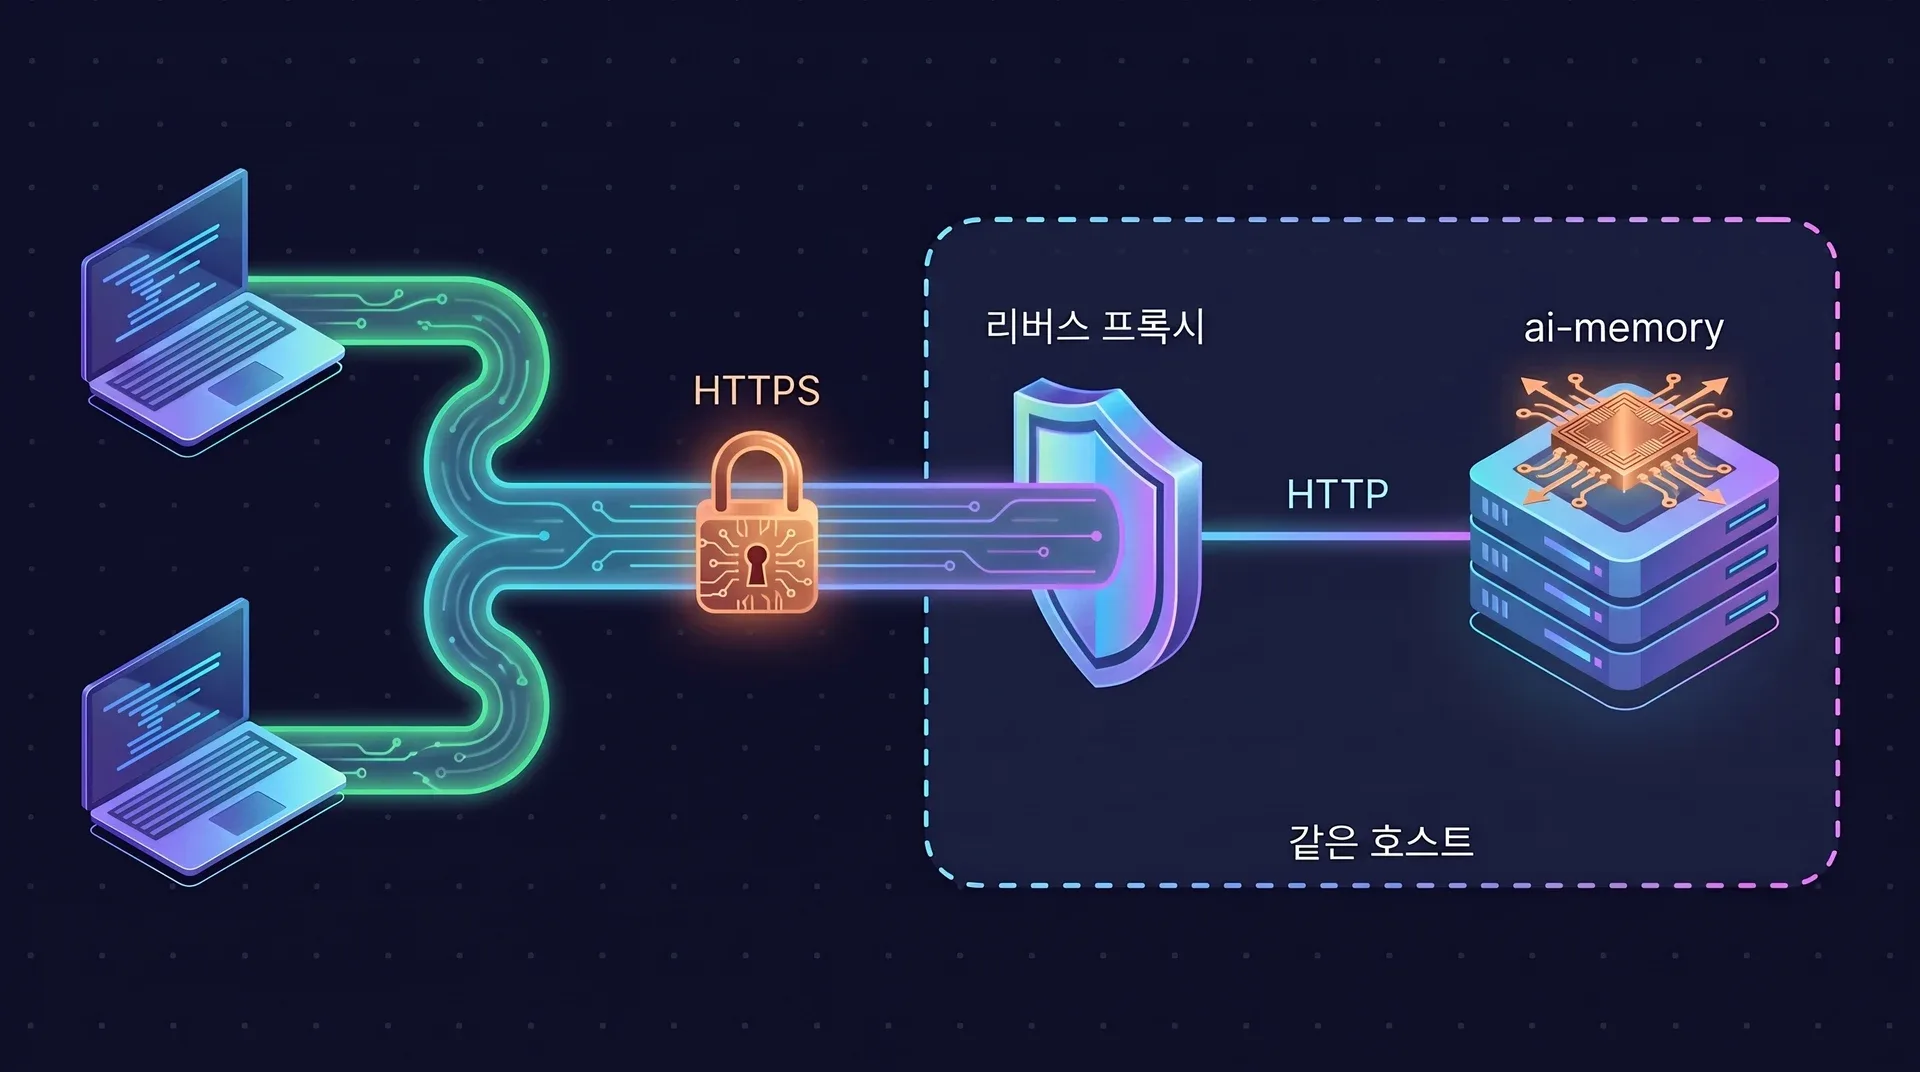
80과 443 포트에 접근할 수 있는 공개 도메인용입니다. Caddy가 Let's Encrypt 인증서를 알아서 발급하고 갱신합니다. 전체 compose 파일은 저장소의 docker/compose.tls.caddy.yml입니다.
memory.example.com {
    reverse_proxy ai-memory:49374
}
도메인도 없고 외부 노출도 없는 구성입니다. Caddy의 내부 CA가 인증서에 서명하며, 그 루트 인증서를 모든 클라이언트 컴퓨터에 한 번씩 설치합니다. 이 단계를 건너뛰면 클라이언트가 연결을 거부하거나, 사람들이 경고를 무시하고 넘기는 습관을 들이게 됩니다.
{
    local_certs   # LE 대신 내부 CA를 쓰도록 Caddy에 지시
}

homelab.local, 192.168.1.50 {
    reverse_proxy ai-memory:49374
}
docker compose exec caddy cat /data/caddy/pki/authorities/local/root.crt > caddy-root.crt
이미 nginx를 운영 중이고 인증서 파일이 있을 때 씁니다. MCP의 streamable HTTP 전송에는 HTTP/1.1과 빈 Connection 헤더가 필요합니다.
server {
    listen 443 ssl http2;
    server_name memory.example.com;

    ssl_certificate     /etc/nginx/certs/memory.crt;
    ssl_certificate_key /etc/nginx/certs/memory.key;

    location / {
        proxy_pass http://ai-memory:49374;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
아웃바운드 전용 터널이라 라우터 포트를 열 필요가 없습니다. Cloudflare에 등록된 도메인이 필요하며 무료 플랜으로 충분합니다. 대시보드에서 공개 호스트 이름이 http://ai-memory:49374를 가리키게 하세요. 전체 compose 파일은 docker/compose.tls.cloudflared.yml입니다.
cloudflared:
    image: cloudflare/cloudflared:latest
    container_name: ai-memory-tunnel
    restart: unless-stopped
    command: tunnel --no-autoupdate run
    environment:
      - TUNNEL_TOKEN=${CLOUDFLARE_TUNNEL_TOKEN}
다음으로 서버에 알립니다
허용 목록에 공개 호스트 이름이 들어 있어야 합니다. 없으면 DNS 리바인딩 방어가 프록시의 요청을 거부합니다. 루프백 밖의 리스너로 사람들이 로그인한다면 secure 쿠키 설정도 필수입니다.
AI_MEMORY_AUTH_TOKEN=...long-random-token-from-generate-auth-token...
AI_MEMORY_AUTH__SECURE_COOKIE=true
AI_MEMORY_ALLOWED_HOSTS=memory.example.com,localhost,127.0.0.1
AI_MEMORY_BIND=0.0.0.0:49374
그리고 클라이언트 주소를 바꿉니다
MCP URL은 /mcp로 끝납니다. 훅 URL은 경로 없는 origin입니다.
ai-memory install-mcp   --client claude-code --apply \
    --server-url "https://memory.example.com/mcp" --auth-token "$AI_MEMORY_AUTH_TOKEN"
ai-memory install-hooks --agent  claude-code --apply \
    --server-url "https://memory.example.com" --auth-token "$AI_MEMORY_AUTH_TOKEN"
서버를 계속 실행하기
ai-memory는 스스로 재시작하지 않습니다. 그 일은 각 운영체제의 서비스 관리자가 맡습니다.
1인용 워크스테이션에 맞습니다. AUR 패키지가 유닛을 설치합니다. sudo가 필요 없고 상태는 ~/.local/share/ai-memory에 둡니다. lingering을 켜지 않으면 사용자 유닛은 로그아웃할 때 멈춥니다.
systemctl --user daemon-reload
systemctl --user enable --now ai-memory.service
systemctl --user status ai-memory.service
journalctl --user -u ai-memory.service -f

# 로그아웃한 뒤에도 계속 실행
loginctl enable-linger "$USER"
공용 워크스테이션이나 LAN 서버에 맞습니다. 데이터는 /var/lib/ai-memory, 설정은 /etc/ai-memory/config.toml, 시크릿은 /etc/ai-memory/env에 둡니다. 두 유닛을 같은 바인드 주소로 동시에 실행하지 마세요.
sudo systemd-sysusers /usr/lib/sysusers.d/ai-memory.conf
sudo systemd-tmpfiles --create /usr/lib/tmpfiles.d/ai-memory.conf
sudo -u ai-memory ai-memory \
  --data-dir /var/lib/ai-memory \
  --config /etc/ai-memory/config.toml \
  init

sudo systemctl daemon-reload
sudo systemctl enable --now ai-memory.service
journalctl -u ai-memory.service -f
macOS tarball에는 플레이스홀더 두 개가 들어 있는 LaunchAgent plist가 포함됩니다. 압축을 푼 tarball 안에서 아래 명령을 실행하세요. LaunchAgent는 로그아웃할 때 멈추고, macOS에는 lingering에 해당하는 기능이 없습니다. 로그 파일 두 개는 아무도 로테이션하지 않습니다.
mkdir -p ~/Library/Logs/ai-memory
AI_MEMORY_BIN=~/Applications/ai-memory/ai-memory

sed -e "s|__AI_MEMORY_BIN__|$AI_MEMORY_BIN|" \
    -e "s|__HOME__|$HOME|" \
    packaging/launchd/com.github.akitaonrails.ai-memory.plist \
    > ~/Library/LaunchAgents/com.github.akitaonrails.ai-memory.plist

launchctl bootstrap gui/$(id -u) \
    ~/Library/LaunchAgents/com.github.akitaonrails.ai-memory.plist
ai-memory에는 Windows 서비스 디스패처가 없습니다. 그래서 exe를 가리키는 sc create는 동작하지 않고, Start-Process를 쓰는 예약 작업은 다음 재부팅 때 죽습니다. WinSW로 감싸면 됩니다. 절대 경로를 쓰세요. 서비스는 LocalSystem으로 실행되므로 %LOCALAPPDATA%가 엉뚱한 프로필로 확장됩니다.
<service>
  <id>ai-memory</id>
  <name>ai-memory MCP server</name>
  <description>Long-term memory server for AI coding agents.</description>
  <executable>C:\Users\you\AppData\Local\ai-memory\ai-memory.exe</executable>
  <arguments>--data-dir "C:\Users\you\AppData\Local\ai-memory" serve --transport http --bind 127.0.0.1:49374</arguments>
  <startmode>Automatic</startmode>
  <onfailure action="restart" delay="5 sec"/>
  <log mode="roll"/>
</service>
& "$Dest\ai-memory-service.exe" install
& "$Dest\ai-memory-service.exe" start
& "$Dest\ai-memory-service.exe" status
데이터 디렉터리와 백업
위키가 원본입니다. git 저장소에 담긴 일반 markdown이고, 검색 인덱스는 거기서 만들어집니다.
reindex는 위키에서 페이지, 링크, 전문 검색을 다시 만듭니다. 세션, 관찰 기록, 인수인계, 사용자, 키, 감사 행, 임베딩은 되살리지 못하므로 데이터베이스도 백업에 포함해야 합니다.
| 디렉터리 | 내용 | 성격 | 백업 여부 |
|---|---|---|---|
wiki/ | 모든 페이지가 markdown으로, 하나의 git 저장소에 | 원본 | 예. 백업 tarball에 들어 있고, rsync하거나 git push해도 됩니다 |
raw/ | 관리형 실행에서 나온, 변경 불가능하고 정제된 트랜스크립트 세그먼트 | 원본 | ai-memory run을 쓴다면 예. 별도로 복사하세요 |
db/ | memory.sqlite: 전문 검색 인덱스, 엔티티, 임베딩, 세션, 사용자, 감사 행 | 대부분 파생 | 예. 페이지, 링크, 검색은 위키에서 다시 만들 수 있습니다. 세션, 인수인계, 사용자, 키는 여기에만 있습니다 |
models/ | 로컬 임베딩 모델, 약 87 MB | 재생성 가능 | 아니요. 다시 다운로드되며, 파일을 직접 넣어도 됩니다 |
logs/ | 롤링되는 trace 출력 | 버려도 됨 | 아니요 |
기본값: Linux는 ~/.local/share/ai-memory, macOS는 ~/Library/Application Support/ai-memory, Windows는 %LOCALAPPDATA%\ai-memory, 컨테이너는 /data입니다. AI_MEMORY_DATA_DIR로 바꿀 수 있습니다.
백업과 복원
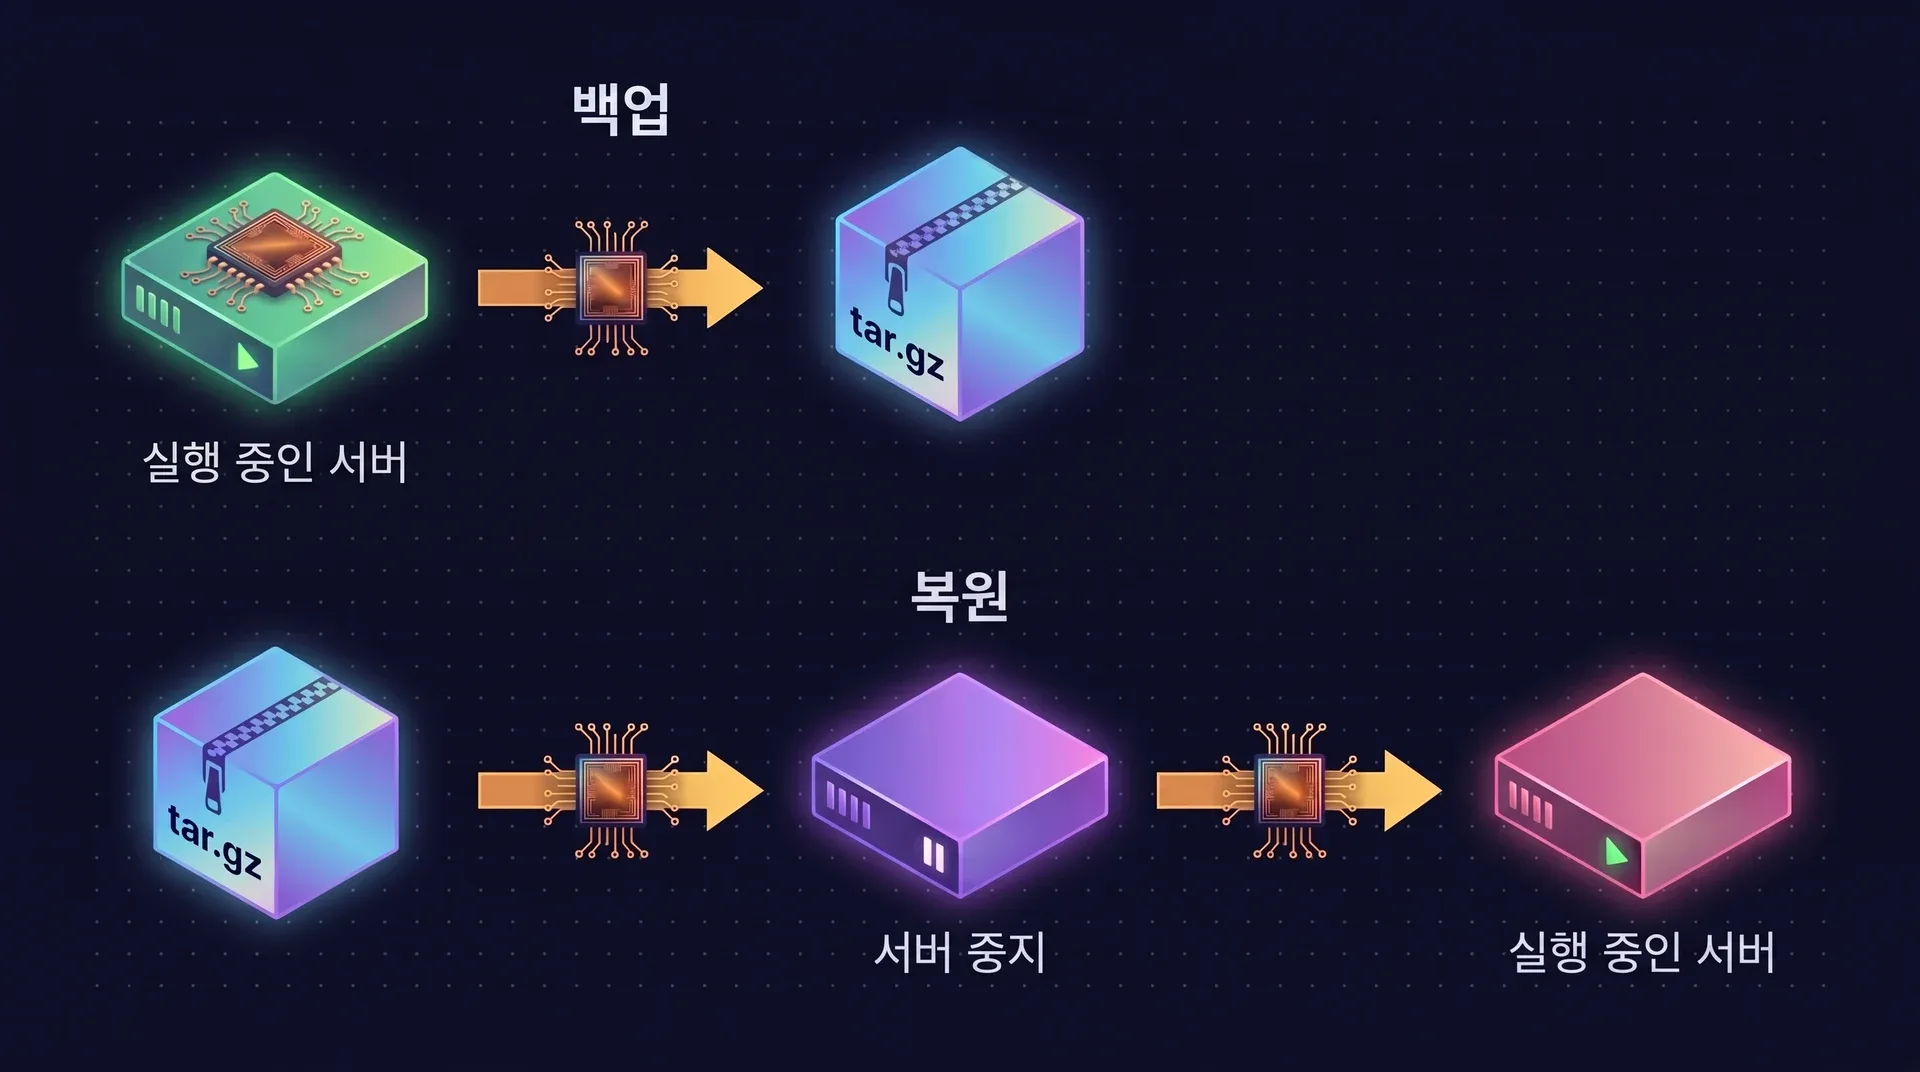
백업
SQLite의 온라인 백업 API를 쓰므로 스냅숏 도중에 쓰기가 들어와도 일관성이 유지됩니다. tarball에는 위키 트리, 데이터베이스 스냅숏, config.toml이 들어갑니다.
# 서버 실행 중에도 안전
ai-memory backup --to /tmp/ai-memory-backup.tar.gz
복원
--data-dir은 볼륨의 호스트 쪽 경로입니다. 여기 적힌 경로는 배포 가이드의 예시입니다. 본인 환경의 경로로 바꾸세요.
# 먼저 서버를 중지합니다.
docker compose -f ~/deploy/ai-memory/docker-compose.yml down
# 복원합니다(컨테이너가 아직 실행 중이면 sysinfo가 거부합니다).
ai-memory restore --from /tmp/ai-memory-backup.tar.gz --data-dir /var/opt/docker/utils/ai-memory/data --force
# 다시 시작합니다.
docker compose -f ~/deploy/ai-memory/docker-compose.yml up -d
라우팅과 신원
공유 서버는 두 가지 질문에 답해야 합니다. 이 세션은 어느 프로젝트에 속하는가, 그리고 요청하는 사람은 누구인가.
마커 파일
기본적으로 프로젝트는 현재 디렉터리 이름이고, default라는 워크스페이스에 들어갑니다. 이를 바꾸려면 상위 디렉터리 어디에든 .ai-memory.toml을 두세요. 훅은 작업 디렉터리에서 위로 올라가며 처음 만나는 마커를 사용합니다.
업무용과 개인용
상위 디렉터리마다 마커를 하나씩 둡니다. 그 아래 모든 저장소가 해당 워크스페이스에 들어가고, 디렉터리 이름이 프로젝트가 됩니다.
# ~/projects/movvia/.ai-memory.toml
workspace = "movvia"

# ~/personal/.ai-memory.toml
workspace = "personal"
모노레포
project를 지정한 마커는 모든 하위 디렉터리를 그 프로젝트 하나로 고정합니다. 가장 가까운 마커가 우선합니다.
# ~/projects/movvia/pe-portais/.ai-memory.toml
workspace = "movvia"
project = "pe-portais"
Git worktree
연결된 worktree와 하위 디렉터리는 메인 저장소로 해석됩니다. worktree가 저장소 밖에 있어도 마찬가지입니다.
# ~/projects/.ai-memory.toml
workspace = "oss"
project_strategy = "repo-root"
같은 파일에 ignore_paths를 담은 [capture] 규칙도 들어갑니다. ai-memory install-hooks --apply --capture-mode allowlist를 쓰면 마커가 옵트인 역할을 해서, 마커 없는 저장소는 이벤트를 전혀 내보내지 않습니다. 네이티브 훅은 두 가지를 모두 강제합니다. Docker 래퍼의 셸 훅은 강제하지 않습니다. 마커 파일 레퍼런스 읽기.
auto-scope 모드
프로젝트를 명시하지 않은 MCP 호출은 "현재 프로젝트" 포인터로 해석됩니다. 그 포인터를 누구와 공유할지는 모드가 정합니다. 서버는 시작할 때 현재 모드를 로그에 남깁니다.
| 모드 | 쓰는 경우 |
|---|---|
per_actor | 기본값입니다. 한 서버에서 병렬로 도는 하네스와 서로 다른 사람을 격리합니다. |
per_session | 모든 MCP 요청에 훅 세션 id를 전달하는 세션 인식 클라이언트용입니다. |
single | v1.39 이전의 동작입니다. 프로세스 전체에 슬롯이 하나이고 마지막 쓰기가 이깁니다. 공유 서버에서는 안전하지 않습니다. |
[auto_scope]
mode = "per_actor"        # "per_actor"(v1.39부터 기본값) | "per_session" | "single"
session_ttl_secs = 3600   # 키별 항목의 TTL(기본 1시간)
max_entries = 4096        # 하드 상한. 가장 먼저 들어온 항목부터 제거
SSO와 OIDC
개발자마다 Keycloak, Okta, Entra ID 같은 표준 준수 issuer에 OIDC 디바이스 플로로 한 번 로그인합니다. 정적 Bearer 토큰이 설정되어 있지 않으면 이 토큰이 네이티브 라이프사이클 훅과 CLI 명령을 인증합니다.
ai-memory auth login oidc-device \
  --issuer "https://issuer.example.com/realms/team" \
  --client-id "ai-memory-cli"
오프라인, 한계, 업그레이드
보안 검토, 용량 계획, 점검 시간에 각각 알아야 할 내용입니다.
에어갭(망분리) 설치
바이너리
모든 릴리스 에셋에 .sha256 파일이 있습니다. 네트워크에 연결된 컴퓨터에서 받아 검증한 뒤 들고 들어가세요. 릴리스는 체크섬만 제공하며 SLSA provenance나 아티팩트 attestation은 없습니다.
소스 빌드
SQLite는 번들되어 있고 libgit2는 vendoring되어 있으므로, 빌드에는 C 툴체인과 crates 미러가 필요합니다. cargo vendor가 동작합니다.
임베딩 모델
기본 설치는 첫 시작 때 Hugging Face에서 모델을 받습니다. 아웃바운드 요청을 아예 없애려면 model.safetensors, tokenizer.json, config.json을 미리 <data_dir>/models/all-MiniLM-L6-v2/에 넣어 두세요. 체크섬은 소스에 고정되어 있습니다.
바이너리에는 텔레메트리가 없습니다. Docker 래퍼는 많아야 24시간에 한 번 Docker Hub에서 새 이미지를 확인하며, AI_MEMORY_NO_VERSION_CHECK=1로 끌 수 있습니다. 에어갭 환경에서는 업데이트도 설치와 같은 방식으로 수동입니다. 오프라인 설치 페이지 읽기.
용량
모든 쓰기는 라이터 하나를 거칩니다. 프로젝트는 그 한계를 cargo test -p ai-memory-store --test writer_throughput -- --ignored --nocapture로 측정했습니다.
| 동시 라이터 수 | 처리량 | 평균 지연 시간 |
|---|---|---|
| 1 | 42/s | 23.9 ms |
| 8 | 295/s | 3.4 ms |
| 32 | 698/s | 1.43 ms |
| 128 | 700/s | 1.43 ms |
- 상한은 초당 약 700건의 쓰기이며 라이터 32개 부근에서 도달합니다.
- 쓰기 큐는 1024로 제한됩니다. 이를 넘으면 생산자가 느려질 뿐 모든 쓰기는 그대로 반영됩니다.
- 셸 훅은 200 ms가 지나면 서버를 기다리지 않고 이벤트를 로컬에 스풀하므로, 서버가 느려도 에이전트가 멈추지 않습니다.
AI_MEMORY_HOOK_RATE_PER_SEC와AI_MEMORY_HOOK_RATE_BURST로 액터와 세션 단위의 속도 제한을 추가할 수 있습니다. 기본값은 꺼짐입니다.
업그레이드
ai-memory upgrade
- Docker 래퍼를 쓰면 이 명령이 래퍼를 검증하고 교체한 뒤 이미지를 pull하고 훅 스크립트를 다시 배치합니다. 다른 호스트의 서버는 따로 업그레이드합니다.
- 스키마와 위키 마이그레이션은 시작할 때 실행됩니다. 전진만 가능합니다. 이전 버전 바이너리는 마이그레이션된 디렉터리를 열지 않으므로, 롤백할 가능성이 있다면 먼저
ai-memory backup을 실행하세요.
자주 묻는 질문
ai-memory에 TLS가 필요한가요?
127.0.0.1에 바인드한 1인용 노트북이나 stdio 환경에서는 필요 없습니다. 계정이 있거나, 서버를 루프백 밖으로 바인드했거나, 다른 컴퓨터에서 웹 UI를 열거나, LAN 밖에서 접근할 수 있다면 TLS 프록시를 추가하세요. ai-memory는 TLS를 직접 종단하지 않습니다.
무엇을 백업해야 하나요?
ai-memory backup을 실행하세요. 서버가 실행 중이어도 안전합니다. tarball에는 위키 트리, 일관된 SQLite 스냅숏, config.toml이 들어갑니다. 위키가 단일 진실 공급원입니다. 페이지, 링크, 검색은 ai-memory reindex로 위키에서 다시 만들 수 있지만 세션, 인수인계, 사용자, 키는 데이터베이스에만 있습니다.
ai-memory는 SSO를 지원하나요?
표준 준수 issuer라면 어디든 라이프사이클 훅과 CLI 명령에 OIDC 디바이스 인증을 쓸 수 있습니다. 서버가 OIDC 토큰을 직접 검증하지는 않으므로, 서버 API를 IdP 뒤에 두려면 OIDC를 이해하는 게이트웨이를 앞에 둬야 합니다.
서버 두 대가 데이터 디렉터리 하나를 공유할 수 있나요?
아니요. 데이터 디렉터리 하나에 서버 하나만 실행하세요. 2.0부터 서버는 .serve.lock에 배타적 잠금을 걸고, 두 번째 서버는 시작을 거부합니다.