
מפתחים
התקנה מתקדמת ותשתית
לרגע שבו השרת עוזב את הלפטופ. בכל נושא יש תרשים או טבלה, הקונפיגורציה הנכונה הקצרה ביותר וקישור למסמך המלא ב-GitHub.
ארבעה מקומות שבהם זה יכול לרוץ
הקובץ הבינארי זהה בכל הארבעה. מה שמשתנה הוא כתובת ה-bind, ואיתה כמה אימות והצפנה נדרשים.
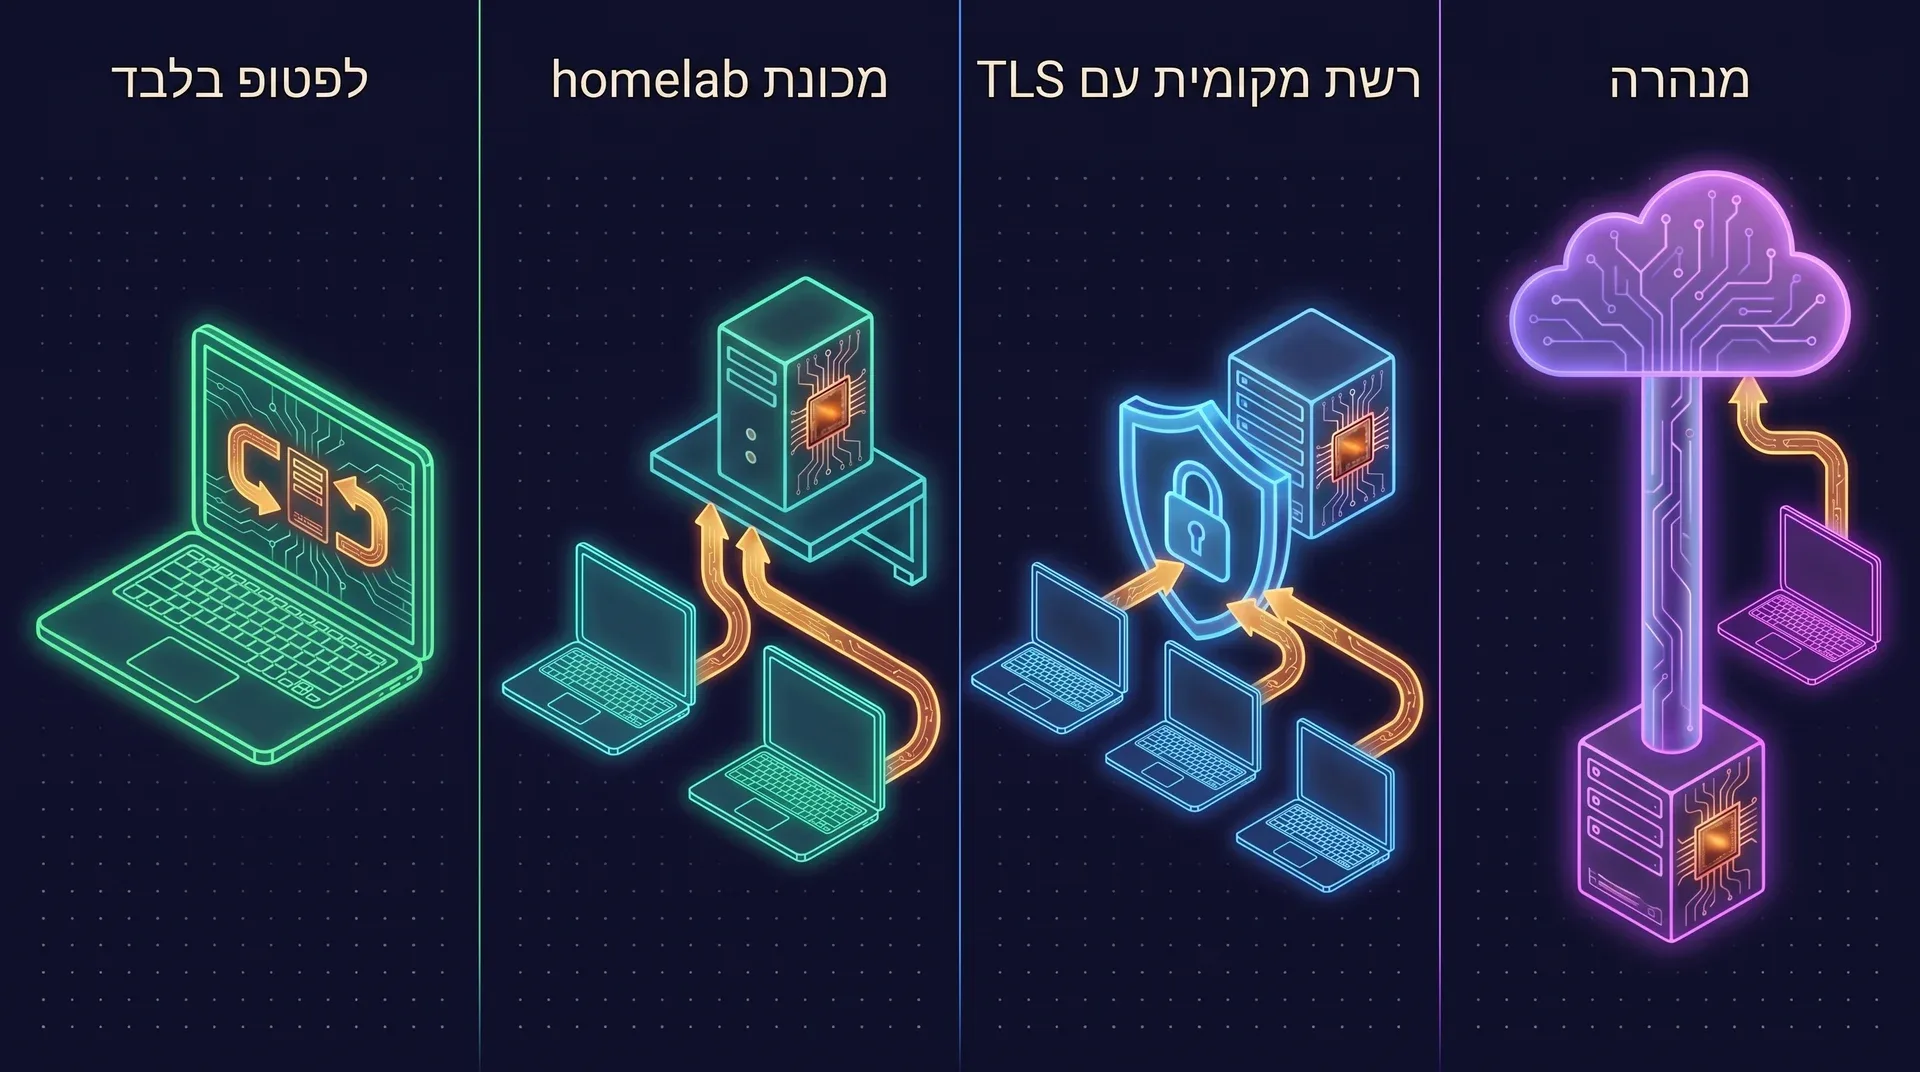
| טופולוגיה | Bind | אימות | TLS | רץ בתור |
|---|---|---|---|---|
| לפטופ בלבד | 127.0.0.1:49374 | לא נדרש | לא | יחידת משתמש של systemd, סוכן launchd או קונטיינר |
| מכונת homelab | 0.0.0.0:49374 | bearer token ו-allowlist של מארחים, שניהם חובה | מומלץ | Docker עם healthcheck, או שירות המערכת מ-AUR |
| LAN עם TLS | 0.0.0.0:49374 מאחורי proxy | טוקן root, ובנוסף משתמש ומפתח API לכל אדם | כן. Caddy עם ה-CA הפנימי שלו עובד גם בלי דומיין | Docker Compose עם sidecar של Caddy |
| Tunnel | בלי פורט על המארח בכלל | כמו בשרת ה-LAN | כן, בקצה של Cloudflare | Docker Compose עם sidecar של cloudflared |
בלפטופ אפשר לוותר לגמרי על HTTP עם ai-memory serve --transport stdio. ל-homelab, ה-repository כולל סקריפט bin/deploy עם תבניות compose ו-env. למדריך הפריסה ל-homelab, צעד אחר צעד.
TLS דרך reverse proxy
ai-memory לא מסיים TLS בעצמו, וזו החלטת תכנון. bearer token מאמת בקשה. הוא לא מצפין אותה.
אפשר לוותר על TLS כאשר
- הסוכן מדבר איתו דרך stdio
- השרת מאזין רק על loopback, למשתמש אחד, ואף אחד לא פותח את
/webממכונה אחרת - מדובר בפיתוח מקומי או בניסוי חד-פעמי
צריך TLS כאשר
- יש חשבונות, כי אז מפתחות
aim_עוברים ברשת - השרת מאזין מעבר ל-loopback
- פותחים את
/webממכונה אחרת - אפשר להגיע לשרת מחוץ ל-LAN
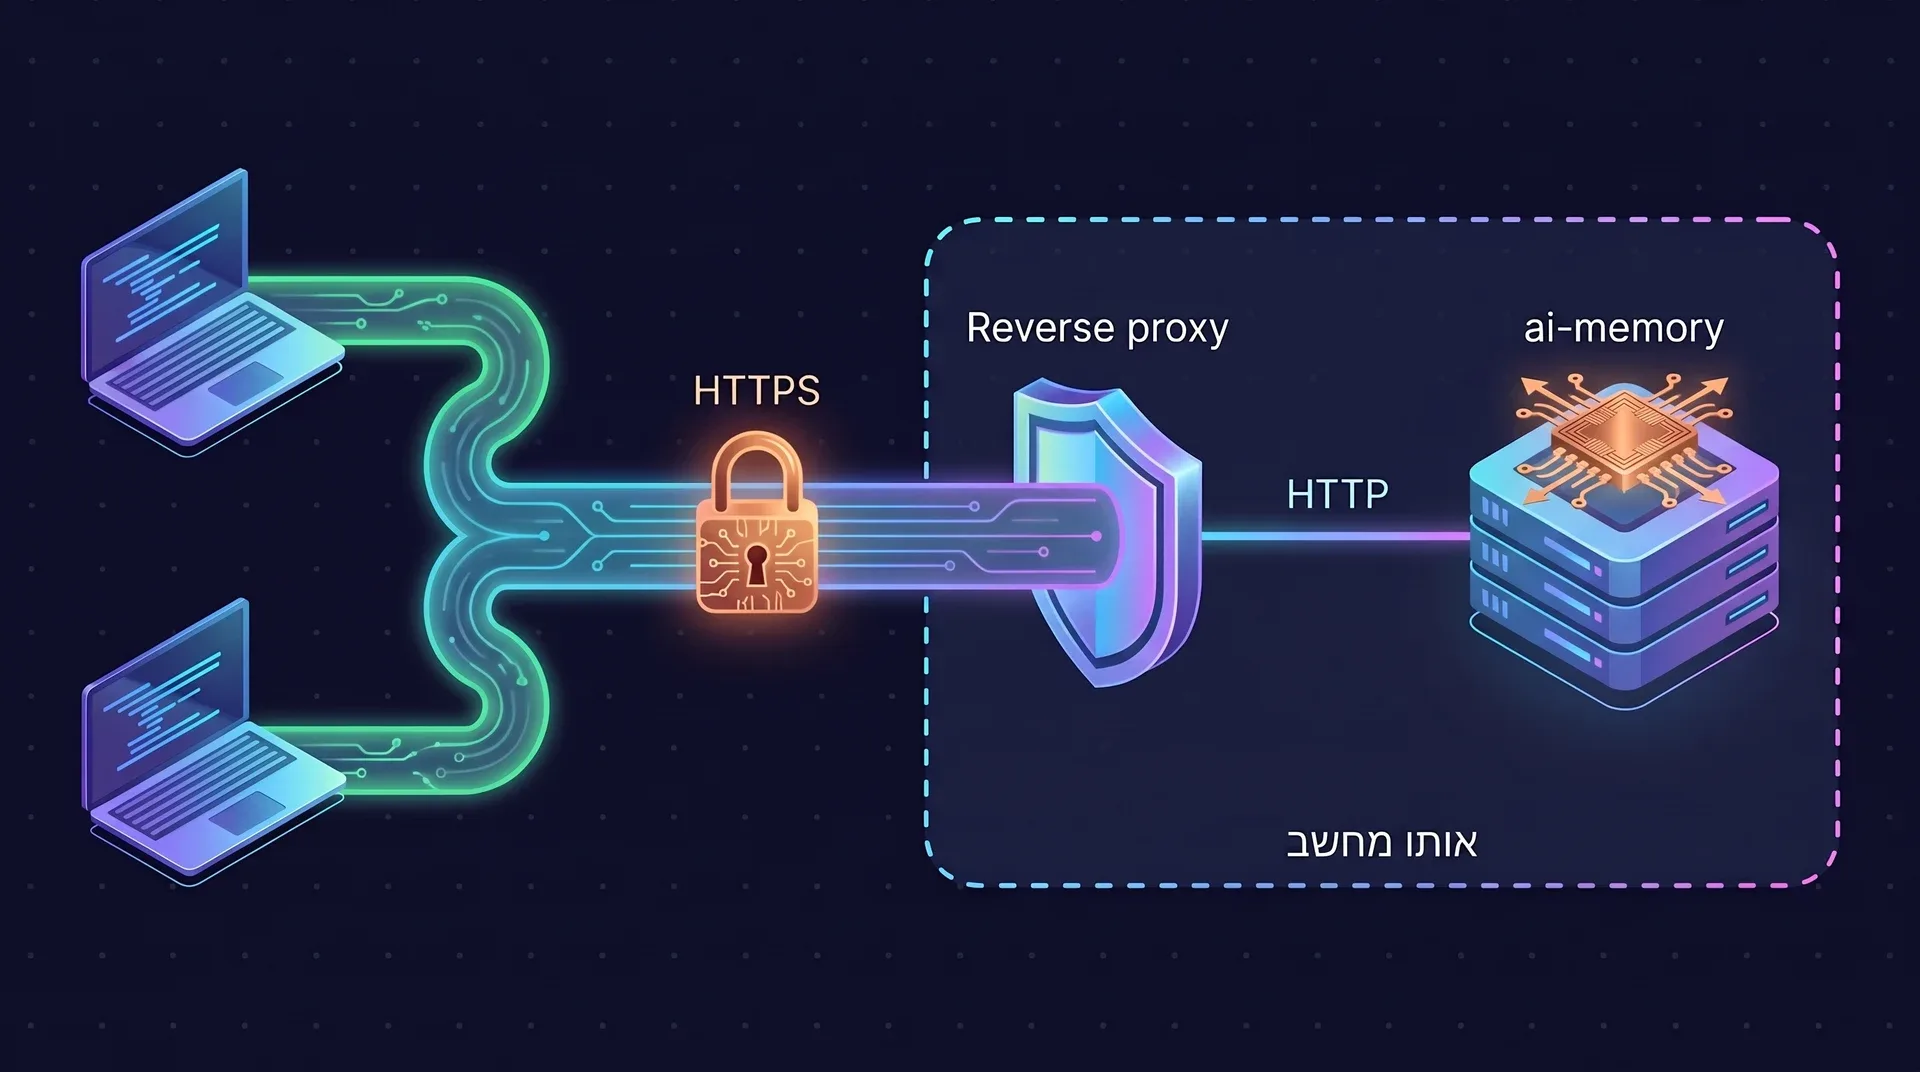
לדומיין ציבורי שהפורטים 80 ו-443 שלו נגישים. Caddy מנפיק ומחדש את תעודת Let’s Encrypt בעצמו. קובץ ה-compose המלא נמצא ב-repository בשם docker/compose.tls.caddy.yml.
memory.example.com {
    reverse_proxy ai-memory:49374
}
בלי דומיין ובלי לחשוף שום דבר. ה-CA הפנימי של Caddy חותם על התעודה, ואת תעודת ה-root שלו מתקינים פעם אחת בכל מכונת לקוח. בלי הצעד הזה הלקוחות מסרבים להתחבר, או שאנשים מתרגלים ללחוץ "המשך" על אזהרות.
{
    local_certs   # מורה ל-Caddy להשתמש ב-CA הפנימי במקום ב-LE
}

homelab.local, 192.168.1.50 {
    reverse_proxy ai-memory:49374
}
docker compose exec caddy cat /data/caddy/pki/authorities/local/root.crt > caddy-root.crt
למי שכבר מריץ nginx ויש לו קובצי תעודה. HTTP/1.1 וכותרת Connection ריקה הם חובה בשביל ה-transport מסוג streamable HTTP של MCP.
server {
    listen 443 ssl http2;
    server_name memory.example.com;

    ssl_certificate     /etc/nginx/certs/memory.crt;
    ssl_certificate_key /etc/nginx/certs/memory.key;

    location / {
        proxy_pass http://ai-memory:49374;
        proxy_set_header Host $host;
        proxy_set_header X-Forwarded-Proto $scheme;
        proxy_set_header X-Forwarded-For $proxy_add_x_forwarded_for;
        proxy_http_version 1.1;
        proxy_set_header Connection "";
    }
}
tunnel יוצא בלבד, כך שלא פותחים פורטים בראוטר. צריך דומיין ב-Cloudflare, והתוכנית החינמית מספיקה. בדשבורד מפנים את ה-hostname הציבורי אל http://ai-memory:49374. קובץ ה-compose המלא הוא docker/compose.tls.cloudflared.yml.
cloudflared:
    image: cloudflare/cloudflared:latest
    container_name: ai-memory-tunnel
    restart: unless-stopped
    command: tunnel --no-autoupdate run
    environment:
      - TUNNEL_TOKEN=${CLOUDFLARE_TUNNEL_TOKEN}
אחר כך מעדכנים את השרת
ה-allowlist חייב לכלול את ה-hostname הציבורי, אחרת ההגנה מפני DNS rebinding דוחה את הבקשות של ה-proxy. הגדרת ה-secure cookie היא חובה מרגע שאנשים מתחברים דרך listener שמעבר ל-loopback.
AI_MEMORY_AUTH_TOKEN=...long-random-token-from-generate-auth-token...
AI_MEMORY_AUTH__SECURE_COOKIE=true
AI_MEMORY_ALLOWED_HOSTS=memory.example.com,localhost,127.0.0.1
AI_MEMORY_BIND=0.0.0.0:49374
ומכוונים מחדש את הלקוחות
כתובת ה-MCP מסתיימת ב-/mcp. כתובת ה-hook היא ה-origin בלבד.
ai-memory install-mcp   --client claude-code --apply \
    --server-url "https://memory.example.com/mcp" --auth-token "$AI_MEMORY_AUTH_TOKEN"
ai-memory install-hooks --agent  claude-code --apply \
    --server-url "https://memory.example.com" --auth-token "$AI_MEMORY_AUTH_TOKEN"
למדריך ה-HTTPS המלא, כולל subpaths ו-timeouts של proxy לריצות bootstrap ארוכות
לשמור על השרת רץ
ai-memory לא מפעיל את עצמו מחדש. את זה עושה מנהל השירותים של כל מערכת הפעלה.
לתחנת עבודה של משתמש אחד. חבילות ה-AUR מתקינות את היחידה. היא לא דורשת sudo ושומרת את המצב ב-~/.local/share/ai-memory. יחידת משתמש נעצרת ב-logout, אלא אם מפעילים lingering.
systemctl --user daemon-reload
systemctl --user enable --now ai-memory.service
systemctl --user status ai-memory.service
journalctl --user -u ai-memory.service -f

# ממשיך לרוץ גם אחרי logout
loginctl enable-linger "$USER"
לתחנת עבודה משותפת או למכונה ב-LAN. הנתונים נמצאים ב-/var/lib/ai-memory, הקונפיגורציה ב-/etc/ai-memory/config.toml והסודות ב-/etc/ai-memory/env. לא מריצים את שתי היחידות על אותה כתובת bind.
sudo systemd-sysusers /usr/lib/sysusers.d/ai-memory.conf
sudo systemd-tmpfiles --create /usr/lib/tmpfiles.d/ai-memory.conf
sudo -u ai-memory ai-memory \
  --data-dir /var/lib/ai-memory \
  --config /etc/ai-memory/config.toml \
  init

sudo systemctl daemon-reload
sudo systemctl enable --now ai-memory.service
journalctl -u ai-memory.service -f
קובצי ה-tarball ל-macOS כוללים plist של LaunchAgent עם שני placeholders. מריצים את זה מתוך ה-tarball שחולץ. LaunchAgent נעצר ב-logout, וב-macOS אין מקבילה ל-lingering. שום דבר לא מבצע רוטציה לשני קובצי הלוג שלו.
mkdir -p ~/Library/Logs/ai-memory
AI_MEMORY_BIN=~/Applications/ai-memory/ai-memory

sed -e "s|__AI_MEMORY_BIN__|$AI_MEMORY_BIN|" \
    -e "s|__HOME__|$HOME|" \
    packaging/launchd/com.github.akitaonrails.ai-memory.plist \
    > ~/Library/LaunchAgents/com.github.akitaonrails.ai-memory.plist

launchctl bootstrap gui/$(id -u) \
    ~/Library/LaunchAgents/com.github.akitaonrails.ai-memory.plist
ל-ai-memory אין dispatcher של Windows Service, ולכן sc create שמצביע על ה-exe לא עובד, ו-Scheduled Task עם Start-Process מת ב-reboot הבא. WinSW עוטף אותו. משתמשים בנתיבים מוחלטים: שירות רץ בתור LocalSystem, ו-%LOCALAPPDATA% היה נפתח לפרופיל הלא נכון.
<service>
  <id>ai-memory</id>
  <name>ai-memory MCP server</name>
  <description>Long-term memory server for AI coding agents.</description>
  <executable>C:\Users\you\AppData\Local\ai-memory\ai-memory.exe</executable>
  <arguments>--data-dir "C:\Users\you\AppData\Local\ai-memory" serve --transport http --bind 127.0.0.1:49374</arguments>
  <startmode>Automatic</startmode>
  <onfailure action="restart" delay="5 sec"/>
  <log mode="roll"/>
</service>
& "$Dest\ai-memory-service.exe" install
& "$Dest\ai-memory-service.exe" start
& "$Dest\ai-memory-service.exe" status
יחידות systemd במדריך ההתקנהlaunchd במדריך ל-macOSWinSW במדריך ל-Windows
תיקיית הנתונים וגיבויים
הוויקי הוא האמת. הוא markdown פשוט בתוך repository של git, ואינדקס החיפוש נבנה ממנו.
reindex בונה מחדש מהוויקי את הדפים, הקישורים וחיפוש הטקסט המלא. הוא לא מחזיר סשנים, תצפיות, העברות, משתמשים, מפתחות, שורות ביקורת או embeddings, ולכן גם מסד הנתונים צריך להיות בגיבוי.
| תיקייה | מה יש בה | סוג | לגבות? |
|---|---|---|---|
wiki/ | כל דף כקובץ markdown, ב-repository אחד של git | אמת | כן. היא נכללת ב-tarball של הגיבוי, ואפשר גם להעתיק אותה ב-rsync או לעשות לה git push |
raw/ | מקטעי תמלול שעברו ניקוי ואינם משתנים, מהרצות מנוהלות | אמת | כן, אם משתמשים ב-ai-memory run. מעתיקים אותה בנפרד |
db/ | memory.sqlite: אינדקס טקסט מלא, ישויות, embeddings, סשנים, משתמשים, שורות ביקורת | ברובה נגזרת | כן. דפים, קישורים וחיפוש נבנים מחדש מהוויקי. סשנים, העברות, משתמשים ומפתחות קיימים רק כאן |
models/ | מודל ה-embeddings המקומי, בערך 87 MB | ניתנת לבנייה מחדש | לא. המודל יורד שוב, או שמניחים את הקבצים ידנית |
logs/ | פלט trace מתגלגל | אפשר לזרוק | לא |
ברירות המחדל: ~/.local/share/ai-memory ב-Linux, ~/Library/Application Support/ai-memory ב-macOS, %LOCALAPPDATA%\ai-memory ב-Windows, /data בקונטיינר. אפשר לשנות עם AI_MEMORY_DATA_DIR.
גיבוי ושחזור
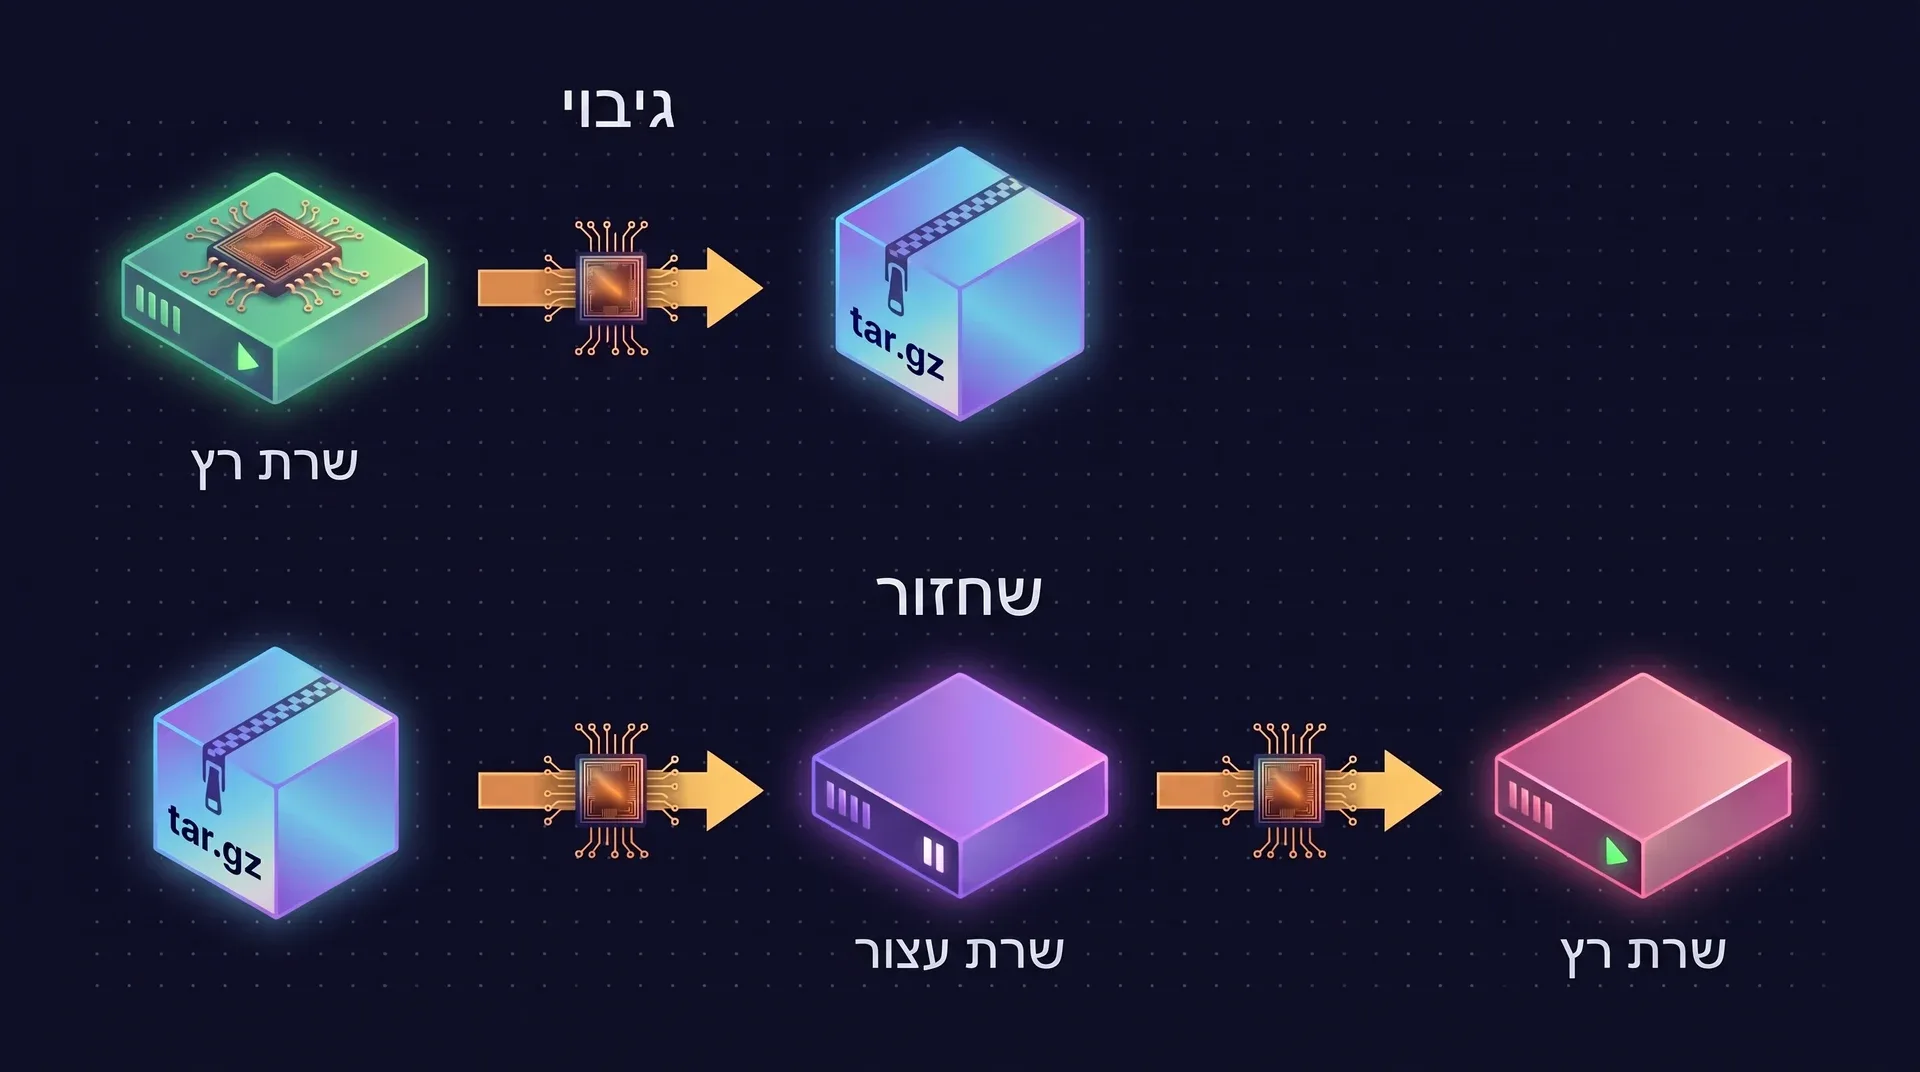
גיבוי
הגיבוי משתמש ב-online backup API של SQLite, כך שכתיבות בזמן ה-snapshot נשארות עקביות. ה-tarball כולל את עץ הוויקי, את ה-snapshot של מסד הנתונים ואת config.toml.
# בטוח גם כשהשרת רץ
ai-memory backup --to /tmp/ai-memory-backup.tar.gz
שחזור
--data-dir הוא הנתיב של ה-volume בצד המארח. הנתיבים כאן לקוחים ממדריך הפריסה. משתמשים בנתיבים שלכם.
# קודם עוצרים את השרת.
docker compose -f ~/deploy/ai-memory/docker-compose.yml down
# שחזור (sysinfo מסרב אם הקונטיינר עדיין רץ).
ai-memory restore --from /tmp/ai-memory-backup.tar.gz --data-dir /var/opt/docker/utils/ai-memory/data --force
# מפעילים מחדש.
docker compose -f ~/deploy/ai-memory/docker-compose.yml up -d
לקריאה על פעולות מחזור החיים: purge, שינוי שם, העברה, שחזור דף, reset
ניתוב וזהות
שרת משותף צריך לענות על שתי שאלות: לאיזה פרויקט הסשן הזה שייך, ומי שואל.
קובץ הסימון
כברירת מחדל הפרויקט הוא שם התיקייה הנוכחית, בתוך workspace בשם default. כדי לשנות את זה מניחים .ai-memory.toml באחת מתיקיות האב. ה-hooks עולים מתיקיית העבודה כלפי מעלה ומשתמשים בקובץ הסימון הראשון שהם מוצאים.
עבודה ואישי
קובץ סימון אחד לכל תיקיית אב. כל repository שמתחתיה נכנס ל-workspace הזה, ושם התיקייה הוא שם הפרויקט.
# ~/projects/movvia/.ai-memory.toml
workspace = "movvia"

# ~/personal/.ai-memory.toml
workspace = "personal"
Mono-repo
קובץ סימון שמגדיר project מצמיד את כל תתי-התיקיות לפרויקט האחד הזה. קובץ הסימון הקרוב ביותר קובע.
# ~/projects/movvia/pe-portais/.ai-memory.toml
workspace = "movvia"
project = "pe-portais"
Git worktrees
worktrees מקושרים ותתי-תיקיות מתמפים ל-repository הראשי, גם כשה-worktree נמצא מחוץ לו.
# ~/projects/.ai-memory.toml
workspace = "oss"
project_strategy = "repo-root"
באותו קובץ יש גם כללי [capture] עם ignore_paths, והפקודה ai-memory install-hooks --apply --capture-mode allowlist הופכת את קובץ הסימון ל-opt-in: repository בלי קובץ כזה לא שולח אירועים. ה-hooks הנייטיב אוכפים את שניהם. ה-shell hooks של ה-wrapper של Docker לא אוכפים. לתיעוד המלא של קובץ הסימון.
מצבי auto-scope
קריאת MCP בלי פרויקט מפורש נפתרת דרך מצביע של "הפרויקט הנוכחי". המצב קובע מי חולק את המצביע הזה. השרת רושם בלוג את המצב הפעיל בזמן העלייה.
| מצב | מתי להשתמש בו |
|---|---|
per_actor | ברירת המחדל. מבודד harnesses שרצים במקביל ואנשים שונים על שרת אחד. |
per_session | ללקוחות מודעי סשן, שמעבירים את מזהה הסשן של ה-hook בכל בקשת MCP. |
single | ההתנהגות שלפני v1.39. משבצת אחת לכל התהליך, והכתיבה האחרונה מנצחת. לא בטוח בשרת משותף. |
[auto_scope]
mode = "per_actor"        # "per_actor" (ברירת המחדל מאז v1.39) | "per_session" | "single"
session_ttl_secs = 3600   # TTL לרשומות לפי מפתח (ברירת מחדל: שעה)
max_entries = 4096        # תקרה קשיחה; הרשומות הישנות ביותר מפונות ראשונות
SSO ו-OIDC
כל מפתח מתחבר פעם אחת ב-device flow של OIDC מול כל issuer שעומד בתקן, למשל Keycloak, Okta או Entra ID. הטוקן מאמת אחר כך את ה-hooks הנייטיב של מחזור החיים ואת פקודות ה-CLI, כשלא הוגדר bearer token סטטי.
ai-memory auth login oidc-device \
  --issuer "https://issuer.example.com/realms/team" \
  --client-id "ai-memory-cli"
אופליין, מגבלות ושדרוגים
מה שצריך לדעת בשביל סקירת אבטחה, תכנון קיבולת וחלון תחזוקה.
התקנה מנותקת מהרשת (air-gapped)
קבצים בינאריים
לכל קובץ בגרסה יש קובץ .sha256. מורידים במכונה מחוברת, מאמתים ומעבירים פנימה. הגרסאות כוללות checksums בלבד, בלי SLSA provenance ובלי artifact attestation.
בנייה מקוד המקור
SQLite מגיע בפנים ו-libgit2 הוא vendored, כך שהבנייה צריכה toolchain של C ואת ה-mirror שלכם ל-crates. cargo vendor עובד.
מודל ה-embeddings
התקנת ברירת מחדל מורידה את המודל מ-Hugging Face בהפעלה הראשונה. כדי שלא תצא אף בקשה החוצה, מניחים מראש את model.safetensors, tokenizer.json ו-config.json בתוך <data_dir>/models/all-MiniLM-L6-v2/. ה-checksums מקובעים בקוד המקור.
בקובץ הבינארי אין טלמטריה. ה-wrapper של Docker בודק ב-Docker Hub אם יש image חדש יותר, לכל היותר פעם ב-24 שעות, ו-AI_MEMORY_NO_VERSION_CHECK=1 מכבה את זה. עדכונים בסביבה מנותקת הם ידניים, בדיוק כמו ההתקנה. לדף על התקנה אופליין.
קיבולת
כל כתיבה עוברת דרך כותב אחד. הפרויקט מדד איפה זה נעצר, בעזרת cargo test -p ai-memory-store --test writer_throughput -- --ignored --nocapture.
| כותבים במקביל | תפוקה | השהיה ממוצעת |
|---|---|---|
| 1 | 42 לשנייה | 23.9 ms |
| 8 | 295 לשנייה | 3.4 ms |
| 32 | 698 לשנייה | 1.43 ms |
| 128 | 700 לשנייה | 1.43 ms |
- התקרה היא בערך 700 כתיבות בשנייה, ומגיעים אליה בסביבות 32 כותבים.
- תור הכתיבה מוגבל ל-1024. מעבר לזה היצרנים מאטים, וכל כתיבה עדיין נשמרת.
- shell hooks מוותרים על השרת אחרי 200 ms ושומרים את האירוע ב-spool מקומי, כך ששרת איטי לא תוקע את הסוכן.
AI_MEMORY_HOOK_RATE_PER_SECו-AI_MEMORY_HOOK_RATE_BURSTמוסיפים rate limit אופציונלי לכל actor וסשן. כבוי כברירת מחדל.
שדרוג
ai-memory upgrade
- עם ה-wrapper של Docker, הפקודה מאמתת ומחליפה את ה-wrapper, מושכת את ה-image ומכינה מחדש את סקריפטי ה-hooks. שרת שרץ על מארח אחר משדרגים בנפרד.
- מיגרציות של הסכמה ושל הוויקי רצות בעלייה. הן חד-כיווניות: קובץ בינארי ישן יותר מסרב לפתוח תיקייה שעברה מיגרציה, אז מריצים קודם
ai-memory backupאם ייתכן שתרצו לחזור אחורה.
שאלות ותשובות
האם ai-memory צריך TLS?
לא בלפטופ של משתמש אחד שמאזין על 127.0.0.1, ולא דרך stdio. מוסיפים proxy עם TLS כשיש חשבונות, כשהשרת מאזין מעבר ל-loopback, כשפותחים את ממשק ה-web ממכונה אחרת, או כשאפשר להגיע אליו מחוץ ל-LAN. ai-memory לא מסיים TLS בעצמו.
מה צריך לגבות?
מריצים ai-memory backup, וזה בטוח גם כשהשרת רץ. ה-tarball כולל את עץ הוויקי, snapshot עקבי של SQLite ואת config.toml. הוויקי הוא מקור האמת. דפים, קישורים וחיפוש אפשר לבנות ממנו מחדש עם ai-memory reindex, אבל סשנים, העברות, משתמשים ומפתחות קיימים רק במסד הנתונים.
האם ai-memory תומך ב-SSO?
הוא תומך באימות device של OIDC ל-hooks של מחזור החיים ולפקודות CLI, מול כל issuer שעומד בתקן. השרת לא מאמת טוקנים של OIDC בעצמו, ולכן כדי לשים את ה-API של השרת מאחורי ספק הזהויות שלכם צריך לפניו gateway שמבין OIDC.
האם שני שרתים יכולים לחלוק תיקיית נתונים אחת?
לא. מריצים שרת אחד לכל תיקיית נתונים. מאז 2.0 השרת לוקח נעילה בלעדית על .serve.lock, ושרת שני מסרב לעלות.
מריצים את זה במקום לא שגרתי?
פותחים issue ומתארים את הסביבה שלכם. הקוד, התיעוד וה-tracker כולם ציבוריים.