
Producto
Qué guarda y qué sale de tu máquina
Una instalación por defecto solo escucha en tu máquina, elimina los secretos antes de escribir nada y no tiene telemetría. Todas las rutas que envían datos fuera están apagadas hasta que las enciendes. Esta página también enumera aquello contra lo que el proyecto no te defiende.
Por defecto, todo es local.
Instálalo, ejecútalo, y lo único que puede hablar con él es tu propia máquina.
Solo loopback
El servidor escucha en 127.0.0.1:49374. Ningún proceso de fuera de la máquina puede llegar a él, y por eso la configuración por defecto no necesita contraseña.
Sin telemetría
El binario no tiene analítica, reporte de fallos ni seguimiento de uso. La captura y la búsqueda hacen cero llamadas de red.
Un directorio que es tuyo
Las páginas de la wiki y el archivo SQLite viven en un solo directorio de datos. En Unix, los directorios nuevos se crean con 0700 y los archivos nuevos con 0600.
Sin cifrado en reposo
La versión 1 se apoya en los permisos del sistema de archivos. A las instalaciones existentes no se les hace chmod por ti. Usa cifrado de disco si el portátil lo necesita.
Nada se guarda sin sanear antes.
Los payloads de los hooks son texto no confiable. Llegan al store por una sola función, y el sistema de tipos lo garantiza.
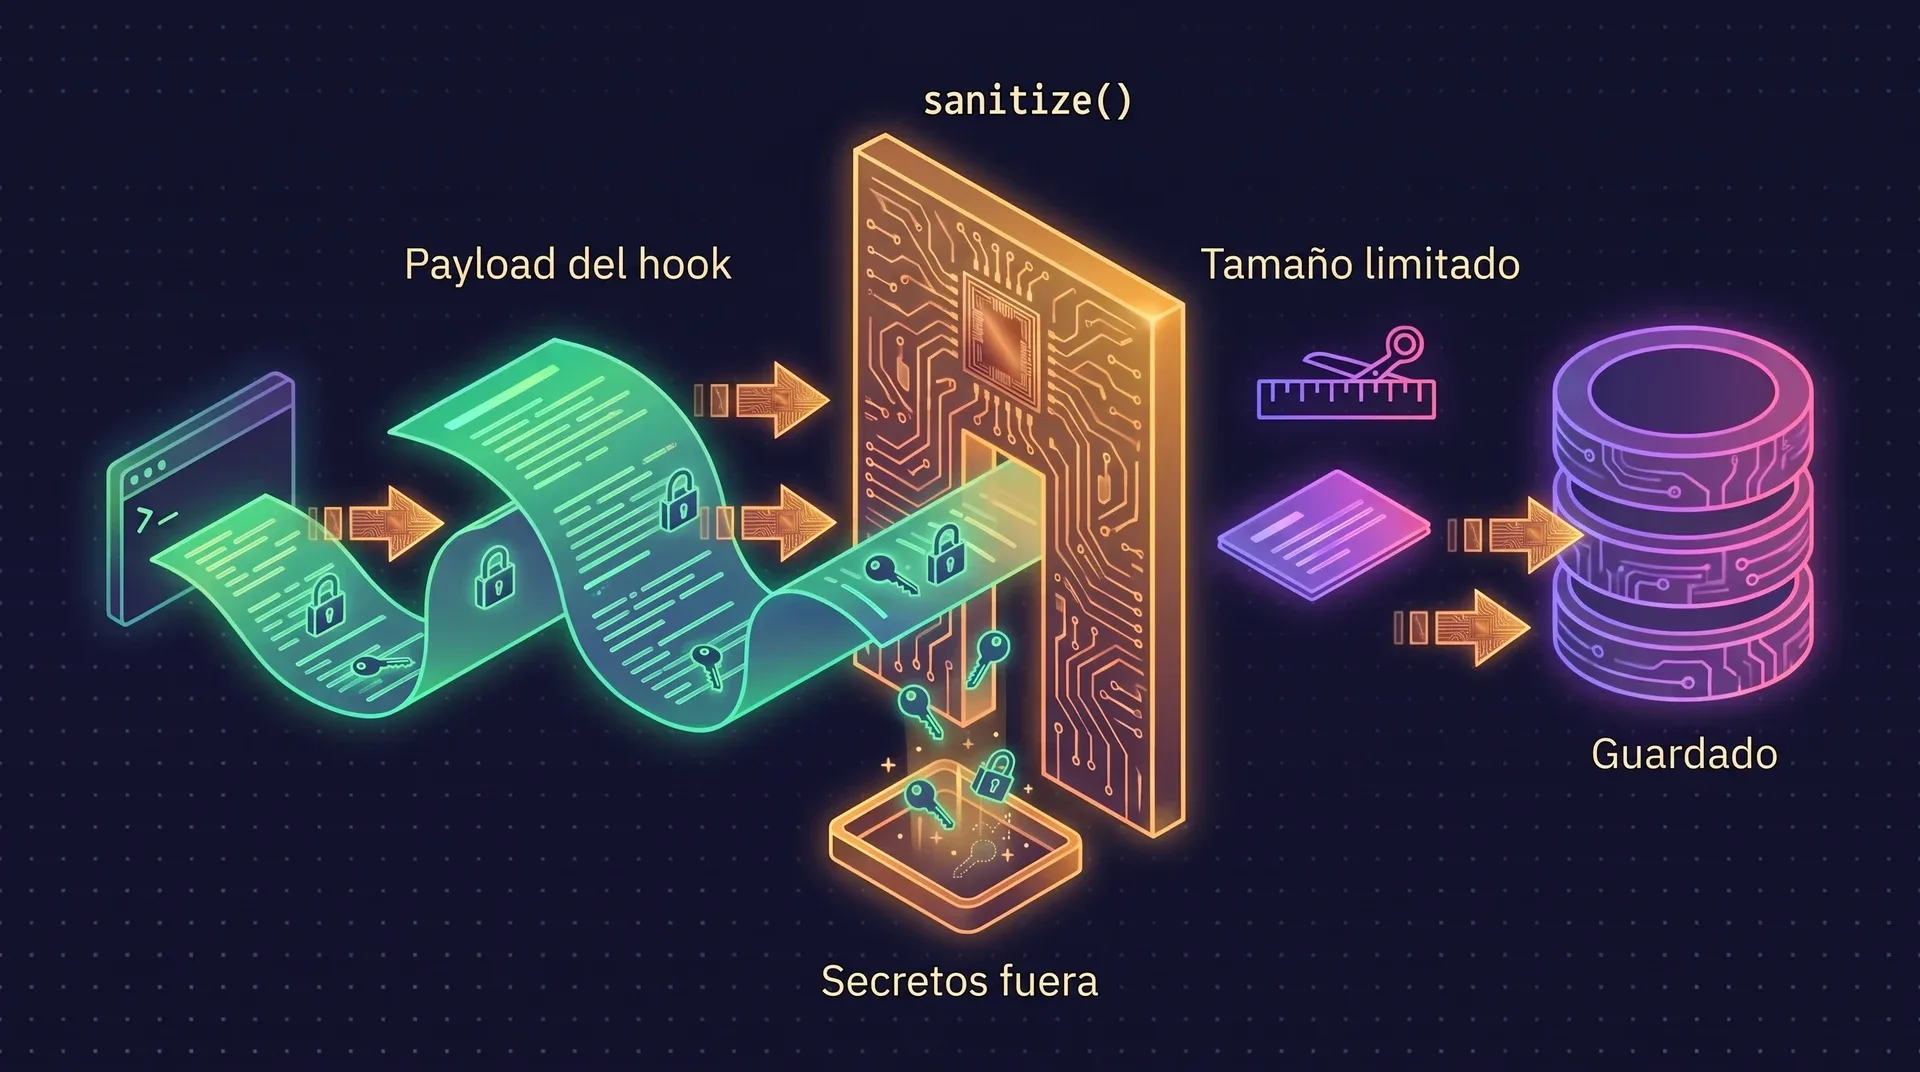
Una sola entrada
El tipo que se guarda solo lo puede construir sanitize(). El código que se salte la limpieza de privacidad no compila.
Los secretos se reemplazan
Las coincidencias se convierten en marcadores tipados como [REDACTED:github_token] o [REDACTED:jwt]. Eso cubre secretos dentro de JSON y rutas de credenciales de Windows, y se eliminan las secuencias de escape de terminal. La limpieza es best effort.
Los tamaños tienen tope
Los extractos de herramientas se cortan a 2 KB y los prompts a 16 KiB. Un tope final de 16 KiB se aplica a todo cuerpo guardado, después de la redacción.
Las entradas de herramientas no se conservan
Los eventos PreToolUse nunca retienen comandos, argumentos, rutas ni cuerpos de entrada. Las observaciones son un rastro de auditoría, nunca una transcripción completa.
Deja fuera una ruta o un repositorio
- Un bloque
[capture]en.ai-memory.tomllista las rutas a ignorar. Los eventos que coinciden se descartan en tu máquina, antes de la cola local, de la red y de los logs. - El modo allowlist lo invierte: un repositorio sin el archivo no emite ningún evento.
- Un conjunto de reglas inválido cae a solo metadatos. Nunca aplica media política.
- La coincidencia es léxica. Los symlinks no se resuelven, y los prompts y los comandos de shell no se pueden asociar a una ruta. Esto es una frontera de captura. No es un DLP completo.
- La salida del asistente nunca se guarda por defecto. Hacen falta un flag en el servidor y otro en el cliente, los dos a la vez.
# .ai-memory.toml en el repositorio
[capture]
ignore_paths = ["private/**", "~/personal-notes/**"]

# O captura solo los repositorios que se apunten
ai-memory install-hooks --apply --capture-mode allowlist
Sube un peldaño cada vez.
Cada paso existe para una situación concreta. Párate en el que corresponde a la tuya.
Una persona, una máquina
Loopback, sin autenticación
La configuración por defecto. No hay nada que configurar, porque nada más puede conectarse.
Un equipo de homelab o una segunda máquina
Bearer token para la LAN
Crea un token con
ai-memory generate-auth-tokeny defineAI_MEMORY_AUTH_TOKEN. Se compara en tiempo constante y protege/mcp,/hook,/handoffy las rutas de administración y de la API. Define tambiénAI_MEMORY_ALLOWED_HOSTS; bloquea el DNS rebinding y no sustituye al token.Escribe más de una persona
Cuentas y claves de API
Las contraseñas se guardan como hashes Argon2id. Cada máquina recibe una clave
aim_que se imprime una vez y no se vuelve a mostrar. Conai-memory api-key rotate <id>la clave antigua empieza a devolver 401 al instante. La primera cuenta deja todas las rutas/admin/*solo para root.Tu equipo ya tiene Keycloak, Okta o Entra ID
Autenticación OIDC por dispositivo para los hooks
Los hooks nativos y la CLI pueden llevar un token obtenido con
ai-memory auth login oidc-device. El servidor no valida tokens OIDC por sí mismo, así que esto necesita delante un gateway compatible con OIDC. Es autenticación de hooks y de CLI a través de un gateway, y el servidor no trae login SSO integrado.Cualquier cosa más allá de loopback
TLS con un proxy inverso
ai-memory no termina TLS, por diseño. Los bearer tokens viajan sin cifrar por la red, así que pon delante Caddy, nginx o un Cloudflare Tunnel. El repo trae plantillas de compose para Caddy y cloudflared. Define
AI_MEMORY_AUTH__SECURE_COOKIE=truecuando la gente inicie sesión desde otras máquinas.
Qué sale de la máquina, y cuándo.
Hay cuatro rutas que pueden enviar datos fuera. Las cuatro vienen apagadas.
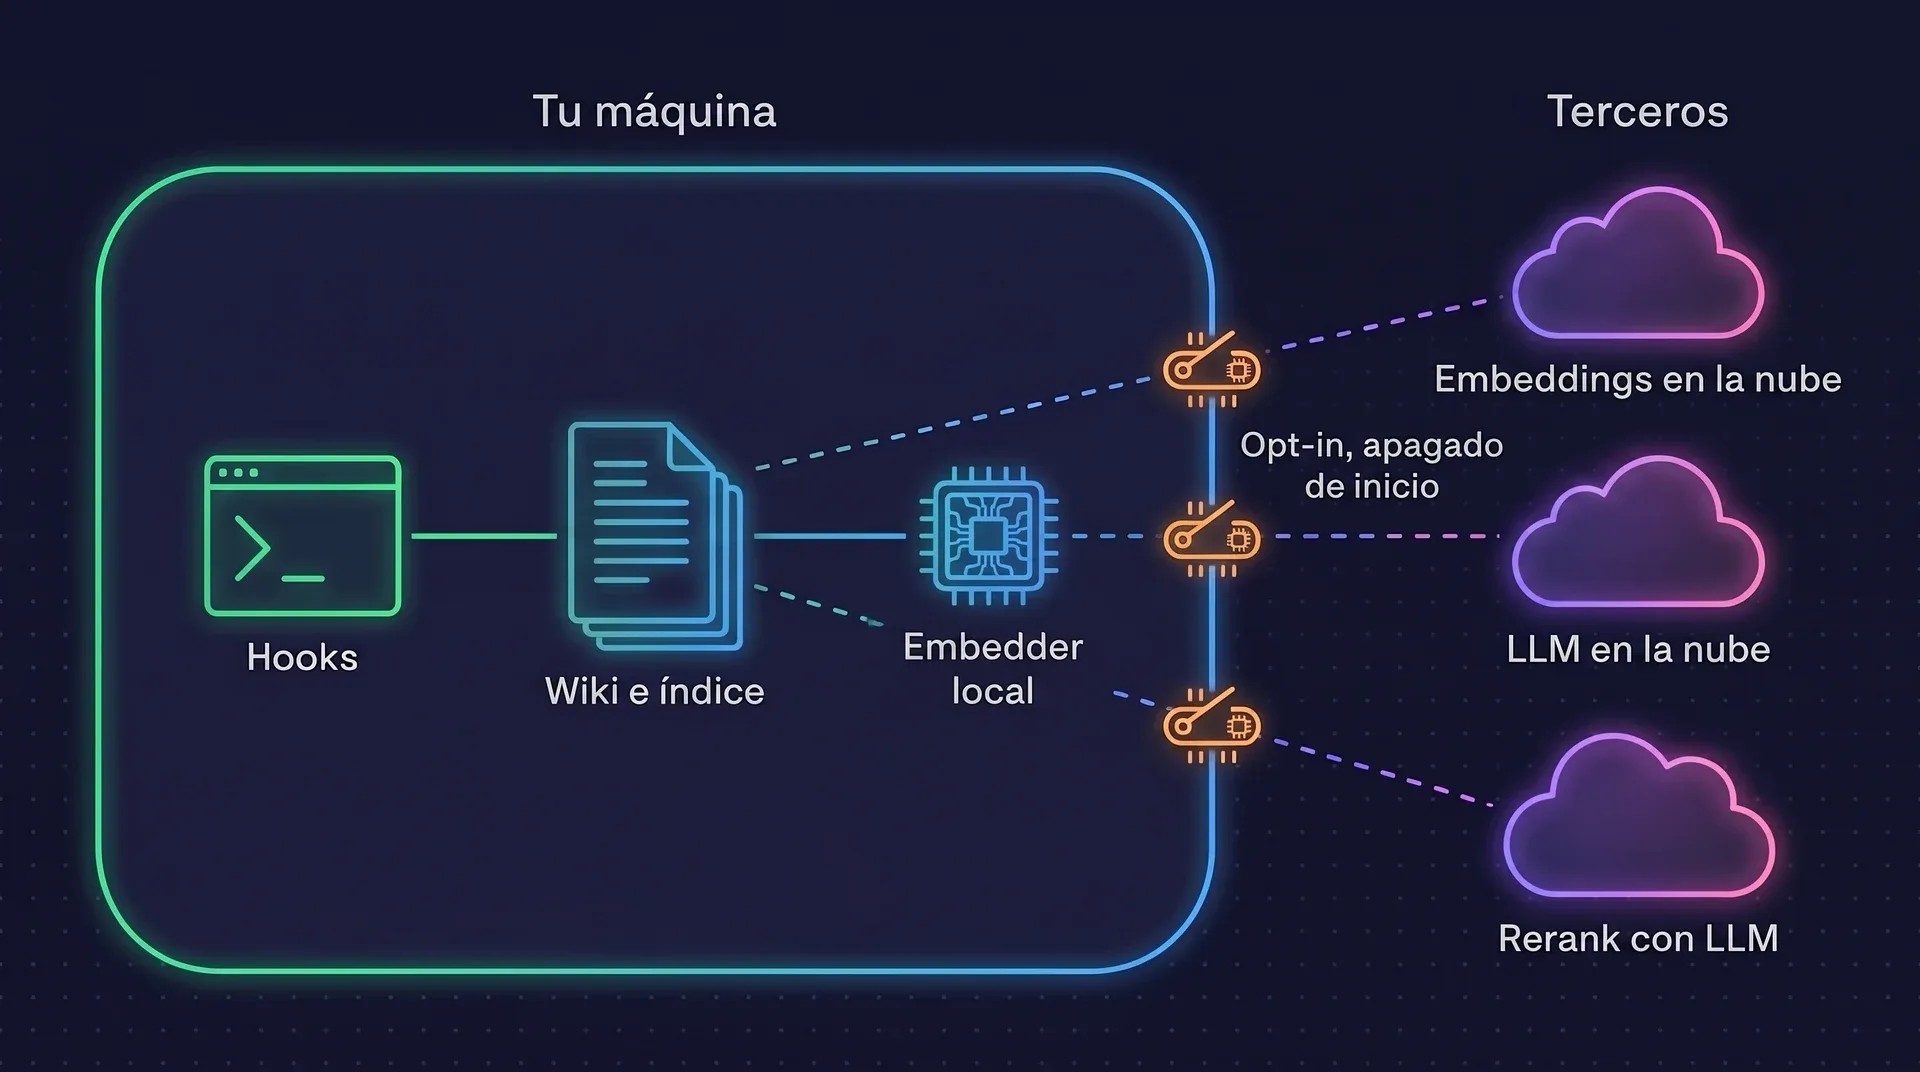
| Ruta | Qué se envía | Cómo se activa | Por defecto |
|---|---|---|---|
| Embeddings remotos | El texto completo de cada página guardada. Si lo activas más tarde, también se procesa el corpus que ya existe. Esta ruta no se sanea como las demás. | embedding_provider = openai | voyage | google | openai-compat | Apagado |
| Captura de la salida del asistente | El texto del último turno del asistente, y solo si además has configurado un LLM en la nube. Es global a la instalación y solo para Claude Code y Codex. | capture_assistant en el servidor y install-hooks --capture-assistant en el cliente | Apagado |
| Rerank con LLM | Cada consulta en vivo, más hasta 30 títulos y fragmentos de página acotados. La consulta no se redacta, porque la redacción podría cambiar su significado. | AI_MEMORY_RERANKER=llm | Apagado |
| Consolidación y lint con LLM | Los prompts construidos con observaciones y páginas guardadas van al proveedor que hayas elegido. Apúntalo a un modelo local y no sale nada. | AI_MEMORY_LLM_PROVIDER | Apagado |
Sin ninguna de estas rutas activada, no hay terceros en el recorrido de los datos. En cuanto configuras un proveedor en la nube, ese proveedor es tu encargado del tratamiento, según tu propio acuerdo con él. DATA_HANDLING.md cubre el encaje con el RGPD. No es asesoría legal.
Quién lo escribió y cómo quitarlo.
Atribución y auditoría
- Con las cuentas activadas, cada escritura lleva su autor. Las páginas registran
author_idy un bloquelast_modified_byen el frontmatter. - Cada mutación queda en una tabla
audit_log, con la identidad del usuario en las filas atribuidas. - La wiki es un repositorio git, así que cada cambio de página es también un commit al que puedes hacer diff y que puedes restaurar.
- Los webhooks de admisión reciben el actor y pueden rechazar una operación.
- Todavía no hay una pantalla para el registro de auditoría. Las filas están en SQLite.
Qué elimina un purge
El purge es un borrado lógico, acotado de modo que el proyecto A nunca pueda eliminar archivos del proyecto B. Los datos no caducan salvo que una página fije una caducidad.
# Elimina una sesión
ai-memory purge-session --workspace default --project my-app --session-id <uuid> --confirm

# Elimina un proyecto entero
ai-memory purge-project --project experimental --confirm
| Después de un purge | Por defecto | Con --compact |
|---|---|---|
| Accesible por la API o las herramientas MCP | No | No |
| Aparece en las búsquedas | No | No |
| Archivo markdown vivo en la wiki | No, best effort | No, best effort |
| Bytes que siguen dentro de memory.sqlite | Sí, en páginas libres | No |
| Texto que sigue en el historial git de la wiki | Sí | Sí |
| Presente en copias de seguridad anteriores | Sí | Sí |
--compact no es un borrado forense. Para quitar texto del historial tienes que reescribir el historial git de la wiki y rotar tus copias de seguridad por tu cuenta. Las operaciones de ciclo de vida tienen el procedimiento completo.
Hasta dónde llega.
Reportar una vulnerabilidad
- No abras un issue público. Abre un aviso de seguridad privado en GitHub.
- Recibes respuesta en un plazo de 7 días. El objetivo para el parche es de 30 días, con mención en el changelog salvo que prefieras que no.
- Solo la última versión recibe correcciones de seguridad.
- Los archivos de cada versión se publican con su SHA-256, y las actions de CI están fijadas a commits revisados.
Preguntas y respuestas
¿ai-memory envía mi código o mis prompts a algún sitio?
No. No hay telemetría, y la captura y la búsqueda no hacen llamadas de red. Los datos solo salen de la máquina si activas los embeddings remotos, la captura de la salida del asistente con un LLM en la nube, el rerank con LLM o un proveedor de LLM en la nube para la consolidación. Todo viene apagado por defecto.
¿Una instalación por defecto hace alguna petición de red?
Una. Desde la 2.0, el embedder local por defecto descarga de Hugging Face un modelo all-MiniLM-L6-v2 de unos 87 MB en el primer arranque. No se envía ningún dato del usuario. Para evitarla, pon embedding_provider = "none" o coloca tú mismo los archivos del modelo.
¿Se guardan los secretos?
Todo payload de hook pasa por un sanitizer antes de guardarse. Las credenciales reconocidas se reemplazan por marcadores tipados [REDACTED:kind] y los cuerpos tienen tope de tamaño. El sanitizer es una limpieza de credenciales best effort y no da ninguna garantía.
¿Puedo borrar una sesión para siempre?
El purge es un borrado lógico. El contenido deja de ser accesible y de aparecer en las búsquedas, pero el texto sigue en el historial git de la wiki y en las copias de seguridad anteriores. El flag --compact limpia las páginas libres de SQLite y no es un borrado forense.
¿ai-memory es multi-tenant?
No. Es un servicio de un solo tenant. Las cuentas dan atribución, y todo usuario autenticado puede leer todos los proyectos de ese servidor. Usa servidores separados para personas que no deban ver los datos de las otras.
Pruébalo primero en loopback.
Sin cuenta y sin clave de API. Solo tu propia máquina puede llegar a él.