
Desarrolladores
Contribuye a ai-memory
101 personas han aportado código hasta ahora. Esta página te lleva de una idea al issue correcto, al crate correcto y a un pull request que pasa la revisión a la primera.
Un proyecto activo, en cifras
Los conteos salen de la API de GitHub cuando se compila este sitio.
Principales contribuidores
akitaonrails
djalmajr
samirhvbr
lucasliet
wblech
rthiago
matheus-rodrigues00
lhzapata
gabrielscharb
pablowinck
aguirreSL
evanmaranzano
kevin9327
gb
mrpaiva
rafaelkenedy
lihuiyang1024
rodrigopalhares
felipe-NR
abhisheksharma2411
Cardosaum
vitorvilas
mobnix
Murillofilho86
viniciusdsandrade
atirna
pedrofjr
enrell
zanlucathiago
davividal
alanhoff
alvadorn
milesibastos
klebervirgilio
iagogfe
dk96-creator
juniorgaudencio00-code
PedroPCardoso
marcelomogami
lucazz
jpramos123
cateim
Gaalbu
bcosta19
BobDylans
victorcesc
Wprosdocimo
XiaoHuo888-hue
adrianogomes-NE
azevedo-luis
cristianodewes
luisfnicolau
omartelo
wslcb
holocaster
rpaggi
murilojrpereiras
LuizFernando991
jaysonsantos
Elige por dónde entrar
Cada una lleva a la página exacta en GitHub.
Reporta un bug
La plantilla te pide la versión, el sistema operativo, el agente, el transporte y las líneas relevantes del log del servidor.
Abrir un reporte de bugPropón una función
Las propuestas son issues; el repositorio no tiene foro de discusiones. La plantilla pregunta qué problema resuelve y si rompería instalaciones existentes.
Abrir una solicitud de funciónBusca un primer issue
La etiqueta good first issue marca trabajo adecuado para quien acaba de llegar. Help wanted marca el resto.
Ver los good first issuesAñade o arregla un harness
El soporte de harness gestionados tiene un protocolo escrito: demostrar el contrato de sesión nativo, leer los almacenes en solo lectura, entregar el contexto antes de confirmarlo e incluir los tests obligatorios.
Lee el protocolo de harnessMejora la documentación
Las guías viven en docs/ como markdown. Una corrección de documentación es un pull request normal y se salta el changelog cuando no cambia nada de cara al usuario.
Explorar docs/Construye alrededor
Los importadores, las interfaces más ricas y los front ends de chat van en proyectos complementarios que usan las superficies públicas de HTTP y MCP.
Lee las reglas de los complementos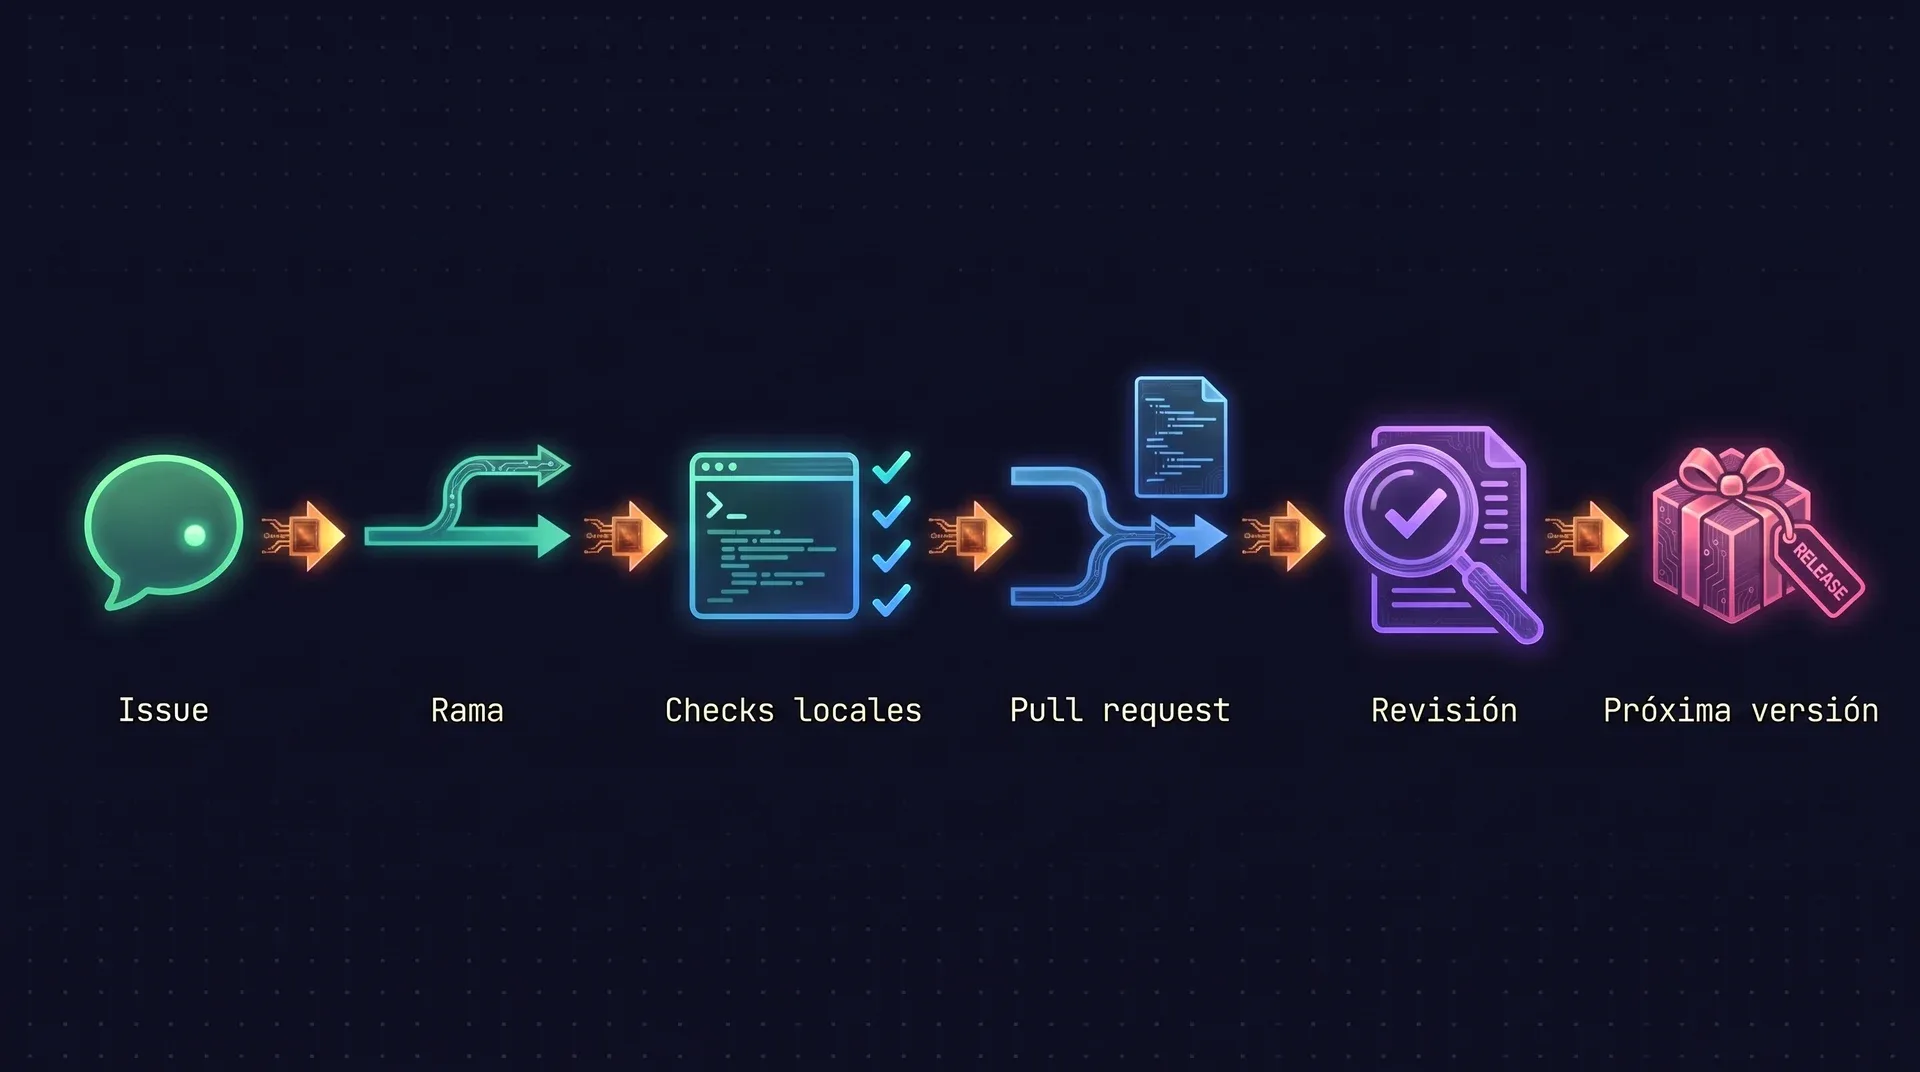
Ponlo a compilar
La compilación es autocontenida. Ninguno de estos comandos necesita una variable de entorno.
Clona y compila
Hace falta Rust 1.95, fijado en
rust-toolchain.tomljunto con rustfmt y clippy, así que rustup instala el toolchain correcto en la primera compilación. SQLite va incluido y libgit2 va vendorizado. Necesitas un toolchain de C estándar y nada más.entorno de desarrollo git clone https://github.com/akitaonrails/ai-memory cd ai-memory cargo build --workspace cargo test --workspace --all-targetsUsa el ciclo del día a día
cargo tnecesita nextest:cargo install cargo-nextest --locked. Se salta los módulos llamadosslowostress, que el hook de pre-push y el CI siguen ejecutando.mientras trabajas cargo t # todo menos el nivel lento, ~20 s en caliente cargo t -p ai-memory-store # un crate: compila solo sus binarios de test cargo t -E 'test(/purge/)' # un tema (compila todo, ejecuta un subconjunto)Instala el hook de pre-push
Una vez por clon. Solo toca su propio bloque en
.git/hooks/pre-push. En una rama con trabajo en curso,git push --no-verifyse lo salta.una vez por clon scripts/install-git-hooks.shPasa los checks antes de hacer push
El CI exige los cinco. Sin nextest,
cargo test --workspace --all-targetsequivale acargo tf. Si te falta el último:cargo install cargo-deny cargo-audit.checks obligatorios cargo fmt --all -- --check git diff --check cargo clippy --workspace --all-targets -- -D warnings cargo tf # todos los tests (alias: cargo nextest run -P full) cargo deny check # política de dependenciasComprueba quién dicen tus commits que eres
Usa un email verificado en tu cuenta de GitHub o su dirección noreply. El historial de main nunca se reescribe para corregir la autoría.
autoría de los commits git log --format='%h %an <%ae>' "$(git merge-base HEAD origin/main)"..HEAD
Reglas básicas y el listón de aceptación
AGENTS.md es el archivo de reglas canónico, para personas y para agentes de programación. CONTRIBUTING.md lo condensa en esto.
Cómo se espera que llegue el trabajo
El changelog es un requisito de merge
Cada cambio de cara al usuario añade una entrada bajo [Unreleased] en el mismo pull request. Los revisores tratan una entrada ausente como bloqueante. Los refactors y los cambios que solo tocan tests están exentos.
Tests antes de dar algo por “hecho”
El trabajo cuenta como hecho cuando tiene tests, sobre todo los parsers, la derivación de ID y los cálculos de retención.
Sin código muerto ni funciones a medias
Los stubs se documentan en el comentario del módulo, con el hito que los va a terminar.
No te salgas del cambio
No refactorices código que el hito actual no necesita.
Los comentarios explican el porqué
Un comentario que repite la línea de arriba se elimina.
Invariantes que un pull request no puede romper
- Todas las escrituras a SQLite pasan por el único actor escritor,
WriterHandle. - La configuración se lee una vez al arrancar. Ningún
std::env::varfuera deConfig::load. - Las escrituras de archivos son atómicas: tmp, rename, fsync. Nunca sobre el propio archivo.
- Cada página de la wiki lleva el espacio de nombres
(workspace_id, project_id). - La CLI es un cliente HTTP ligero. Nunca abre el archivo SQLite ni el directorio de la wiki.
La lista completa, con el bug que evita cada uno, está en AGENTS.md
Un mapa del código
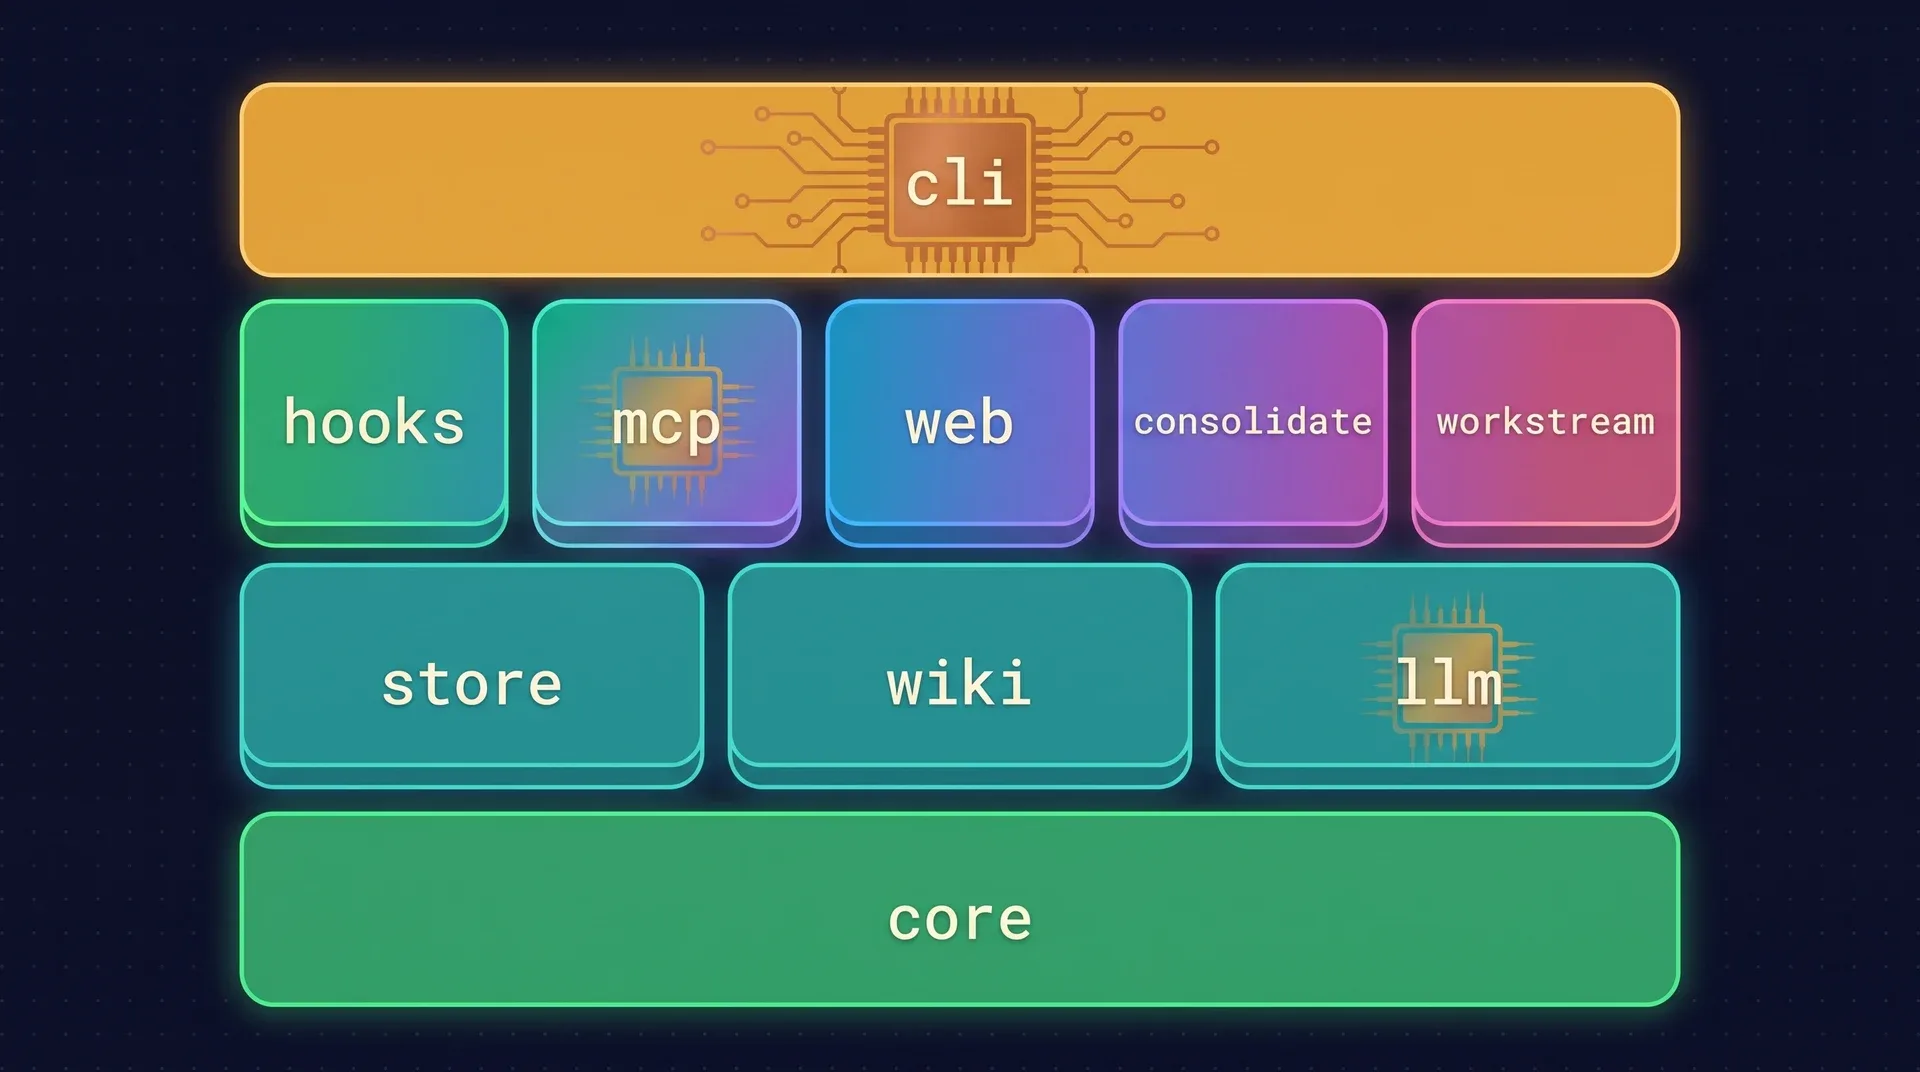
En el binario van diez crates. Cada uno tiene una responsabilidad y una API tipada, y no hay dependencias circulares.
| Crate | Qué vive ahí |
|---|---|
ai-memory-core | Tipos de dominio, errores e ids. Sin IO. |
ai-memory-store | SQLite, el actor escritor, el pool de lectores y los cálculos de decaimiento. |
ai-memory-wiki | Escrituras atómicas de markdown, el file watcher y git. |
ai-memory-mcp | El transporte MCP, el enrutador de herramientas y las rutas de administración. |
ai-memory-hooks | Los esquemas de payload de los hooks, el saneador y el endpoint /hook. |
ai-memory-llm | La frontera de autenticación de proveedores y los traits de LLM y embedder. |
ai-memory-consolidate | Ingesta, lint, barrido y el pipeline de auto-improve. |
ai-memory-web | El navegador /web de solo lectura y las rutas JSON de /api/v1. |
ai-memory-workstream | Lectores de solo lectura de transcripciones nativas y los adaptadores de lanzamiento detrás de ai-memory run. |
ai-memory-cli | El binario ai-memory y sus subcomandos HTTP ligeros. |
Fuera de crates/
| Directorio | Qué vive ahí |
|---|---|
companions/ | ai-memory-importer, un paquete independiente fuera del workspace raíz. Compílalo con --manifest-path. |
hooks/ | Paquetes de hooks de ciclo de vida, una carpeta por agente, en shell y nativos. |
evals/ | El harness de benchmarks. Es miembro del workspace y nunca se distribuye. |
docs/ | Guías de arquitectura, decisiones de diseño, instalación, despliegue y uso. |
tests/ | Smoke tests de extremo a extremo, tests de shell de los hooks y fixtures. |
Los tests de integración viven en tests/suite/ dentro de cada crate. Los helpers compartidos entre crates van en crates/ai-memory-test-support, que nunca se distribuye.
Cómo se revisan los pull requests
Las revisiones siguen la plantilla del pull request, así que rellenarla con honestidad es la mayor parte del trabajo.
La plantilla es la checklist
Pregunta qué cambió, por qué, un plan de pruebas con los checks marcados, la autoría de los commits, el impacto en la versión y la entrada del changelog.
Di qué tipo de versión es
Marca patch, minor o major. Una corrección archivada bajo “Added” puede subir la versión equivocada, así que pon la entrada del changelog bajo el encabezado correcto.
Los cambios incompatibles esperan a una major
Señálalos en la descripción. Reciben la etiqueta breaking-change y se programan, así que no frenan las versiones patch y minor.
El CI es rápido en cada merge
Un merge depende de los jobs rápidos de Linux. Las partes de macOS y Windows corren con una etiqueta, cada noche o a mano, y siempre antes de una versión.
Las correcciones salen primero
Una corrección de bug sale en la siguiente versión patch y no se retiene por trabajo de funciones. Un harness o un proveedor nuevo sale en la siguiente minor.
Un pull request de harness ejecuta este check más corto, registra la versión de la CLI contra la que se probó e incluye una pasada manual contra el harness real.
cargo fmt --check
git diff --check
cargo test --workspace
cargo clippy --workspace --all-targets -- -D warnings
Pruébalo antes de cambiarlo.
Úsalo en tus propios proyectos durante un día. El bug que encuentres es tu primer issue.