
Soluções
Pare de explicar seu projeto de novo
Você fecha um agente, abre outro, e ele já conhece a arquitetura, o que foi tentado e não deu certo e o que ainda está em aberto. Funciona igual no PC e no notebook, e não precisa de chave de API.
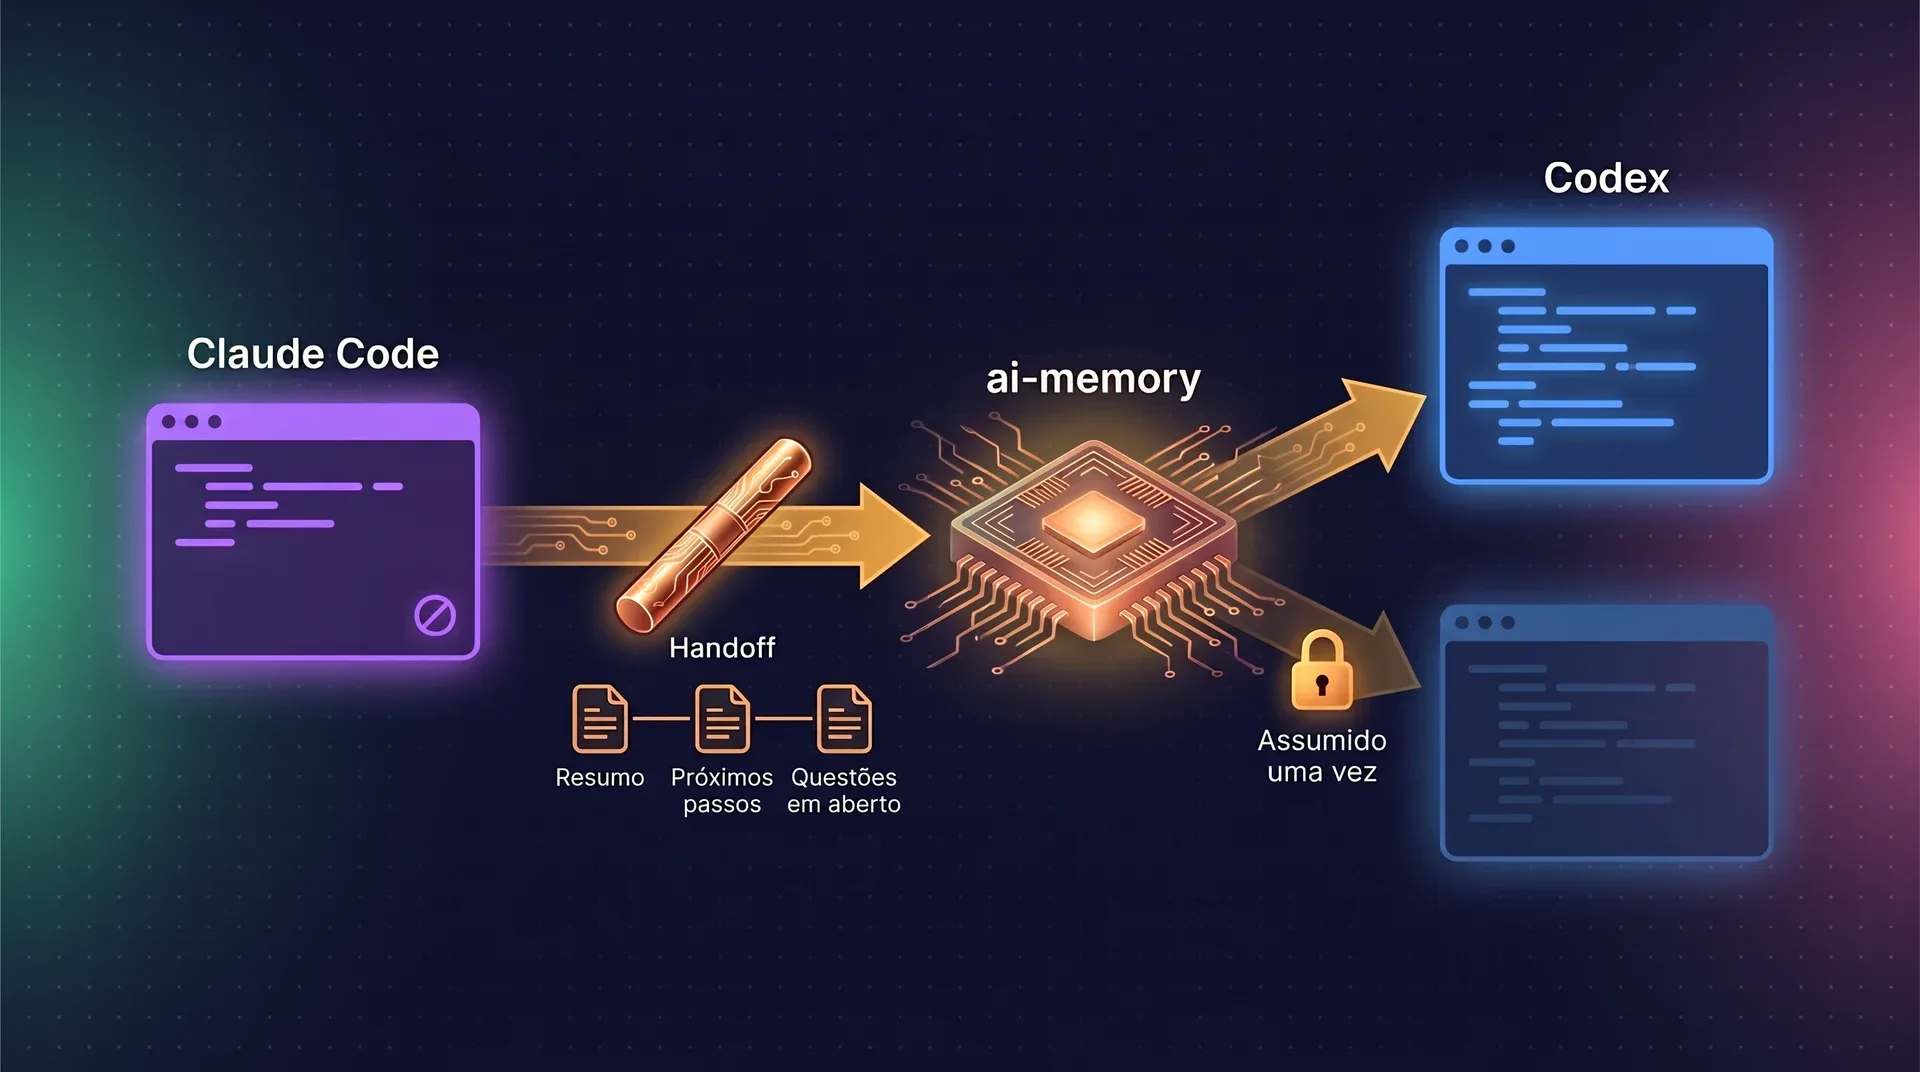
Troque de agente no meio da tarefa
Bateu no rate limit do Claude Code às 4 da tarde. Abra o Codex no mesmo diretório e continue.
Tipado
Um handoff leva o resumo da sessão, os próximos passos e as perguntas em aberto. O próximo agente recebe isso no início da sessão, antes de você digitar qualquer coisa.
Assumido uma vez só
A primeira sessão que inicia naquele diretório pega o bastão. Uma segunda que pedir não recebe nada, então dois agentes nunca retomam o mesmo trabalho.
Automático, e você pode sobrescrever
Todo fim de sessão grava um. Diga "salve o contexto para a próxima sessão" para gravar o seu, e o seu tem prioridade sobre o automático.
Dois agentes, Grok Build CLI e Zero, ignoram o que os hooks imprimem no início da sessão. Peça para eles aceitarem o handoff e eles buscam via MCP. A página de integrações lista todos os agentes e o que cada um suporta.
O que você fala no dia a dia
Na maioria dos dias você não fala nada. Os hooks capturam a sessão, e o fim da sessão transforma isso em páginas da wiki. Quando você quiser alguma coisa, a interface é português mesmo.
- “Onde a gente parou?”
- Lê o handoff pendente: resumo, próximos passos, perguntas em aberto.
- “A gente já discutiu X?”
- Busca na wiki com full-text, entidades, links e vetores fundidos em um ranking só.
- “Me atualiza. Fiquei um tempo fora.”
- Monta um resumo que fica mais longo quanto mais tempo você ficou fora. Sai em prosa com um LLM configurado, e em dados estruturados sem um.
- “Lembre disso para sempre.”
- Grava uma página durável, versionada em git. Fixe a página e ela nunca decai.
- “Lembre disso até sexta.”
- Grava a página com data de expiração. Depois disso, o forget sweep apaga.
- “Essa página está desatualizada.”
- Registra um feedback que rebaixa a página nos próximos rankings. Feedback nunca apaga nada.
O guia de uso no GitHub tem a lista completa de frases e a ferramenta MCP por trás de cada uma.
Um launcher, e uma porta de entrada para projetos antigos
Inicie seu agente com ai-memory run
- A primeira execução instala os hooks e a entrada MCP daquele agente, se estiverem faltando. Isso acontece uma vez por agente.
- Trocar de agente retoma o mesmo workstream, com o histórico visível somado ao resumo do handoff.
ai-memory continueencontra seu checkout mais recente a partir de qualquer diretório e retoma lá.- Hoje cobre 12 agentes. Abrir o agente direto continua funcionando, e só os hooks já levam o handoff.
cd /path/to/project
ai-memory run claude

# Feche o Claude Code e continue o mesmo workstream no Codex.
ai-memory run codex --yolo

# De qualquer diretório: me leve de volta para onde eu estava.
ai-memory continue
Adote um projeto que já existe
A primeira sessão em um projeto vazio importa seu histórico local de agentes uma vez, limitado às 25 sessões mais recentes. Você também pode rodar na mão.
# Veja o que seria importado, depois importe
ai-memory backfill --dry-run
ai-memory backfill
Desative a importação automática da primeira execução com AI_MEMORY_BACKFILL_ON_START=false.
# Precisa de um provedor de LLM no servidor
ai-memory bootstrap --dry-run
ai-memory bootstrap
O bootstrap lê o git log, o README, docs/ e seus arquivos de regras. O projeto mediu uma execução em bem menos de US$ 0,20 com Kimi 2.6 via OpenRouter. Ele pode escrever páginas que parecem certas e estão erradas, então leia o dry run antes.
A mesma memória no PC e no notebook
Rode um servidor pequeno e aponte todas as máquinas para ele. O projeto é identificado pelo nome do checkout, então caminhos diferentes em cada máquina caem na mesma memória.
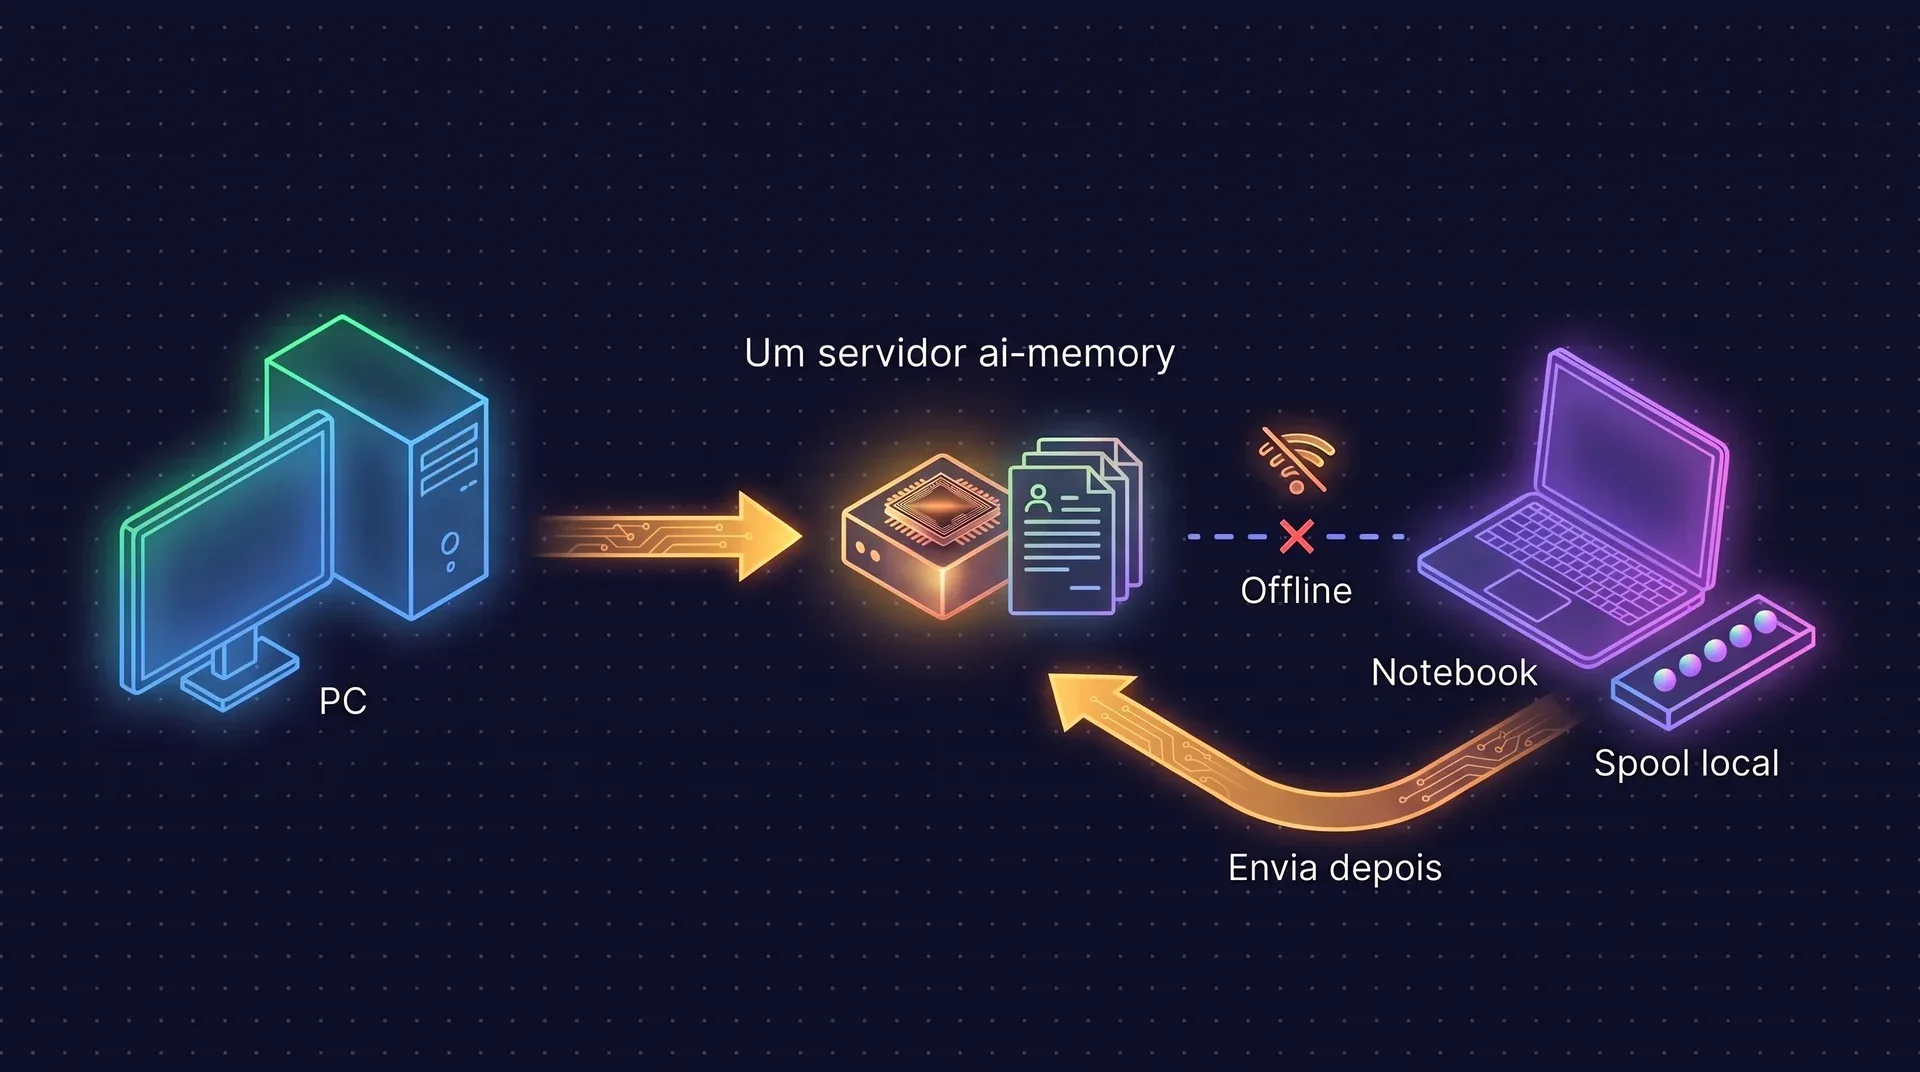
- Coloque o servidor em uma máquina do homelab, ou na que ficar sempre ligada. É um binário só ou um container só.
- Quando o notebook está offline, os eventos dos hooks vão para um spool local e são enviados quando o servidor volta a responder. Cada entrada tem uma chave de idempotência, então nada é gravado duas vezes.
ai-memory statusmostra quantos eventos estão pendentes e a idade do mais antigo.- Um servidor que escuta fora do loopback exige um bearer token. O token não criptografa o tráfego, então adicione TLS antes de sair da sua LAN.
# No PC e no notebook
export AI_MEMORY_SERVER_URL="http://<server-ip>:49374"
export AI_MEMORY_AUTH_TOKEN="$TOKEN"
ai-memory install-mcp   --client claude-code --apply
ai-memory install-hooks --agent  claude-code --apply
Sem chave de API, e arquivos que você consegue ler
A instalação padrão não custa nada para rodar e guarda tudo como markdown em um repositório git.
Zero chamadas a LLM
Captura, resumos de sessão, handoffs e busca rodam sem modelo nenhum. Os resumos são baseados em regras até você adicionar um provedor.
Embeddings rodam dentro do binário
Um modelo local pequeno (all-MiniLM-L6-v2, cerca de 87 MB) é baixado uma vez em background. A busca vetorial liga no próximo restart. Não precisa de chave nem de GPU.
Só loopback
O servidor padrão escuta em 127.0.0.1:49374, sem conta e sem telemetria. Nada mais na rede consegue acessá-lo.
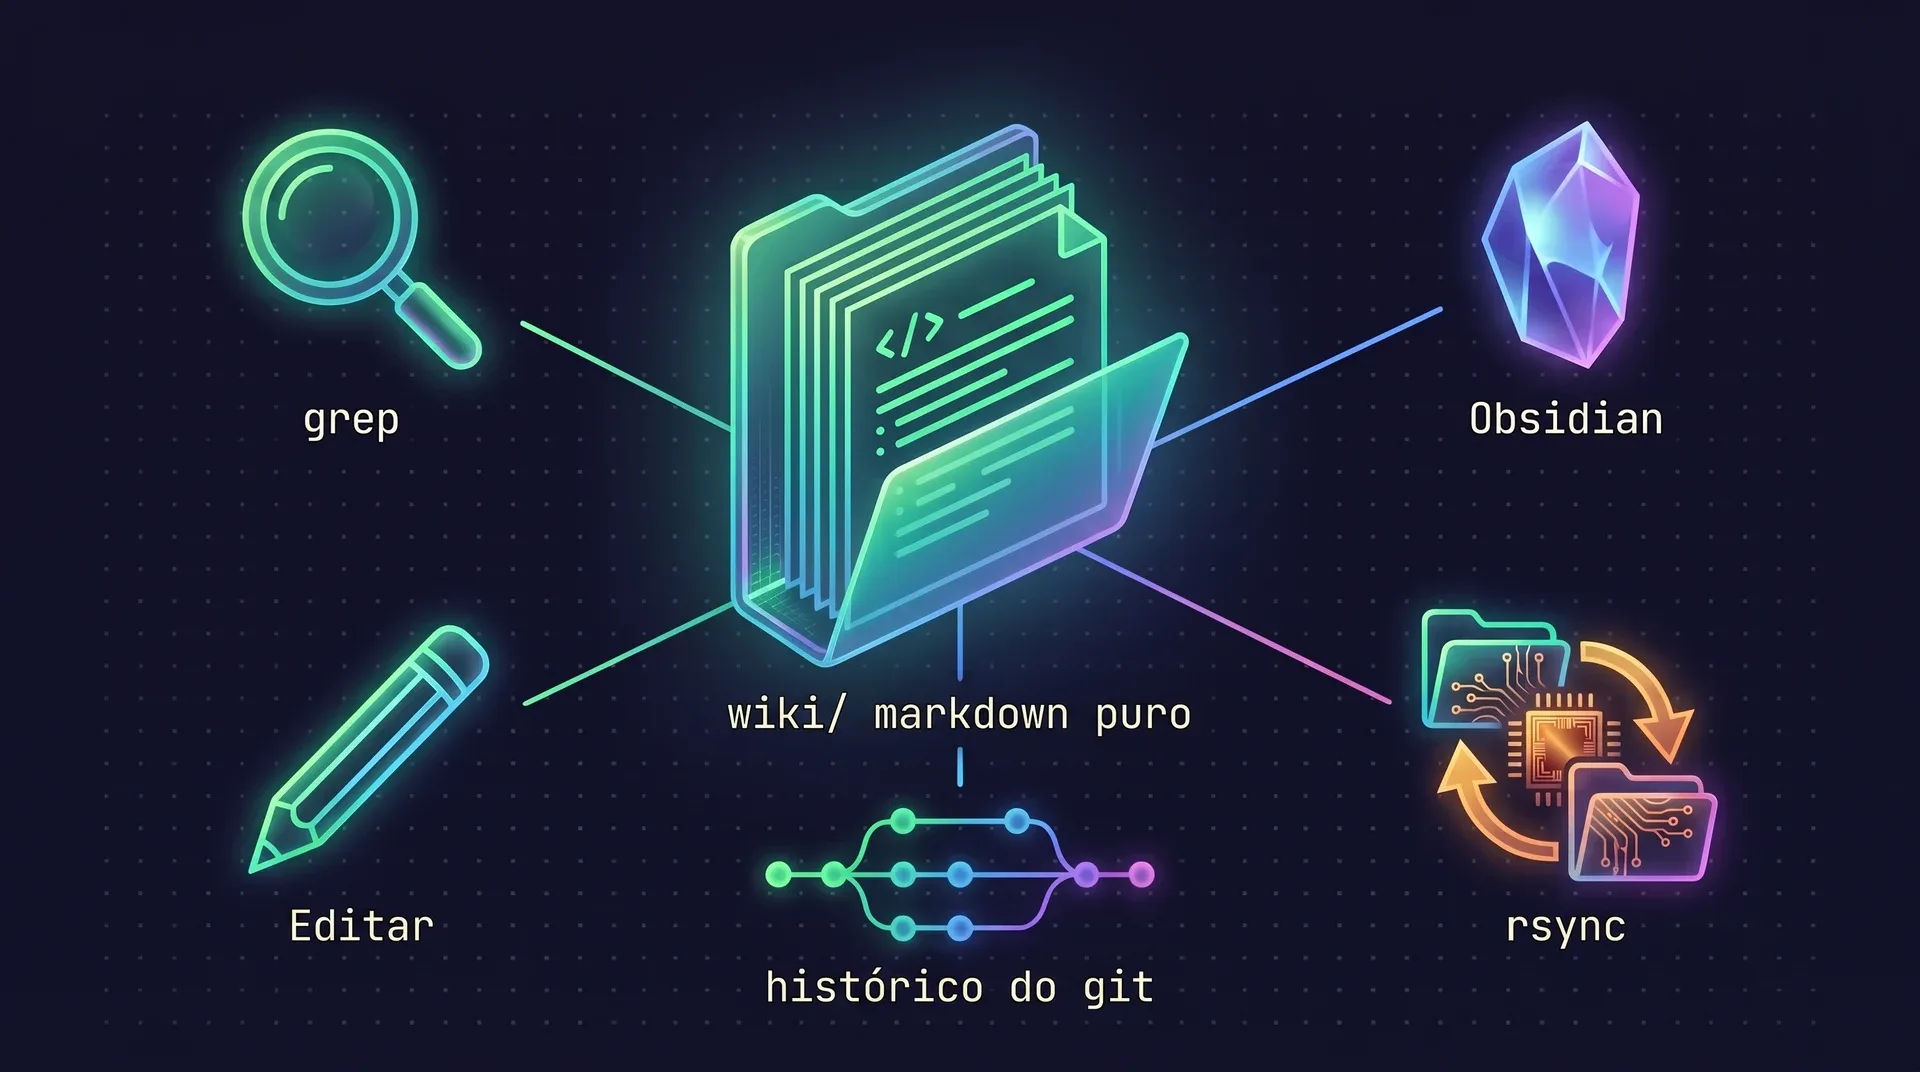
Leve os arquivos para onde quiser
O índice SQLite é derivado dos arquivos e pode ser reconstruído a partir deles. Faça backup com ai-memory backup, rsync ou um git push para o seu próprio remote.
# Copie a wiki para fora do container e abra no Obsidian
docker cp ai-memory:/data/wiki ./my-ai-memory-wiki

# Ou leia o histórico dela
git -C /data/wiki log --oneline
Ou navegue por uma interface web somente leitura
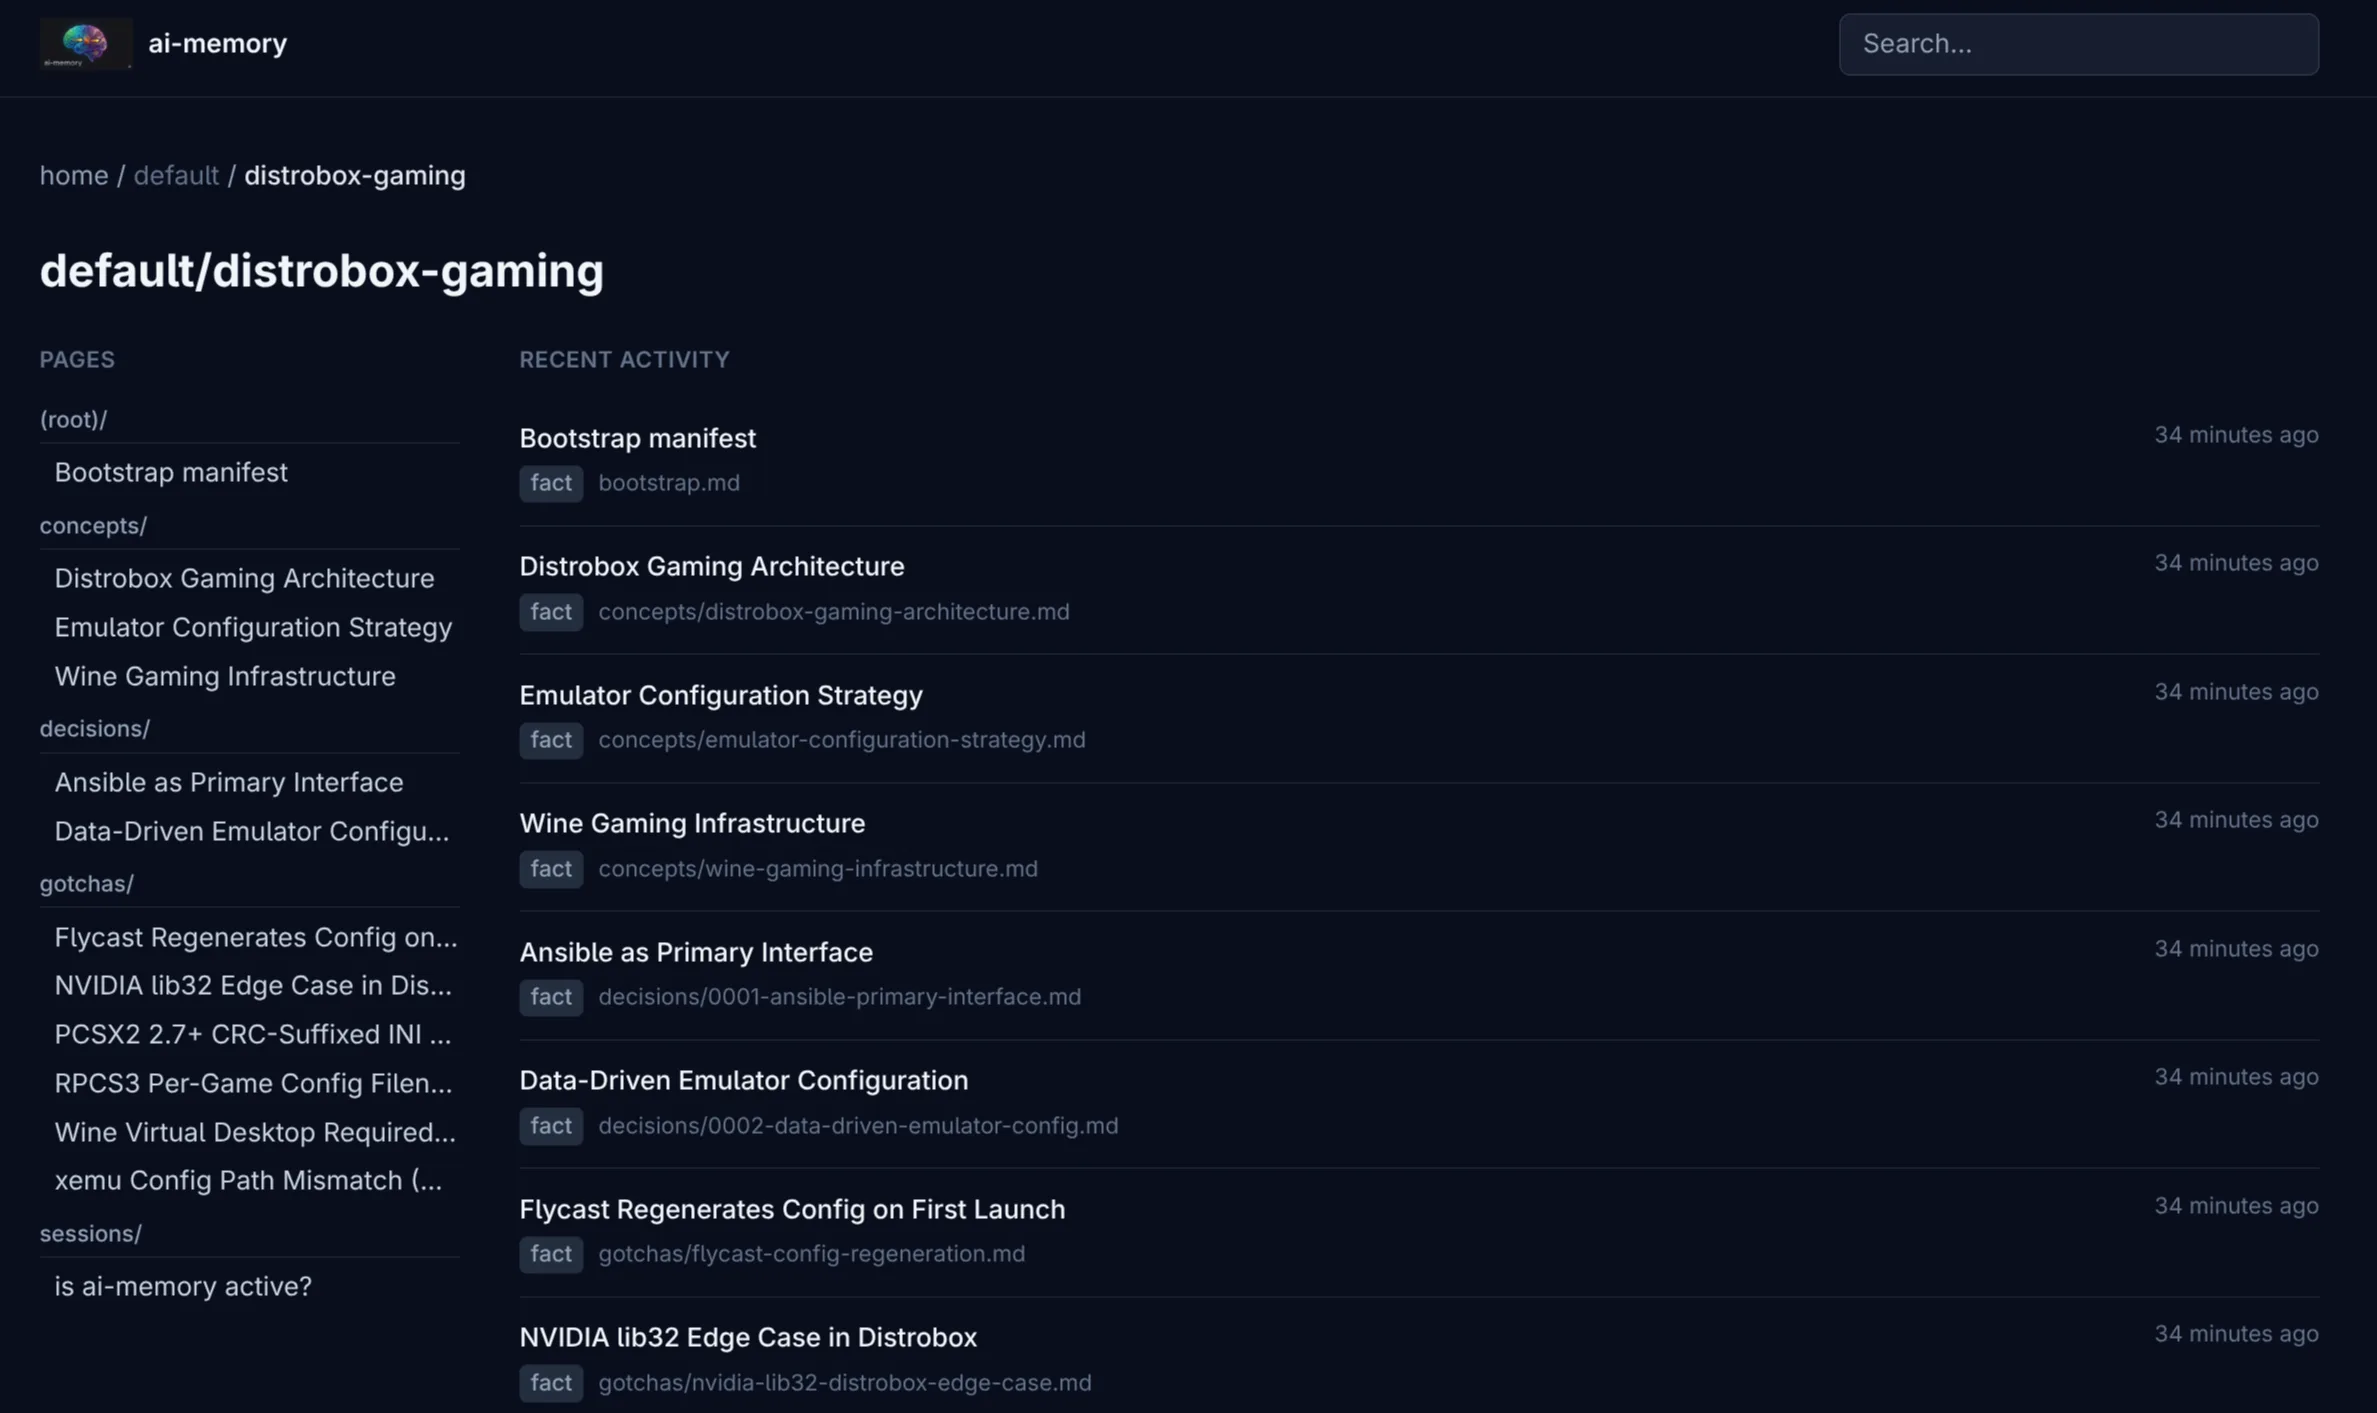
Uma flag adiciona uma visualização no navegador com a lista de projetos, a árvore de páginas, markdown renderizado, busca e links de wiki clicáveis. Ela não edita nada.
ai-memory serve --transport http --bind 127.0.0.1:49374 --enable-web
# depois abra http://127.0.0.1:49374/web
Você precisa disso?
Perguntas e respostas
Preciso de uma chave de API ou de um LLM para usar o ai-memory?
Não. Captura, resumos de sessão, handoffs e busca funcionam com zero chamadas a LLM. Os embeddings da busca vetorial rodam in-process com um modelo local. Um provedor de LLM é opcional e adiciona consolidação mais rica, bootstrap e reranking.
Preciso usar o ai-memory desde o primeiro dia do projeto?
Não. Adicione quando quiser. A primeira sessão em um projeto que ainda não tem memória importa as sessões de agente que já estão na sua máquina, de todos os agentes suportados, até as 25 mais recentes. Roda uma vez só, em background, sem LLM. O ai-memory bootstrap também monta páginas a partir do git log, do README e dos seus docs, e esse precisa de um LLM.
Dá para usar a mesma memória no PC e no notebook?
Sim. Rode um servidor ai-memory em uma máquina do homelab ou em uma das duas máquinas e aponte ambas para ele. Não existe replicação entre servidores. Se o notebook estiver offline, os eventos dos hooks ficam em um spool local e são enviados quando o servidor volta a responder.
A memória nativa do Claude Code é suficiente?
Para um desenvolvedor em uma máquina só, usando apenas o Claude Code, pode ser. Deixa de ser suficiente quando você adiciona um segundo agente, uma segunda máquina ou uma segunda pessoa.
Onde minha memória fica guardada?
Em uma pasta de arquivos markdown puros, versionada em git, dentro do diretório de dados do ai-memory. O SQLite guarda um índice de busca que pode ser reconstruído a partir dos arquivos.
Dê memória aos seus agentes hoje.
Gratuito e open source. Não precisa de conta nem de chave de API, e os arquivos continuam sendo seus.