
솔루션
프로젝트 설명, 이제 그만 반복하세요
에이전트 하나를 닫고 다른 에이전트를 열면, 아키텍처와 실패한 접근, 아직 남은 일을 이미 알고 있습니다. PC에서도 노트북에서도 똑같이 동작하고 API 키는 필요 없습니다.
작업 도중에 에이전트 바꾸기
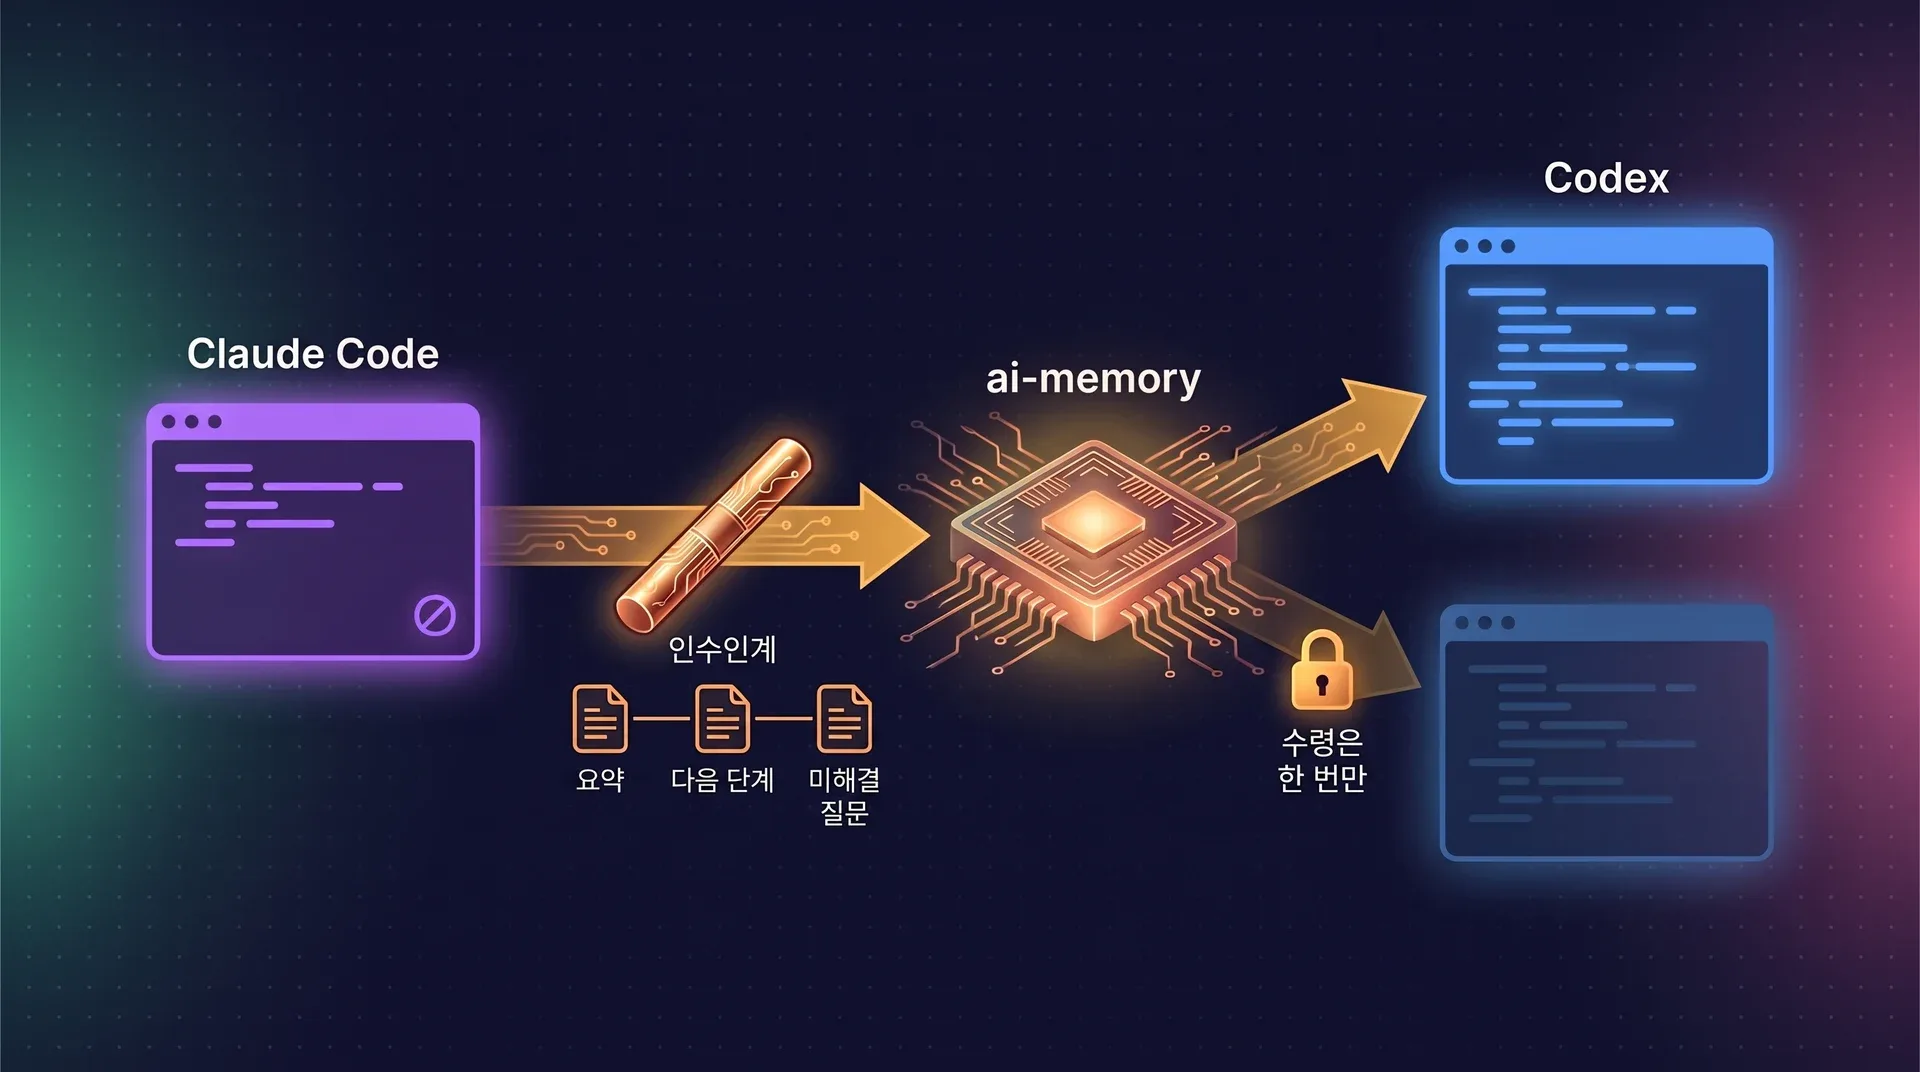
오후 4시에 Claude Code의 속도 제한에 걸렸다면, 같은 디렉터리에서 Codex를 열고 이어서 작업하면 됩니다.
형식이 정해져 있습니다
인수인계(핸드오프)에는 세션 요약, 다음 단계, 미해결 질문이 담깁니다. 다음 에이전트는 세션이 시작될 때, 여러분이 아무것도 입력하기 전에 이를 받습니다.
정확히 한 번만 수령됩니다
그 디렉터리에서 처음 시작한 세션이 바통을 가져갑니다. 두 번째로 요청한 세션은 아무것도 받지 못하므로, 두 에이전트가 같은 작업을 이어받는 일은 없습니다.
자동으로 남고, 직접 남길 수도 있습니다
세션이 끝날 때마다 인수인계가 하나씩 기록됩니다. "다음 세션을 위해 맥락을 저장해 줘"라고 말하면 직접 작성할 수 있고, 직접 작성한 쪽이 자동 기록보다 우선합니다.
Grok Build CLI와 Zero, 이 두 에이전트는 세션 시작 시 훅이 출력하는 내용을 무시합니다. 인수인계를 받으라고 요청하면 MCP로 가져옵니다. 연동 페이지에 모든 에이전트와 각각의 지원 범위가 정리되어 있습니다.
평소에 하는 말
대부분의 날에는 아무 말도 할 필요가 없습니다. 훅이 세션을 캡처하고, 세션이 끝나면 그 내용이 위키 페이지가 됩니다. 필요한 것이 있을 때는 평소 쓰는 말로 요청하면 됩니다.
- "어디까지 했었지?"
- 대기 중인 인수인계를 읽습니다. 요약, 다음 단계, 미해결 질문이 나옵니다.
- "X에 대해 논의한 적 있어?"
- 전문 검색, 엔티티, 링크, 벡터를 하나의 랭킹으로 융합해 위키를 검색합니다.
- "그동안 있었던 일 알려 줘. 한동안 자리를 비웠어."
- 자리를 비운 기간이 길수록 더 길어지는 다이제스트를 만듭니다. LLM이 설정되어 있으면 문장으로, 없으면 구조화된 데이터로 나옵니다.
- "이건 영구적으로 기억해 줘."
- git으로 버전 관리되는 영속 페이지를 작성합니다. 고정(pin)하면 절대 감쇠하지 않습니다.
- "이건 금요일까지만 기억해 줘."
- 만료일이 있는 페이지를 작성합니다. 만료일이 지나면 망각 스윕이 삭제합니다.
- "그 페이지는 오래된 내용이야."
- 이후 랭킹에서 해당 페이지를 낮추는 피드백을 기록합니다. 피드백으로 무언가가 삭제되는 일은 없습니다.
GitHub의 사용 가이드에 전체 문구 목록과 각 문구 뒤에서 동작하는 MCP 도구가 나와 있습니다.
런처 하나, 그리고 기존 프로젝트를 위한 진입로
ai-memory run으로 에이전트 시작하기
- 처음 실행할 때 해당 에이전트의 훅과 MCP 항목이 없으면 설치합니다. 에이전트마다 한 번만 합니다.
- 에이전트를 바꾸면 같은 워크스트림이 이어지고, 요약 인수인계에 더해 화면에 보였던 히스토리까지 함께 넘어옵니다.
ai-memory continue는 어느 디렉터리에서 실행하든 가장 최근 체크아웃을 찾아 그곳에서 작업을 이어갑니다.- 현재 12개 에이전트를 지원합니다. 에이전트를 직접 실행하는 방식도 그대로 동작하며, 훅만으로도 인수인계는 전달됩니다.
cd /path/to/project
ai-memory run claude

# Claude Code를 종료하고, 같은 워크스트림을 Codex에서 이어갑니다.
ai-memory run codex --yolo

# 어느 디렉터리에서든: 하던 곳으로 돌아가기.
ai-memory continue
기존 프로젝트에 도입하기
빈 프로젝트의 첫 세션은 로컬 에이전트 히스토리를 한 번 가져옵니다. 최신 세션 25개까지만 가져옵니다. 직접 실행할 수도 있습니다.
# 무엇을 가져올지 먼저 확인한 다음 가져옵니다
ai-memory backfill --dry-run
ai-memory backfill
첫 실행 시 자동 가져오기를 끄려면 AI_MEMORY_BACKFILL_ON_START=false를 설정합니다.
# 서버에 LLM 제공자가 필요합니다
ai-memory bootstrap --dry-run
ai-memory bootstrap
부트스트랩은 git 로그, README, docs/, 규칙 파일을 읽습니다. 프로젝트가 OpenRouter를 통해 Kimi 2.6으로 측정한 1회 실행 비용은 $0.20에 한참 못 미쳤습니다. 그럴듯하게 들리지만 틀린 페이지를 쓸 수 있으니, 먼저 드라이 런 결과를 읽어 보세요.
PC와 노트북에서 같은 기억을
작은 서버 하나를 띄우고 모든 컴퓨터가 그 서버를 바라보게 합니다. 프로젝트는 체크아웃 이름으로 식별되므로, 컴퓨터마다 경로가 달라도 같은 기억으로 모입니다.
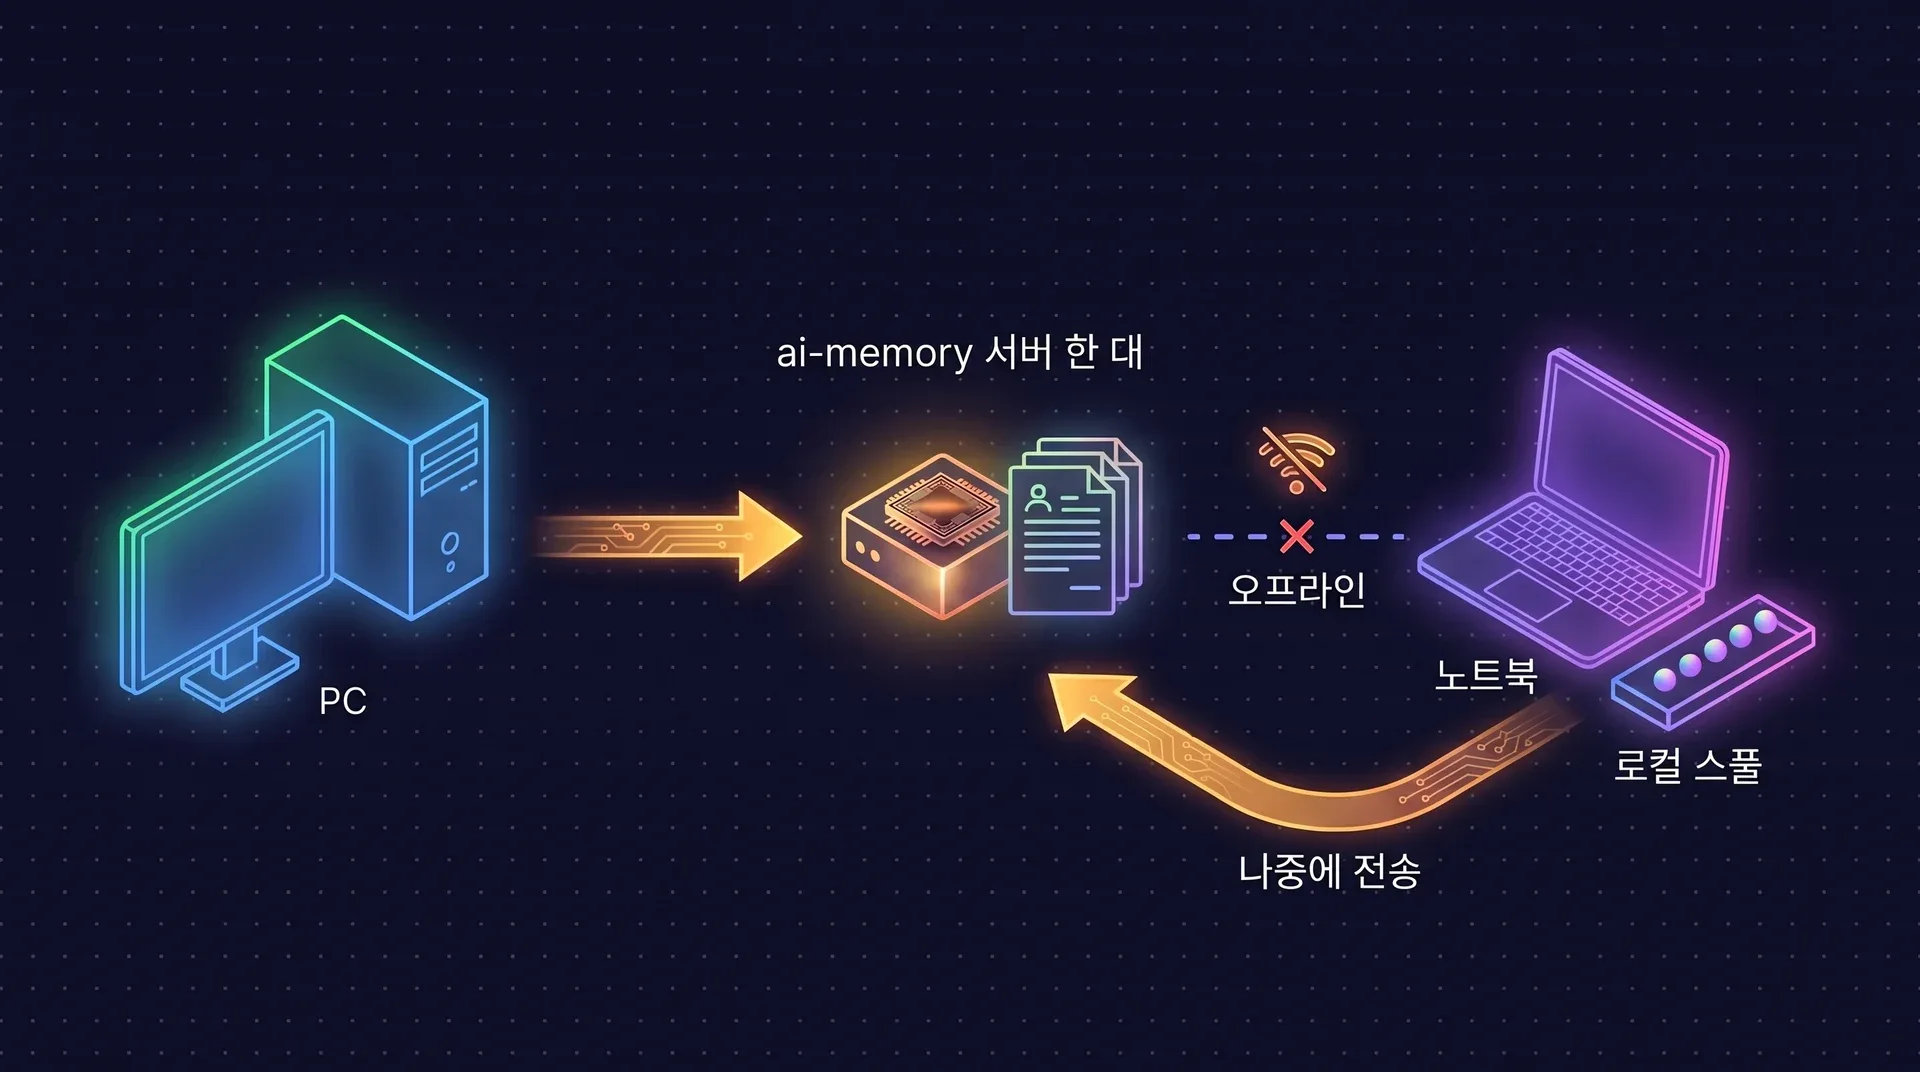
- 서버는 홈랩 서버나 항상 켜져 있는 컴퓨터에 두면 됩니다. 단일 바이너리 또는 컨테이너 하나입니다.
- 노트북이 오프라인이면 훅 이벤트는 로컬 스풀에 쌓였다가 서버에 다시 연결되면 전송됩니다. 항목마다 멱등성 키가 있어서 같은 내용이 두 번 저장되지 않습니다.
ai-memory status는 대기 중인 이벤트 수와 가장 오래된 이벤트가 얼마나 됐는지 보여줍니다.- 루프백 밖에서 수신하는 서버에는 Bearer 토큰이 필수입니다. 토큰은 트래픽을 암호화하지 않으므로, LAN 밖으로 나가기 전에 TLS를 추가하세요.
# PC와 노트북 양쪽에서
export AI_MEMORY_SERVER_URL="http://<server-ip>:49374"
export AI_MEMORY_AUTH_TOKEN="$TOKEN"
ai-memory install-mcp   --client claude-code --apply
ai-memory install-hooks --agent  claude-code --apply
API 키는 필요 없고, 파일은 직접 읽을 수 있습니다
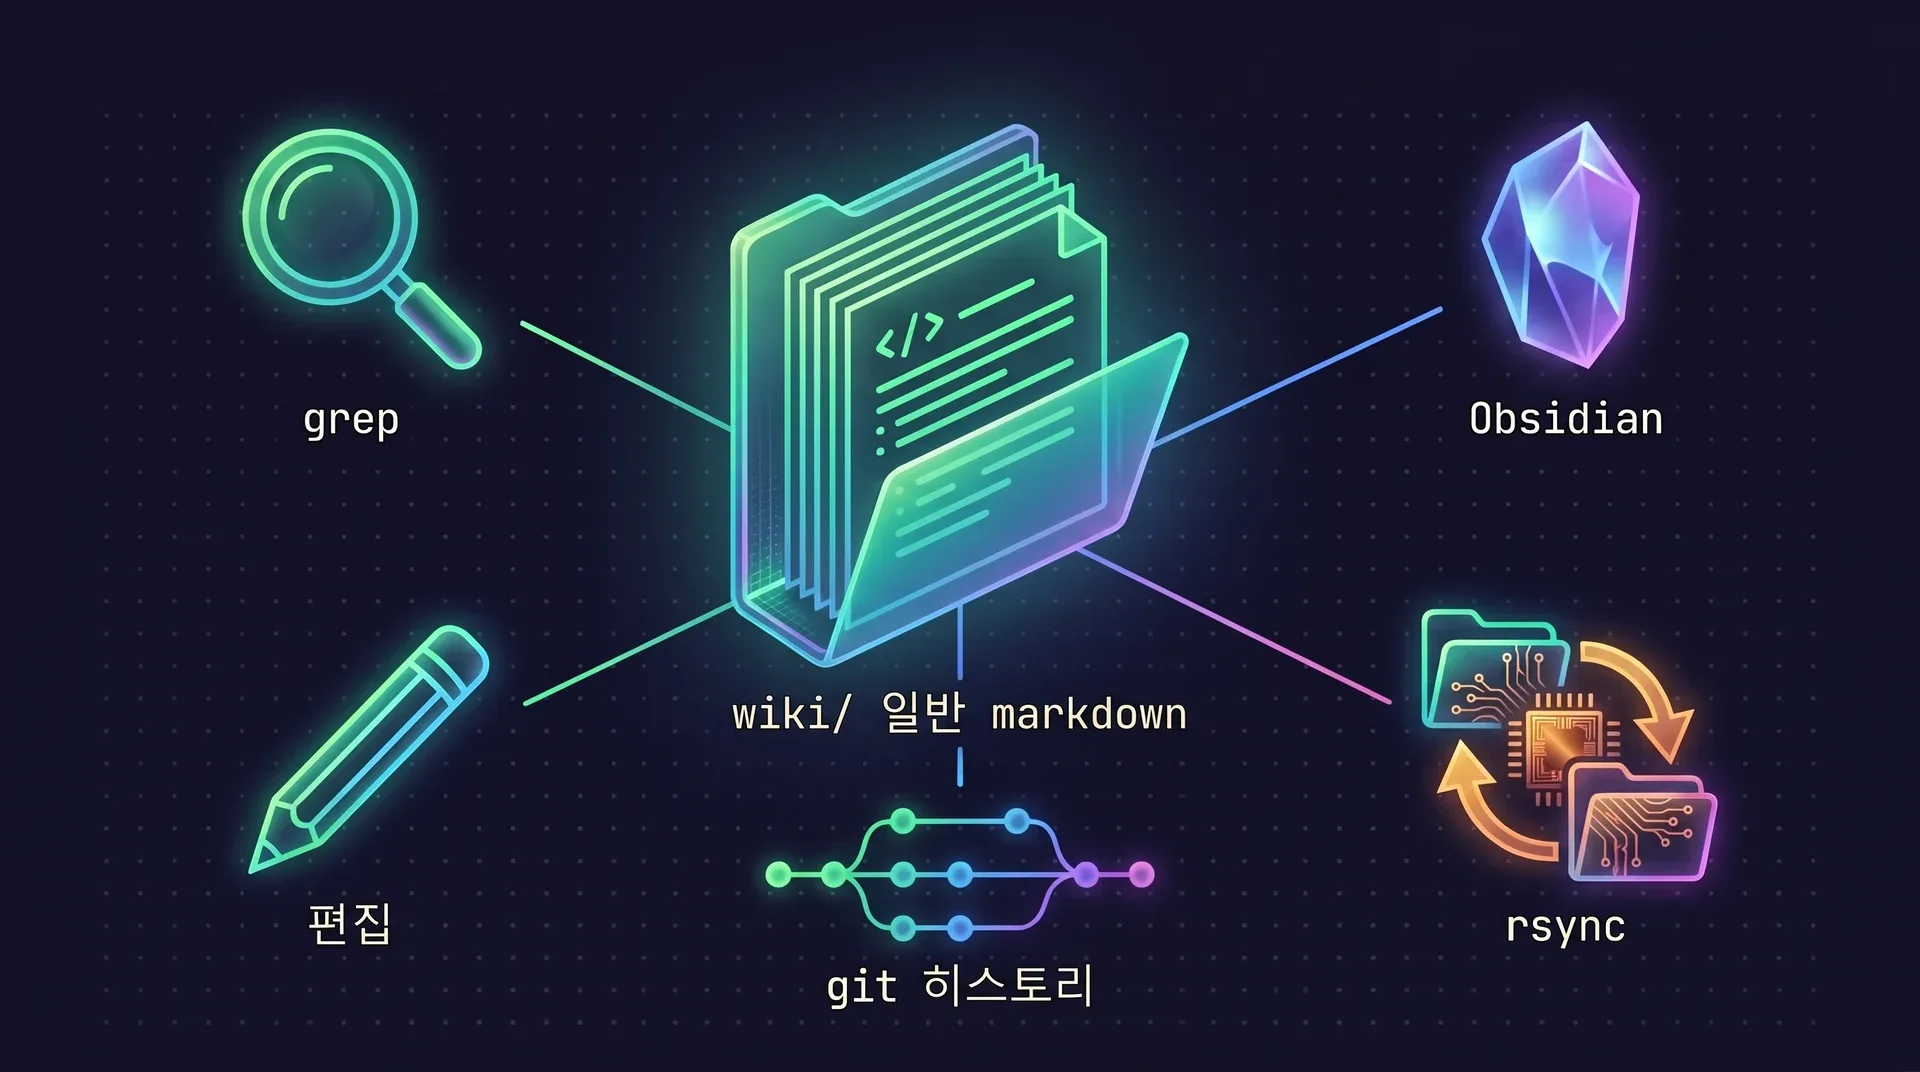
기본 설치는 운영 비용이 들지 않고, 모든 것을 git 저장소 안의 markdown으로 저장합니다.
LLM 호출 0회
캡처, 세션 요약, 인수인계, 검색이 모두 모델 없이 동작합니다. 제공자를 추가하기 전까지 요약은 규칙 기반입니다.
임베딩은 바이너리 안에서 실행됩니다
작은 로컬 모델(all-MiniLM-L6-v2, 약 87 MB)을 백그라운드에서 한 번 내려받습니다. 벡터 검색은 다음 재시작부터 켜집니다. 키도 GPU도 필요 없습니다.
루프백 전용
기본 서버는 127.0.0.1:49374에서 수신하며 계정도 텔레메트리도 없습니다. 네트워크의 다른 어떤 것도 접근할 수 없습니다.
파일은 어디로든 가져갈 수 있습니다
SQLite 인덱스는 파일에서 파생되며 파일로부터 다시 만들 수 있습니다. 백업은 ai-memory backup, rsync, 또는 직접 운영하는 리모트로의 git push로 하면 됩니다.
# 컨테이너에서 위키를 복사해 Obsidian으로 엽니다
docker cp ai-memory:/data/wiki ./my-ai-memory-wiki

# 또는 히스토리를 읽습니다
git -C /data/wiki log --oneline
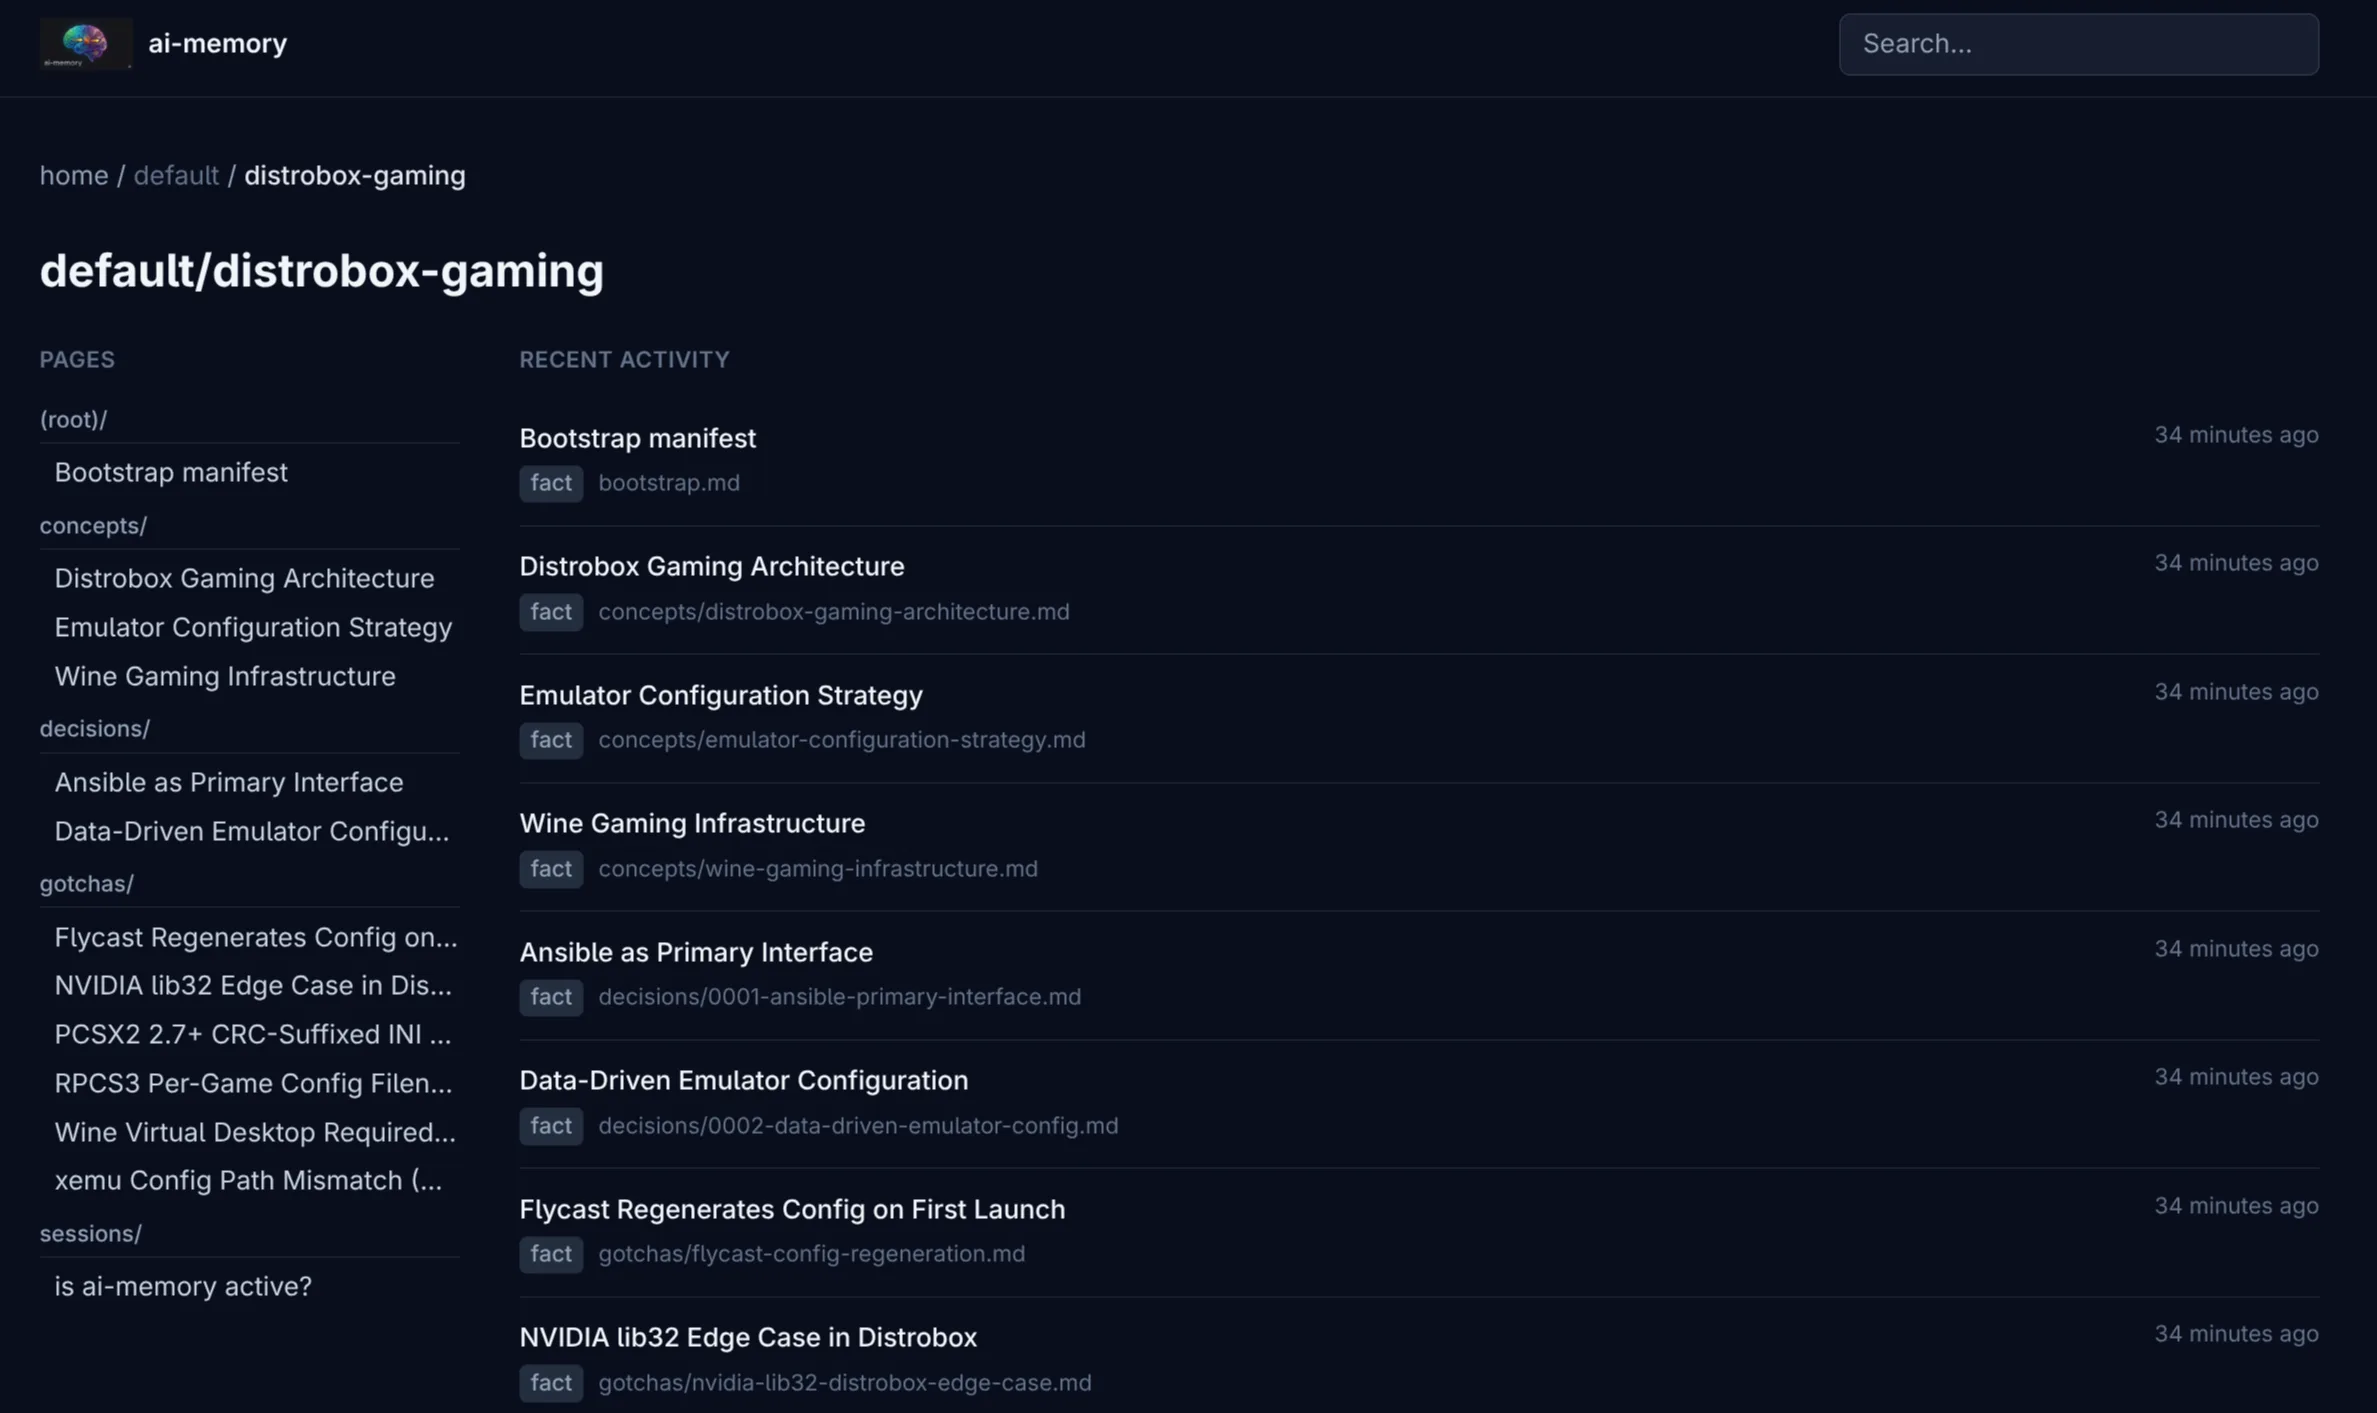
읽기 전용 웹 UI로 둘러볼 수도 있습니다
플래그 하나로 프로젝트 목록, 페이지 트리, 렌더링된 markdown, 검색, 클릭 가능한 위키 링크를 갖춘 브라우저 화면이 추가됩니다. 편집은 전혀 할 수 없습니다.
ai-memory serve --transport http --bind 127.0.0.1:49374 --enable-web
# 그다음 http://127.0.0.1:49374/web 열기
나에게 필요할까?
자주 묻는 질문
ai-memory를 쓰려면 API 키나 LLM이 필요한가요?
아니요. 캡처, 세션 요약, 인수인계, 검색은 LLM 호출 없이 동작합니다. 벡터 검색용 임베딩은 로컬 모델로 프로세스 안에서 실행됩니다. LLM 제공자는 선택 사항이며, 추가하면 더 풍부한 통합, 부트스트랩, 리랭킹을 쓸 수 있습니다.
프로젝트 첫날부터 ai-memory를 써야 하나요?
아니요. 언제든 추가하면 됩니다. 아직 기억이 없는 프로젝트의 첫 세션은 내 컴퓨터에 이미 있는 에이전트 세션을, 지원하는 모든 에이전트에서, 최신 25개까지 가져옵니다. LLM 없이 백그라운드에서 한 번만 실행됩니다. ai-memory bootstrap으로 git 로그, README, 문서에서 페이지를 만들 수도 있는데, 이쪽은 LLM이 필요합니다.
PC와 노트북에서 같은 기억을 쓸 수 있나요?
네. 홈랩 서버나 두 컴퓨터 중 한 대에 ai-memory 서버를 하나 띄우고 양쪽 모두 그 서버에 연결하면 됩니다. 서버 간 복제는 없습니다. 노트북이 오프라인이면 훅 이벤트는 로컬 스풀에 쌓였다가 서버에 다시 연결되면 전송됩니다.
Claude Code의 내장 메모리로 충분한가요?
컴퓨터 한 대에서 Claude Code만 쓰는 개발자 한 명이라면 충분할 수 있습니다. 두 번째 에이전트, 두 번째 컴퓨터, 두 번째 사람이 생기면 부족해집니다.
제 기억은 어디에 저장되나요?
ai-memory 데이터 디렉터리 안에, git으로 버전 관리되는 일반 markdown 파일 폴더로 저장됩니다. SQLite에는 파일로부터 다시 만들 수 있는 검색 인덱스가 들어 있습니다.